KI für EinsteigerAnleitung
Kann ein 125B-Modell auf einer 16-GB-GPU laufen? Die Speicherrechnung
Wie viel Speicher ein offenes 125B-Modell braucht: Gewichte, Quantisierung und KV-Cache in ein paar Zeilen Rechnung, und wann eine API der einfachere Weg ist, es zu nutzen.
Auf dieser Seite
Kurze Antwort: nein. Ein Modell mit 125 Mrd. Parametern benötigt selbst nach 4-Bit-Kompression etwa 62,5 GB für seine Gewichte, und eine 16-GB-Grafikkarte fasst davon etwa ein Viertel. Du kannst es trotzdem starten, indem du den Rest in den System-RAM oder auf die Festplatte auslagerst, aber dann entscheidet die Karte nicht mehr darüber, wie es läuft.
Unten: wie du diese Zahl selbst in ein paar Zeilen ermittelst, was „122B-A10B“ in einem Modellnamen wirklich aussagt und wann das Senden von Anfragen an eine API der einfachere Weg ist, ein großes Modell zu nutzen.
Gewichte: Parameter mal Bytes#
Stell dir ein Modell als riesigen Haufen Zahlen vor, genannt Gewichte oder Parameter. Um dir zu antworten, braucht der Computer sie alle gleichzeitig im schnellen Speicher. Die erste Schätzung ist also einfache Multiplikation: Parameter in Milliarden × Bytes pro Gewicht = Gigabyte. Ein Gewicht belegt 2 Bytes bei 16 Bit, 1 Byte bei 8 Bit und 0,5 Byte bei 4 Bit. Das ist alles, was Quantisierung tut: weniger Bits pro Zahl.
Nimm ein Modell dieser Klasse, Qwen3.5-122B-A10B. Seine Hugging-Face-Seite (geprüft am 30. Oktober 2026) nennt Apache-2.0 als Lizenz, veröffentlicht die Gewichte als BF16 und F32 und gibt die Größe mit 125 Mrd. Parametern an. Für 125 Mrd.:
- Bei 16 Bit: 125 × 2 = 250 GB
- Bei 8 Bit: 125 × 1 = 125 GB
- Bei 4 Bit: 125 × 0,5 = 62,5 GB
- Bei 2 Bit: 125 × 0,25 = 31,25 GB
Selbst die 2-Bit-Zeile ist fast doppelt so groß wie die Karte. Und das sind Untergrenzen, keine Gesamtwerte: Sie lassen den Kontext-Cache (nächste Abschnitte) und den eigenen Overhead der Laufzeitumgebung weg, und echte quantisierte Formate legen noch ein wenig obendrauf.
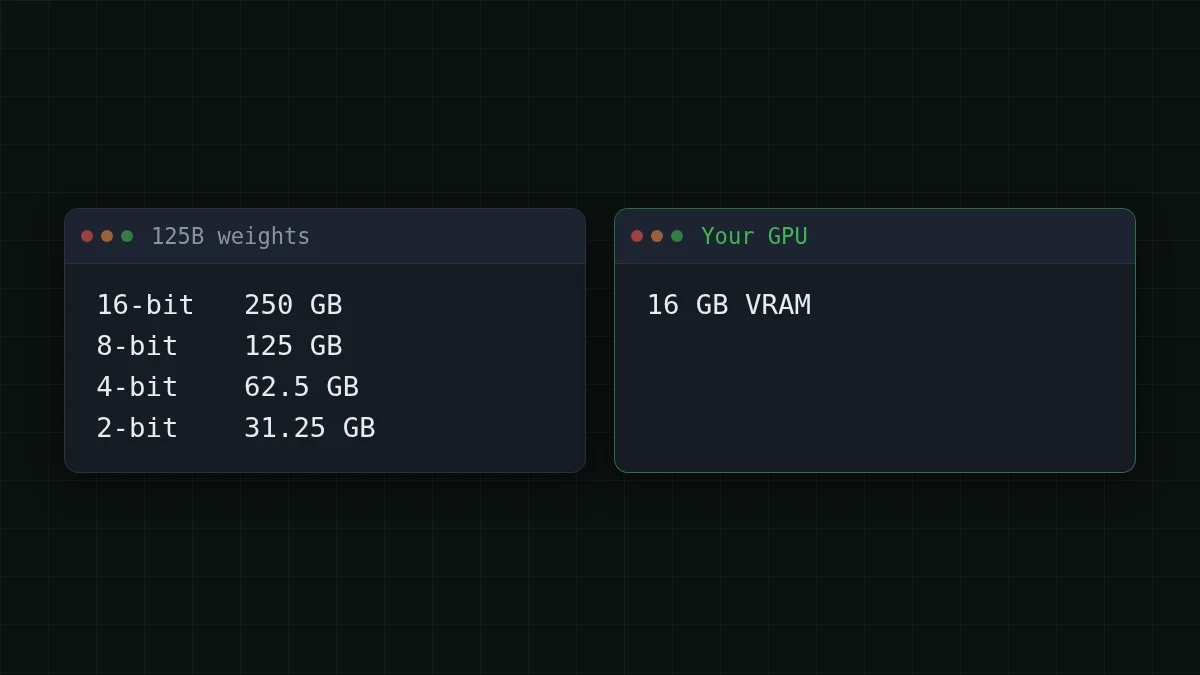
Dreh die Formel um, um zu sehen, was eine 16-GB-Karte fassen kann. Bei 4 Bit sind das 16 / 0,5 = 32 Mrd. Parameter, und das ist die Obergrenze, bevor irgendetwas anderes Platz braucht. Probier die Rechnung selbst:
Zahl erraten
Wie viele GB nehmen die Gewichte eines 32B-Modells bei 4 Bit ein?
Deine Schätzung
0100
Antwort anzeigen
Antwort: 16
32 × 0,5 = 16 GB. Die Karte ist voll, bevor das Modell auch nur ein einziges Wort deiner Frage gelesen hat, also ist 32B die Obergrenze für eine 16-GB-Karte, und komfortable Größen liegen darunter.
„122B-A10B“: welche Zahl zählt#
Der Name enthält zwei Zahlen. Laut Model Card hat das Modell insgesamt 122 Mrd. Parameter und 10 Mrd. aktive pro Token. Es ist ein Mixture-of-Experts-Modell: Im Inneren stecken viele kleine spezialisierte Teilnetze, und für jeden Token weckt ein Router nur wenige davon.
Stell dir eine Bibliothek mit 122 Regalen vor, bei der dich jede einzelne Frage zu 10 davon schickt. Dein Leseaufwand ist gering, aber die ganze Bibliothek muss trotzdem im Gebäude stehen, denn du kannst nicht wissen, welche Regale das nächste Wort brauchen wird.
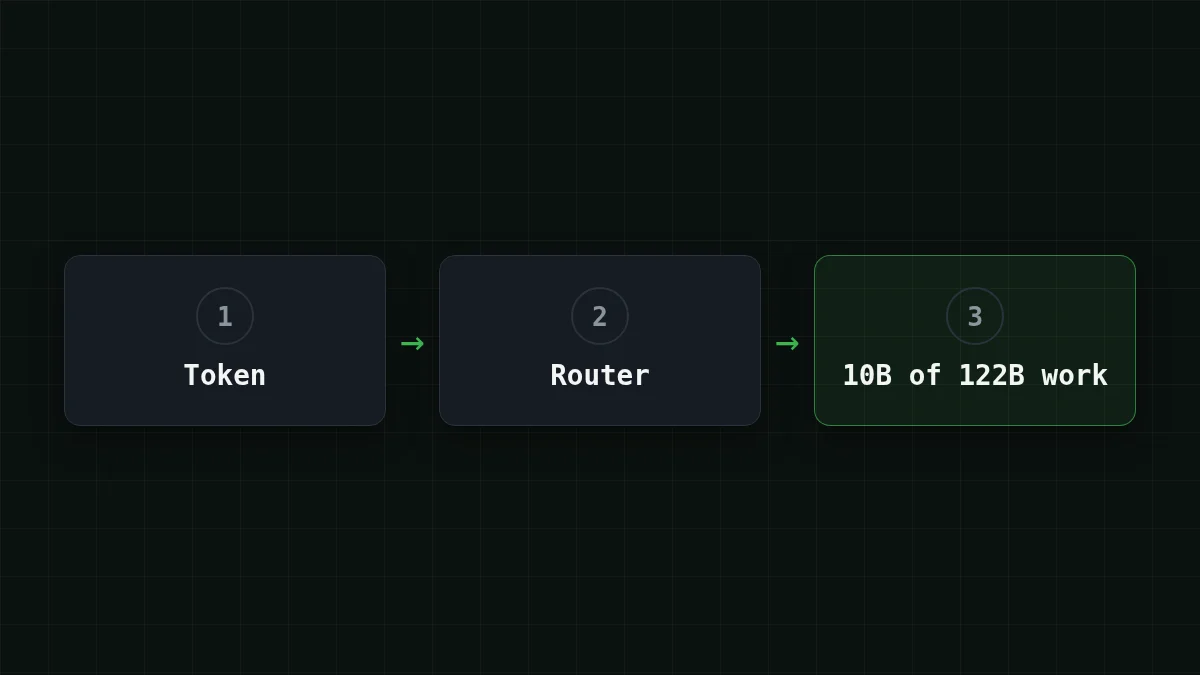
Also: Speicher folgt der Gesamtzahl, Rechenaufwand folgt den aktiven. Zehn Milliarden aktive Parameter machen einen Token günstig zu berechnen, nicht günstig zu speichern. Wie schnell ein Setup läuft, das einen Teil der Experten im RAM oder auf der Festplatte hält, hängt von deinem RAM, deiner Festplatte und deiner Software ab. Es gibt keine ehrliche einzelne Zahl, also sei vorsichtig bei jeder Schlagzeile, die eine nennt.
Kurzer Check
Ein Modell heißt 122B-A10B. Welche Zahl bestimmt grob, wie viel Speicher seine Gewichte brauchen?
Antwort anzeigen
Antwort: Die 122B Gesamtparameter
Alle Experten müssen gespeichert werden, denn der Router kann für den nächsten Token jeden von ihnen auswählen. Die 10B sagen dir nur, wie viel Arbeit ein Token macht.
Die zweite Rechnung: der Kontext-Cache#
Die Gewichte sind der feste Teil. Der andere Teil wächst, während du chattest. Um nicht für jeden neuen Token die ganze Unterhaltung neu zu lesen, legt sich das Modell Notizen zu jedem Token an, das es bereits gesehen hat: den KV-Cache (Keys und Values). Längerer Kontext, größerer Cache. Wenn du die Kontextseite von Grund auf erklärt haben möchtest, gibt es einen separaten Leitfaden zum Kontextfenster.
Pro Token belegt der Cache: 2 × Layer × KV-Heads × Head-Größe × Bytes. Sagen wir, ein Modell hat 48 Layer, 8 KV-Heads, eine Head-Größe von 128 und einen 16-Bit-Cache (eine angenommene Form, nicht die aus einer Model Card):
- ein Token: 2 × 48 × 8 × 128 × 2 = 196608 Bytes, etwa 0,2 MB
- 32.768 Tokens: 196608 × 32768 = 6442450944 Bytes, etwa 6,4 GB
- 131.072 Tokens (128K): 196608 × 131072 = 25769803776 Bytes, etwa 25,8 GB
Bei 128K ist dieser Cache allein größer als die ganze Karte. Deine echten Zahlen stehen in der config.json des Modells (Layer, KV-Heads, Head-Größe), und manche Architekturen halten den Cache viel kleiner, also behandle das als Methode, nicht als Urteil über ein bestimmtes Modell.
Die Model Card von Qwen3.5-122B-A10B zeigt, wie das große Ende aussieht: Ihre Serving-Beispiele nutzen Tensor-Parallelität über 8 GPUs beim vollen Kontext von 262.144 Tokens. Wenn der Speicher ausgeht, rät sie, den Kontext zu verkürzen und dabei mindestens 128K beizubehalten, um das Denken zu erhalten, und das vLLM-Flag - überspringt den Vision-Encoder, um Speicher für den Cache freizugeben.
Deine eigene Schätzung in einem Dutzend Zeilen#
Setz beide Teile zusammen:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9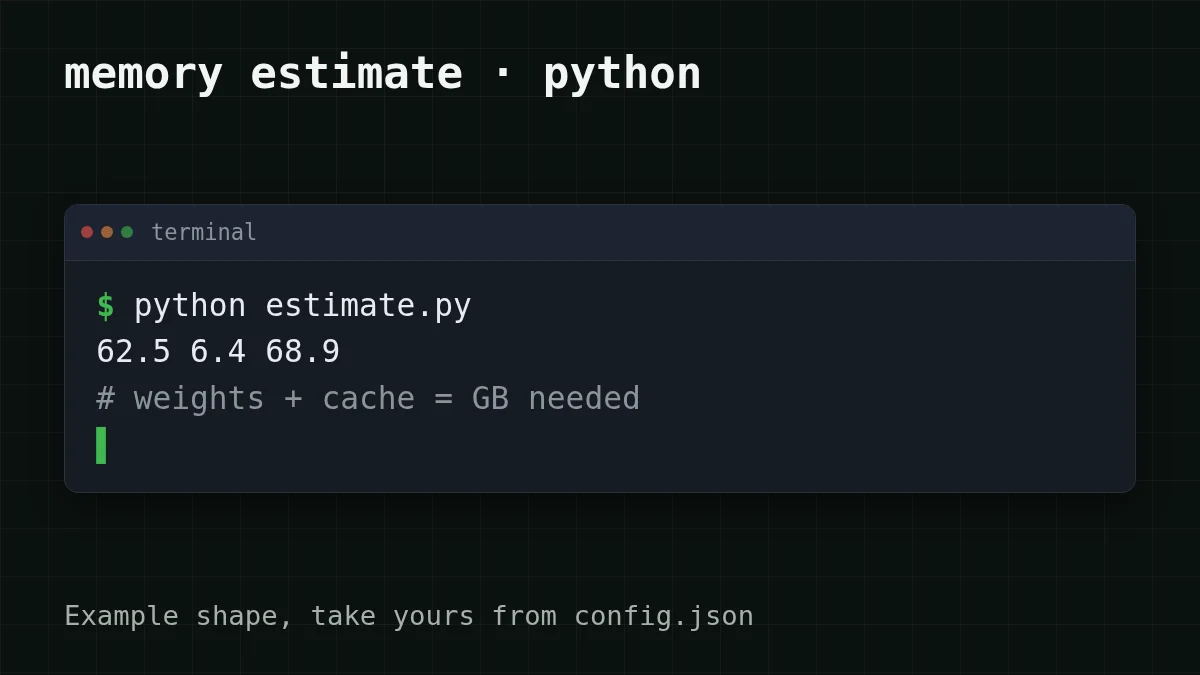
Jetzt der Realitätscheck. Sagen wir, dein PC hat 32 GB RAM neben der 16-GB-Karte: 16 + 32 = 48 GB, immer noch unter den 68,9 GB, die das Skript ausgegeben hat. Das Offloading müsste auch noch auf die Festplatte zurückgreifen, und du würdest ein großes Modell größtenteils aus dem Speicher statt aus der Karte laufen lassen.
Wann eine API die einfachere Wahl ist#
Nicht jede Aufgabe braucht ein großes Modell auf deinem Schreibtisch. Was beschreibt dich?
Wähle deinen Fall
Was kommt deinem Fall am nächsten?
Wähle eine Option, um die Antwort zu sehen
Ich möchte sehen, wie ein Modell auf meiner eigenen Maschine läuft
Nimm ein kleines: Bei 4 Bit braucht ein 7B-Modell etwa 7 × 0,5 = 3,5 GB für die Gewichte, passt also auf eine 16-GB-Karte mit Platz für einen langen Chat. Zu lernen, wie Modelle sich verhalten, ist der beste Grund, lokal zu laufen. Siehe auch lokal oder API für DeepSeek.
Ein paar tausend Anfragen im Monat, und ich möchte ein starkes Modell
Schick sie an eine API. Du sparst dir den Kauf oder die Miete von Speicher, es gibt nichts zu installieren, und die Rechnung umfasst nur die Tokens, die du tatsächlich nutzt.
Lange Dokumente oder ein Agent, der eine lange Historie behält
Der Cache ist der Teil, der wächst, und auf deiner eigenen Hardware konkurriert er mit den Gewichten um denselben Speicher. Bei einer API ist das Kontextfenster jemand anderes Problem: DeepSeek-V4-Flash und GLM-5.3-Flash auf CheapTokens fassen 380K bzw. 390K Tokens.
Wie das in der Praxis aussieht. Sagen wir, ein Support-Bot fasst 3.000 Tickets im Monat zusammen, jedes etwa 2.000 Tokens Input und 400 Tokens Output. Über den Monat sind das 2000 × 3000 = 6000000 Input-Tokens und 400 × 3000 = 1200000 Output-Tokens. Bei DeepSeek-V4-Flash kostet Input $0.015 und Output $0.10 pro 1M Tokens, also kommt der ganze Monat auf $0.21. Die Tabelle unten zeigt dieselbe Last auf jedem Modell, mit der OpenRouter-Spalte daneben, damit du in Summe, Input und Output zusammen vergleichen kannst:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 3.000 Anfragen | OpenRouter, 3.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2.000 Input- und 400 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Anfrage selbst ist derselbe Aufruf im OpenAI-Stil, den du bei jedem Anbieter machen würdest. Die Basis-URL ist https:/, und die Modell-ID ist die vollständige deepseek-:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
Die Antwort enthält einen usage-Block mit den Input- und Output-Token-Zahlen, sodass du die Schätzung oben nach dem ersten Dutzend mit deinen eigenen Tickets abgleichen kannst. DeepSeek-V4-Flash gibt dir bis zu 32.768 Output-Tokens pro Antwort zu einem Preis rund um die Uhr, und GLM-5.3-Flash ist die leichtere Alltagsoption mit bis zu 8.192. Einrichtungsdetails stehen in der Dokumentation, die Modellseite ist günstiges DeepSeek, und die vollständige Preisliste findest du auf der Preisseite.
Wenn das nächste Mal ein Modellname mit einer Größe kommt, hast du jetzt die drei Schritte: multiplizieren, den Cache addieren, mit der Karte vergleichen.


