AI 입문가이드
125B 모델이 16 GB GPU에서 돌아갈까? 메모리 계산
125B 오픈 모델에 필요한 메모리: 가중치, 양자화, KV 캐시를 몇 줄의 계산으로 확인하고, API가 더 간단한 선택인 경우를 알아본다.
짧은 답: 아니다. 125B 파라미터 모델은 4비트 압축 후에도 가중치만 약 62.5 GB가 필요하고, 16 GB 그래픽 카드는 그 4분의 1 정도만 담을 수 있다. 나머지를 시스템 RAM이나 디스크로 밀어내면 실행은 가능하지만, 그때는 카드가 성능을 좌우하지 않는다.
아래에서는 이 숫자를 몇 줄로 직접 구하는 방법, 모델 이름의 “122B-A10B”가 실제로 무엇을 말하는지, 그리고 큰 모델을 쓸 때 API로 요청을 보내는 것이 더 간단한 경우를 다룬다.
가중치: 파라미터 × 바이트#
모델을 가중치 또는 파라미터라 불리는 거대한 숫자 더미라고 생각하자. 답을 내려면 컴퓨터가 이 숫자 전부를 빠른 메모리에 한 번에 올려야 한다. 그래서 첫 추정은 단순한 곱셈이다: 파라미터 수(십억 단위) × 가중치당 바이트 = 기가바이트. 가중치 하나는 16비트에서 2바이트, 8비트에서 1바이트, 4비트에서 0.5바이트를 차지한다. 양자화가 하는 일이 바로 이것이다: 숫자당 비트를 줄이는 것.
이 등급의 모델인 Qwen3.5-122B-A10B를 보자. Hugging Face 페이지(2026년 10월 30일 확인)는 라이선스로 Apache-2.0을 명시하고, 가중치를 BF16과 F32로 공개하며, 크기를 125B 파라미터로 표기한다. 125B 기준:
- 16비트: 125 × 2 = 250 GB
- 8비트: 125 × 1 = 125 GB
- 4비트: 125 × 0.5 = 62.5 GB
- 2비트: 125 × 0.25 = 31.25 GB
2비트 줄조차 카드의 거의 두 배다. 그리고 이는 총합이 아니라 최소값이다: 컨텍스트 캐시(다음 절)와 런타임 자체의 오버헤드를 빼고 계산했으며, 실제 양자화 포맷은 여기에 조금 더 얹힌다.
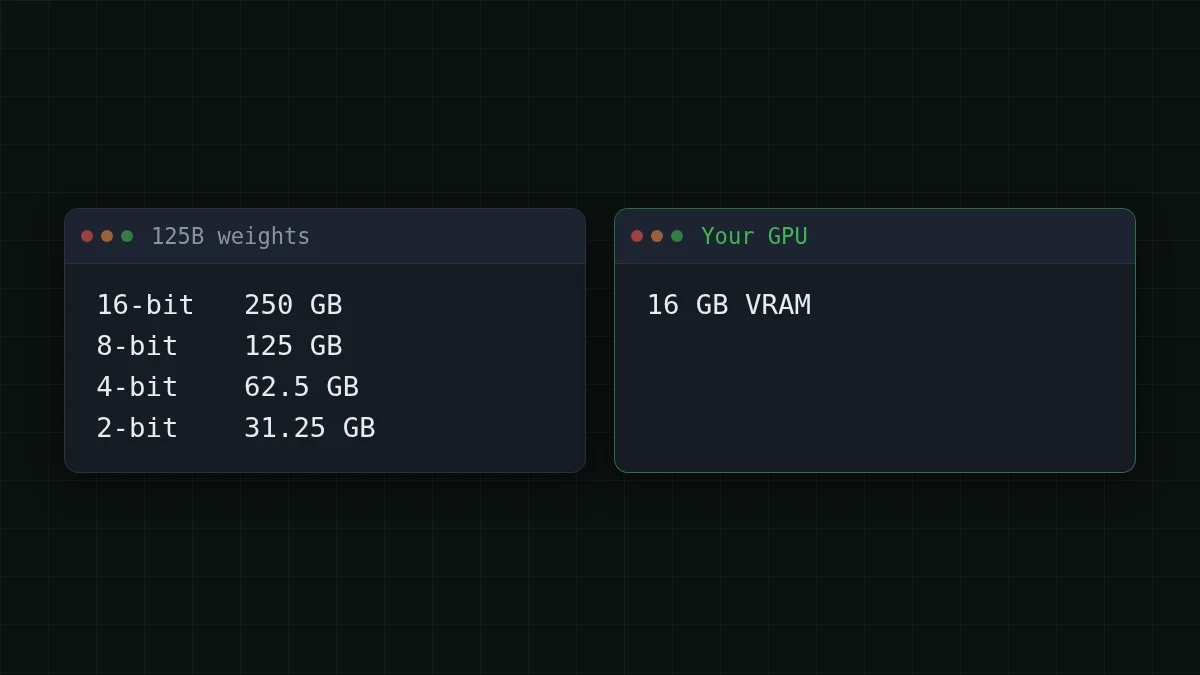
공식을 뒤집으면 16 GB 카드가 무엇을 담을 수 있는지 보인다. 4비트에서 16 / 0.5 = 320억 파라미터이고, 이는 다른 무엇이 자리를 차지하기 전의 상한이다. 직접 계산해 보자:
숫자 맞히기
32B 모델의 가중치는 4비트에서 몇 GB를 차지할까?
내 추측
0100
정답 보기
정답: 16
32 × 0.5 = 16 GB. 모델이 질문의 단어 하나를 읽기도 전에 카드가 꽉 찬다. 따라서 16 GB 카드의 상한은 32B이고, 편안한 크기는 그보다 낮다.
“122B-A10B”: 어느 숫자가 기준인가#
이 이름에는 두 숫자가 들어 있다. 모델 카드에 따르면 이 모델은 총 122B 파라미터이고 토큰마다 10B가 활성화된다. 전문가 혼합(mixture-of-experts) 모델로, 내부에 여러 작은 전문가 서브네트워크가 있고 토큰마다 라우터가 그중 몇 개만 깨운다.
122개의 선반이 있는 도서관에서 어떤 질문이든 10개의 선반으로 안내하는 상황을 생각하자. 읽는 수고는 적지만, 다음 단어에 어느 선반이 필요할지 알 수 없으므로 도서관 전체가 건물 안에 있어야 한다.
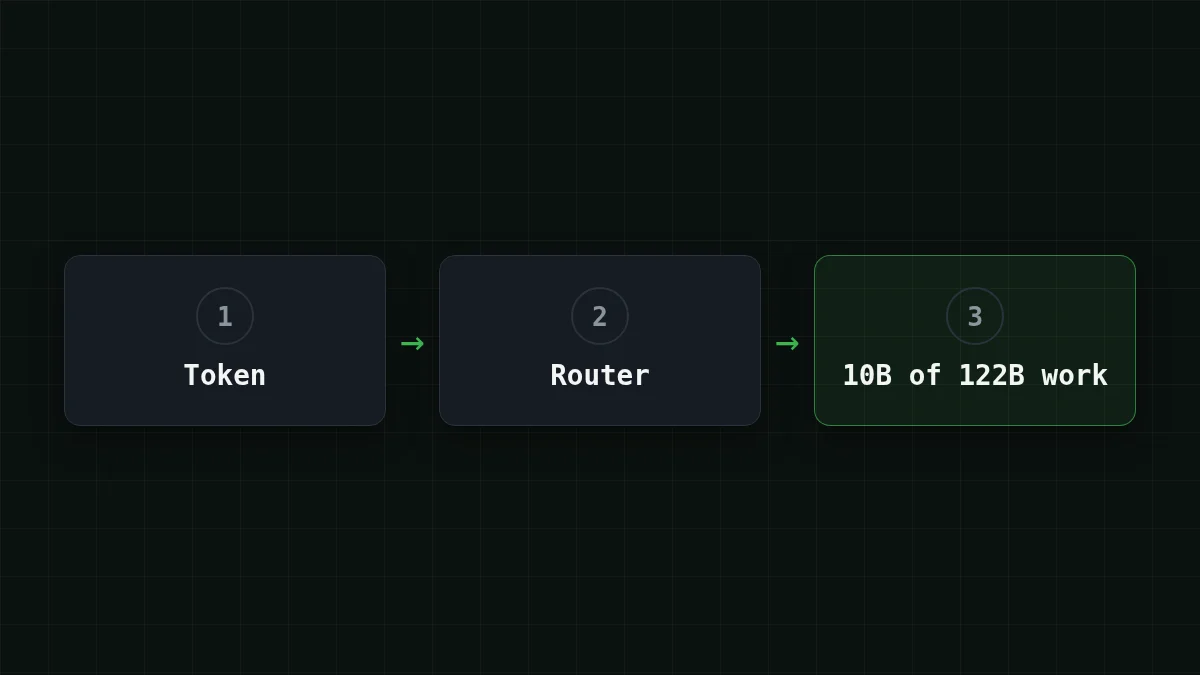
즉: 메모리는 전체를 따르고, 연산은 활성을 따른다. 활성 파라미터 100억 개는 토큰 연산을 저렴하게 만들 뿐, 저장을 저렴하게 만들지 않는다. 전문가 일부를 RAM이나 디스크에 두는 구성이 얼마나 빠른지는 RAM, 디스크, 소프트웨어에 달려 있다. 정직한 단일 수치는 없으니, 하나의 수치를 내세우는 헤드라인은 경계하자.
빠른 확인
어떤 모델이 122B-A10B라고 불린다. 가중치 메모리 요구량을 대략 결정하는 숫자는?
정답 보기
정답: 전체 파라미터 122B
라우터가 다음 토큰에 어떤 전문가든 고를 수 있으므로 모든 전문가를 저장해야 한다. 10B는 토큰 하나의 연산량만 알려준다.
두 번째 청구서: 컨텍스트 캐시#
가중치는 고정된 부분이다. 다른 부분은 대화하는 동안 커진다. 새 토큰마다 전체 대화를 다시 읽지 않으려고 모델은 이미 본 각 토큰에 대한 메모를 유지한다: KV 캐시(키와 값). 컨텍스트가 길수록 캐시가 커진다. 컨텍스트 쪽을 처음부터 설명한 내용은 컨텍스트 윈도우 별도 가이드에 있다.
토큰당 캐시는 2 × 레이어 수 × KV 헤드 수 × 헤드 크기 × 바이트를 차지한다. 어떤 모델이 48개 레이어, 8개 KV 헤드, 헤드 크기 128, 16비트 캐시를 가진다고 하자(어떤 모델 카드에서도 가져온 것이 아닌 가정된 형태):
- 토큰 하나: 2 × 48 × 8 × 128 × 2 = 196608바이트, 약 0.2 MB
- 32,768 토큰: 196608 × 32768 = 6442450944바이트, 약 6.4 GB
- 131,072 토큰(128K): 196608 × 131072 = 25769803776바이트, 약 25.8 GB
128K에서는 이 캐시만으로 카드 전체보다 커진다. 실제 숫자는 모델의 config.json(레이어, KV 헤드, 헤드 크기)에 있고, 일부 아키텍처는 캐시를 훨씬 작게 유지하므로 이는 특정 모델에 대한 판정이 아니라 방법으로 받아들이자.
Qwen3.5-122B-A10B 카드는 큰 쪽이 어떤 모습인지 보여준다: 서빙 예시는 최대 262,144 토큰 컨텍스트에서 8개 GPU에 걸친 텐서 병렬 처리를 사용한다. 메모리가 부족하면 사고를 보존하기 위해 최소 128K를 유지하면서 컨텍스트를 줄이라고 권고하며, vLLM 플래그 -는 비전 인코더를 건너뛰어 캐시용 메모리를 확보한다.
십여 줄로 직접 하는 추정#
두 부분을 합치자:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9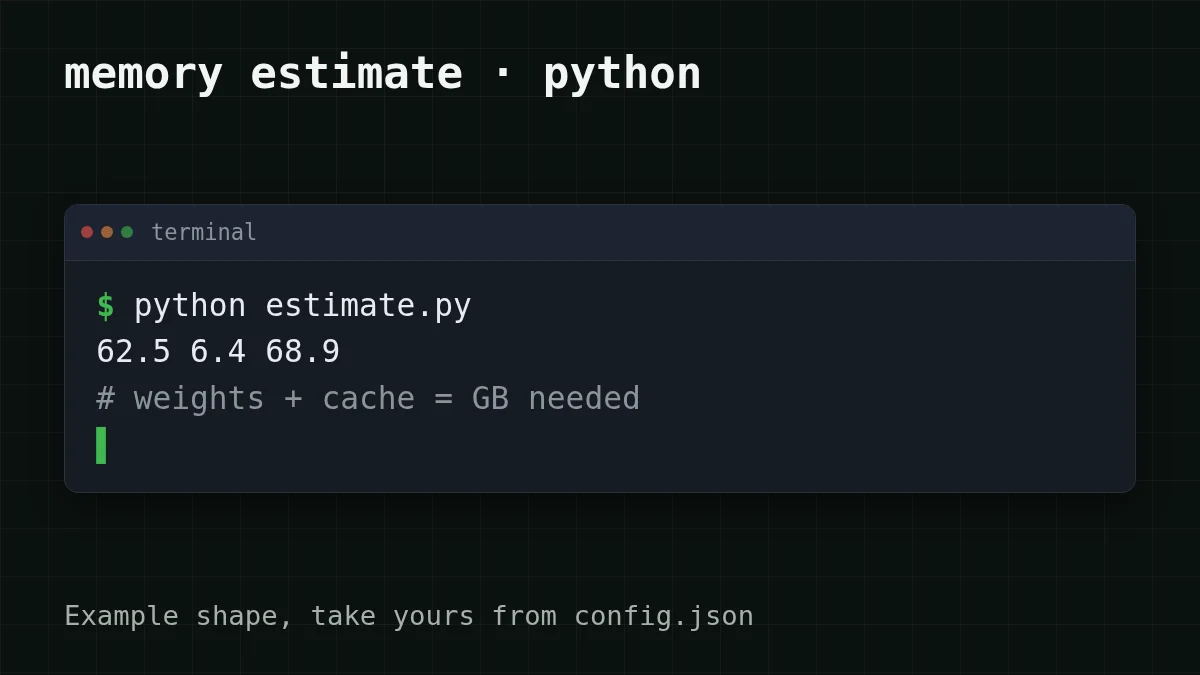
이제 현실 점검. PC에 16 GB 카드 옆에 32 GB RAM이 있다고 하자: 16 + 32 = 48 GB로, 스크립트가 출력한 68.9 GB보다 여전히 낮다. 오프로딩이 디스크까지 닿아야 하고, 큰 모델을 카드가 아니라 대부분 저장장치에서 돌리게 된다.
API가 더 간단한 선택일 때#
모든 작업에 책상 위의 큰 모델이 필요한 것은 아니다. 어느 쪽이 당신의 상황인가?
사례 선택하기
어느 쪽이 당신의 경우에 가장 가까운가?
답을 보려면 옵션을 선택하세요
내 컴퓨터에서 모델이 돌아가는 걸 보고 싶다
작은 것을 고르자: 4비트에서 7B 모델은 가중치로 약 7 × 0.5 = 3.5 GB를 차지하므로, 긴 대화를 위한 여유를 두고 16 GB 카드에 들어간다. 모델이 어떻게 동작하는지 배우는 것이 로컬 실행의 가장 좋은 이유다. DeepSeek의 로컬 vs API도 참고하자.
월 수천 건의 요청, 그리고 강력한 모델을 원한다
API로 보내자. 메모리를 사거나 빌릴 필요가 없고, 설치할 것도 없으며, 청구서는 실제로 사용한 토큰뿐이다.
긴 문서 또는 긴 이력을 유지하는 에이전트
커지는 부분은 캐시이고, 자체 하드웨어에서는 가중치와 같은 메모리를 두고 경쟁한다. API를 쓰면 컨텍스트 윈도우는 남의 문제다: CheapTokens의 DeepSeek-V4-Flash와 GLM-5.3-Flash는 각각 380K와 390K 토큰을 받는다.
실제로는 어떤 모습인가. 지원 봇이 월 3,000건의 티켓을 요약하고, 각 티켓이 입력 약 2,000 토큰, 출력 400 토큰이라고 하자. 한 달 동안 2000 × 3000 = 6000000 입력 토큰과 400 × 3000 = 1200000 출력 토큰이다. DeepSeek-V4-Flash에서 입력은 1M 토큰당 $0.015, 출력은 $0.10이므로 한 달 전체는 $0.21이 된다. 아래 표는 같은 부하를 모든 모델에 적용한 것이며, OpenRouter 열을 나란히 두어 총액, 입력, 출력을 함께 비교할 수 있다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 3,000회 요청 | OpenRouter, 3,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
요청당 입력 2,000개 및 출력 400개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
요청 자체는 어느 제공자에게든 보내는 것과 같은 OpenAI 스타일 호출이다. 기본 URL은 https:/이고 모델 id는 전체 deepseek-이다:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
응답에는 입력 및 출력 토큰 수가 담긴 usage 블록이 있으므로, 처음 십여 건 후에 위 추정치를 자신의 티켓과 대조할 수 있다. DeepSeek-V4-Flash는 24시간 동일 가격으로 답변당 최대 32,768 출력 토큰을 제공하고, GLM-5.3-Flash는 최대 8,192로 더 가벼운 일상 옵션이다. 설정 세부 사항은 문서에, 모델 페이지는 저렴한 DeepSeek에, 전체 가격표는 가격 페이지에 있다.
다음에 모델 이름에 크기가 붙어 나오면 이제 세 단계가 있다: 곱하고, 캐시를 더하고, 카드와 비교하라.


