একটি 125B মডেল কি 16 GB GPU-তে চলতে পারে? মেমরি গণিত
একটি 125B ওপেন মডেলের কত মেমরি প্রয়োজন: ওয়েট, কোয়ান্টাইজেশন এবং KV ক্যাশে কয়েক লাইনের গণিতে, এবং কখন একটি API এটি ব্যবহারের সহজ উপায়।
এই পৃষ্ঠায়
সংক্ষিপ্ত উত্তর: না। একটি 125B-প্যারামিটার মডেলের ওয়েটের জন্য 4-বিট কম্প্রেশনের পরেও প্রায় 62.5 GB প্রয়োজন, এবং একটি 16 GB গ্রাফিক্স কার্ড তার প্রায় এক চতুর্থাংশ ধারণ করে। আপনি এখনও বাকিটা সিস্টেম RAM বা ডিস্কে ঠেলে এটি চালু করতে পারেন, কিন্তু তখন কার্ড আর সিদ্ধান্ত নেয় না যে সবকিছু কীভাবে চলবে।
নিচে: কয়েক লাইনে কীভাবে নিজেই সেই সংখ্যাটি বের করবেন, একটি মডেলের নামে "122B-A10B" আসলে কী বলে, এবং কখন একটি API-তে অনুরোধ পাঠানো একটি বড় মডেল ব্যবহারের সহজ উপায়।
ওয়েট: প্যারামিটার গুণ বাইট#
একটি মডেলকে সংখ্যার বিশাল স্তূপ হিসেবে কল্পনা করুন, যাকে ওয়েট বা প্যারামিটার বলা হয়। আপনাকে উত্তর দিতে, কম্পিউটারের একবারে দ্রুত মেমরিতে সেগুলির সবকটি প্রয়োজন। তাই প্রথম অনুমানটি সরল গুণ: বিলিয়নে প্যারামিটার × প্রতি ওয়েটে বাইট = গিগাবাইট। একটি ওয়েট 16-বিটে 2 বাইট, 8-বিটে 1 বাইট এবং 4-বিটে 0.5 বাইট নেয়। কোয়ান্টাইজেশন ঠিক এটাই করে: প্রতি সংখ্যায় কম বিট।
এই শ্রেণীর একটি মডেল নিন, Qwen3.5-122B-A10B। এর Hugging Face পৃষ্ঠা (30 অক্টোবর 2026-এ যাচাই করা) লাইসেন্স হিসেবে Apache-2.0 উল্লেখ করে, ওয়েটগুলি BF16 এবং F32 হিসেবে প্রকাশ করে, এবং আকার 125B প্যারামিটার হিসেবে তালিকাভুক্ত করে। 125B-এর জন্য:
- 16 বিটে: 125 × 2 = 250 GB
- 8 বিটে: 125 × 1 = 125 GB
- 4 বিটে: 125 × 0.5 = 62.5 GB
- 2 বিটে: 125 × 0.25 = 31.25 GB
এমনকি 2-বিট লাইনটিও কার্ডের প্রায় দ্বিগুণ। এবং এগুলি সর্বনিম্ন সীমা, মোট নয়: এগুলি কনটেক্সট ক্যাশে (পরবর্তী বিভাগগুলি) এবং রানটাইমের নিজস্ব ওভারহেড বাদ দেয়, এবং প্রকৃত কোয়ান্টাইজড ফরম্যাটগুলি উপরে কিছুটা যোগ করে।
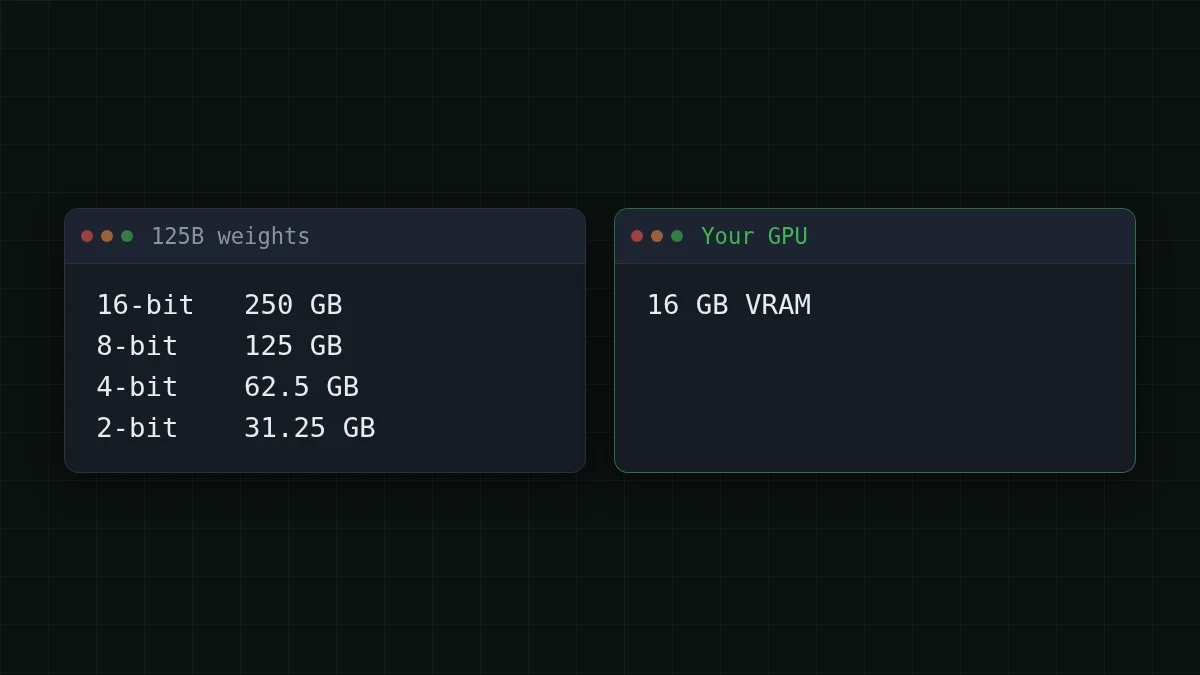
একটি 16 GB কার্ড কী ধারণ করতে পারে তা দেখতে সূত্রটি উল্টান। 4-বিটে তা হল 16 / 0.5 = 32 বিলিয়ন প্যারামিটার, এবং অন্য কিছুর জায়গা প্রয়োজন হওয়ার আগে এটাই সর্বোচ্চ সীমা। নিজেই যোগফলটি চেষ্টা করুন:
সংখ্যা অনুমান করুন
4-বিটে একটি 32B মডেলের ওয়েট কত GB নেয়?
আপনার অনুমান
০১০০
উত্তর দেখান
উত্তর: ১৬
32 × 0.5 = 16 GB। আপনার প্রশ্নের একটি শব্দও মডেল পড়ার আগেই কার্ড পূর্ণ হয়ে যায়, তাই 16 GB কার্ডের জন্য 32B হল ছাদ এবং আরামদায়ক আকারগুলি এর চেয়ে কম।
"122B-A10B": কোন সংখ্যাটি গণনা করে#
নামটিতে দুটি সংখ্যা রয়েছে। মডেল কার্ড অনুসারে, মডেলটিতে মোট 122B প্যারামিটার এবং প্রতিটি টোকেনের জন্য 10B সক্রিয়। এটি একটি মিশ্রণ-বিশেষজ্ঞ মডেল: ভিতরে অনেকগুলি ছোট বিশেষজ্ঞ সাব-নেটওয়ার্ক রয়েছে, এবং প্রতিটি টোকেনের জন্য একটি রাউটার তাদের মধ্যে কয়েকটিকে জাগায়।
122টি তাক সহ একটি লাইব্রেরির কথা ভাবুন যেখানে যেকোনো একক প্রশ্ন আপনাকে তাদের 10টিতে পাঠায়। আপনার পড়ার পরিশ্রম কম, কিন্তু পুরো লাইব্রেরিকে এখনও ভবনের ভিতরে থাকতে হবে, কারণ পরবর্তী শব্দের জন্য কোন তাকগুলির প্রয়োজন হবে তা আপনি জানতে পারবেন না।
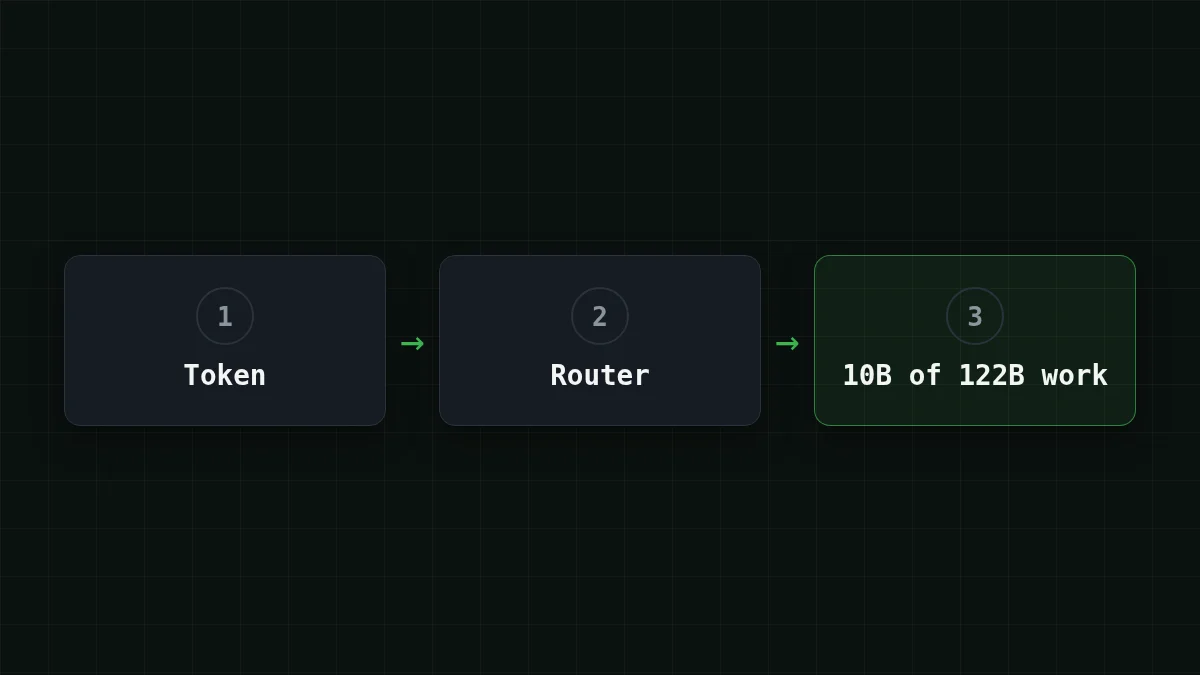
তাই: মেমরি মোট অনুসরণ করে, গণনা সক্রিয় অনুসরণ করে। দশ বিলিয়ন সক্রিয় প্যারামিটার একটি টোকেনকে গণনা করতে সস্তা করে, সংরক্ষণ করতে সস্তা নয়। RAM বা ডিস্কে বিশেষজ্ঞদের কিছু অংশ রাখা একটি সেটআপ কত দ্রুত চলে তা আপনার RAM, ডিস্ক এবং সফ্টওয়্যারের উপর নির্ভর করে। কোনও সৎ একক সংখ্যা নেই, তাই যে কোনও শিরোনাম যা একটি দেয় তা সম্পর্কে সতর্ক থাকুন।
দ্রুত যাচাই
একটি মডেলকে 122B-A10B বলা হয়। কোন সংখ্যাটি মোটামুটি নির্ধারণ করে যে এর ওয়েটের জন্য কত মেমরি প্রয়োজন?
উত্তর দেখান
উত্তর: 122B মোট প্যারামিটার
সমস্ত বিশেষজ্ঞ সংরক্ষণ করতে হবে, কারণ রাউটার পরবর্তী টোকেনের জন্য তাদের যে কোনওটি বেছে নিতে পারে। 10B শুধুমাত্র বলে যে একটি টোকেন কত কাজ নেয়।
দ্বিতীয় বিল: কনটেক্সট ক্যাশে#
ওয়েট হল স্থির অংশ। অন্য অংশটি আপনার চ্যাট করার সময় বাড়ে। প্রতিটি নতুন টোকেনের জন্য পুরো কথোপকথন পুনরায় পড়া এড়াতে, মডেলটি ইতিমধ্যে দেখা প্রতিটি টোকেনের নোট রাখে: KV ক্যাশে (কী এবং মান)। দীর্ঘ কনটেক্সট, বড় ক্যাশে। আপনি যদি কনটেক্সট দিকটি শুরু থেকে ব্যাখ্যা করতে চান, তবে কনটেক্সট উইন্ডোর একটি পৃথক গাইড রয়েছে।
প্রতি টোকেনে ক্যাশে নেয়: 2 × স্তর × KV হেড × হেড আকার × বাইট। ধরুন একটি মডেলে 48টি স্তর, 8টি KV হেড, 128 এর হেড আকার এবং একটি 16-বিট ক্যাশে রয়েছে (একটি অনুমিত আকৃতি, কোনও মডেল কার্ডের নয়):
- একটি টোকেন: 2 × 48 × 8 × 128 × 2 = 196608 বাইট, প্রায় 0.2 MB
- 32,768 টোকেন: 196608 × 32768 = 6442450944 বাইট, প্রায় 6.4 GB
- 131,072 টোকেন (128K): 196608 × 131072 = 25769803776 বাইট, প্রায় 25.8 GB
128K-এ সেই ক্যাশে একাই পুরো কার্ডের চেয়ে বড়। আপনার প্রকৃত সংখ্যাগুলি মডেলের config.json (স্তর, KV হেড, হেড আকার) এ রয়েছে, এবং কিছু আর্কিটেকচার ক্যাশে অনেক ছোট রাখে, তাই এটিকে পদ্ধতি হিসেবে গণ্য করুন, একটি মডেলের উপর রায় হিসেবে নয়।
Qwen3.5-122B-A10B কার্ডটি দেখায় বড় প্রান্তটি কেমন দেখায়: এর পরিবেশন উদাহরণগুলি সম্পূর্ণ 262,144-টোকেন কনটেক্সটে 8টি GPU জুড়ে টেনসর প্যারালেলিজম ব্যবহার করে। যদি মেমরি ফুরিয়ে যায়, এটি চিন্তা সংরক্ষণের জন্য কমপক্ষে 128K রেখে কনটেক্সট ছোট করার পরামর্শ দেয়, এবং vLLM ফ্ল্যাগ - ক্যাশের জন্য মেমরি মুক্ত করতে ভিশন এনকোডার এড়িয়ে যায়।
এক ডজন লাইনে আপনার নিজের অনুমান#
উভয় অংশ একসাথে রাখুন:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9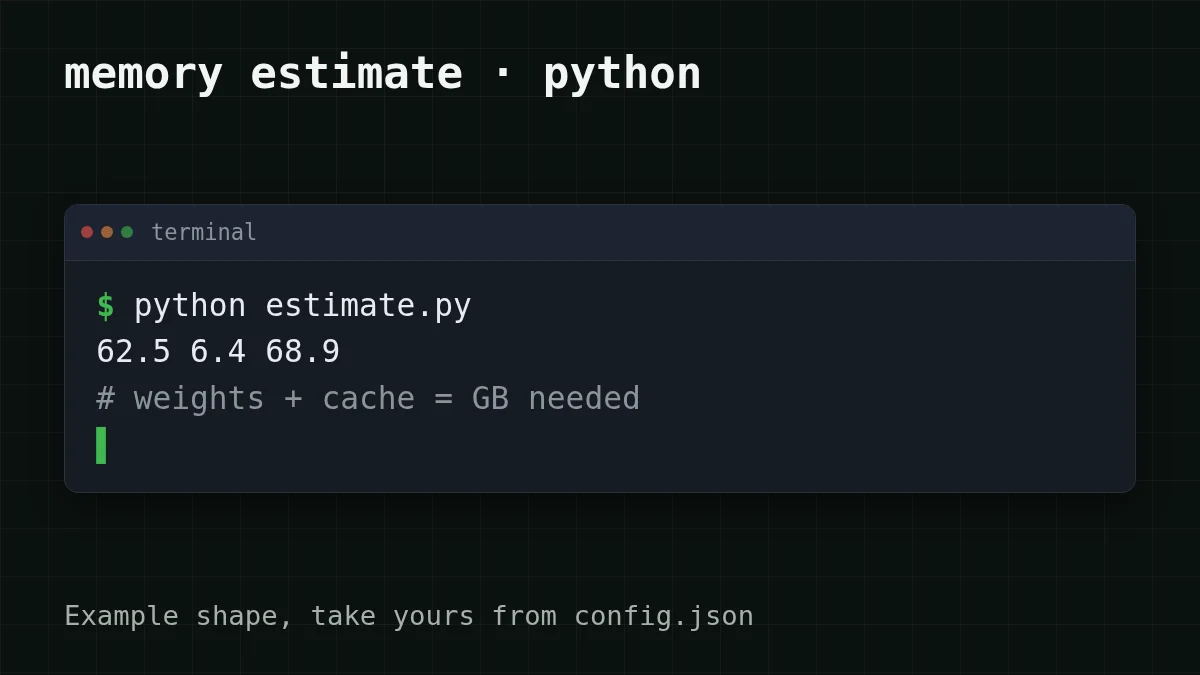
এখন বাস্তবতা পরীক্ষা। ধরুন আপনার পিসিতে 16 GB কার্ডের পাশে 32 GB RAM আছে: 16 + 32 = 48 GB, এখনও স্ক্রিপ্টের প্রিন্ট করা 68.9 GB-এর নিচে। অফলোডিংকে ডিস্কেরও সাহায্য নিতে হবে, এবং আপনি একটি বড় মডেল মূলত কার্ডের বাইরে স্টোরেজ থেকে চালাবেন।
কখন একটি API সহজ পছন্দ#
প্রতিটি কাজের জন্য আপনার ডেস্কে একটি বড় মডেল প্রয়োজন হয় না। কোনটি আপনাকে বর্ণনা করে?
আপনার কেস বেছে নিন
কোনটি আপনার ক্ষেত্রে সবচেয়ে কাছাকাছি?
উত্তর দেখতে একটি বিকল্প বেছে নিন
আমি আমার নিজের মেশিনে একটি মডেল চালাতে দেখতে চাই
একটি ছোট বেছে নিন: 4-বিটে, একটি 7B মডেল ওয়েটের জন্য প্রায় 7 × 0.5 = 3.5 GB নেয়, তাই এটি একটি দীর্ঘ চ্যাটের জন্য জায়গা সহ একটি 16 GB কার্ডে ফিট করে। মডেলগুলি কীভাবে আচরণ করে তা শেখা স্থানীয়ভাবে চালানোর সর্বোত্তম কারণ। আরও দেখুন DeepSeek-এর জন্য স্থানীয় বা API।
মাসে কয়েক হাজার অনুরোধ, এবং আমি একটি শক্তিশালী মডেল চাই
সেগুলি একটি API-তে পাঠান। আপনি মেমরি কেনা বা ভাড়া নেওয়া এড়িয়ে যান, ইনস্টল করার কিছু নেই, এবং বিল শুধুমাত্র আপনি আসলে যে টোকেনগুলি ব্যবহার করেন।
দীর্ঘ নথি বা একটি এজেন্ট যা একটি দীর্ঘ ইতিহাস রাখে
ক্যাশে হল সেই অংশ যা বাড়ে, এবং আপনার নিজের হার্ডওয়্যারে এটি একই মেমরির জন্য ওয়েটের সাথে প্রতিযোগিতা করে। একটি API-এর সাথে কনটেক্সট উইন্ডো অন্য কারও সমস্যা: CheapTokens-এ DeepSeek-V4-Flash এবং GLM-5.3-Flash 380K এবং 390K টোকেন নেয়।
অনুশীলনে এটি কেমন দেখায়। ধরুন একটি সাপোর্ট বট মাসে 3,000 টিকিট সংক্ষিপ্ত করে, প্রতিটি প্রায় 2,000 টোকেন ইন এবং 400 টোকেন আউট। মাস জুড়ে তা হল 2000 × 3000 = 6000000 ইনপুট টোকেন এবং 400 × 3000 = 1200000 আউটপুট টোকেন। DeepSeek-V4-Flash-এ, ইনপুট খরচ $0.015 এবং আউটপুট $0.10 প্রতি 1M টোকেন, তাই পুরো মাস $0.21 হয়। নিচের টেবিলটি প্রতিটি মডেলে একই লোড দেখায়, পাশে OpenRouter কলাম সহ যাতে আপনি মোট, ইনপুট এবং আউটপুট একসাথে তুলনা করতে পারেন:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ৩,০০০টি অনুরোধ | OpenRouter, ৩,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
প্রতি অনুরোধে ২,০০০ ইনপুট এবং ৪০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
অনুরোধটি নিজেই একই OpenAI-শৈলীর কল যা আপনি যে কোনও প্রদানকারীর কাছে করবেন। বেস URL হল https:/, এবং মডেল আইডি হল সম্পূর্ণ deepseek-:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
উত্তরে ইনপুট এবং আউটপুট টোকেন গণনা সহ একটি usage ব্লক থাকে, তাই প্রথম ডজন পরে আপনি আপনার নিজের টিকিটের সাথে উপরের অনুমানটি যাচাই করতে পারেন। DeepSeek-V4-Flash আপনাকে প্রতি উত্তরে 32,768 আউটপুট টোকেন পর্যন্ত একটি দামে সারাদিন দেয়, এবং GLM-5.3-Flash হল হালকা দৈনন্দিন বিকল্প যা 8,192 পর্যন্ত। সেটআপের বিবরণ ডক্সে, মডেল পৃষ্ঠা সস্তা DeepSeek, এবং সম্পূর্ণ মূল্য তালিকা মূল্য পৃষ্ঠায়।
পরের বার যখন একটি মডেলের নামের সাথে একটি আকার আসবে, আপনার এখন তিনটি ধাপ রয়েছে: গুণ করুন, ক্যাশে যোগ করুন, কার্ডের সাথে তুলনা করুন।


