क्या 125B मॉडल 16 GB GPU पर चल सकता है? मेमोरी का गणित
125B ओपन मॉडल को कितनी मेमोरी चाहिए: कुछ पंक्तियों के गणित में वेट्स, क्वांटाइज़ेशन और KV कैश, और कब API इसका उपयोग करने का आसान तरीका है।
इस पृष्ठ पर
संक्षिप्त उत्तर: नहीं। 125B-पैरामीटर मॉडल को 4-बिट संपीड़न के बाद भी उसके वेट्स के लिए लगभग 62.5 GB चाहिए, और 16 GB का ग्राफ़िक्स कार्ड उसका लगभग एक चौथाई ही रख सकता है। आप इसे बाकी हिस्सा सिस्टम RAM या डिस्क में डालकर फिर भी चालू कर सकते हैं, लेकिन तब कार्ड यह तय नहीं करता कि चीज़ें कैसे चलेंगी।
नीचे: कुछ पंक्तियों में यह संख्या खुद कैसे निकालें, मॉडल के नाम में “122B-A10B” वास्तव में क्या बताता है, और कब किसी API पर अनुरोध भेजना बड़े मॉडल का उपयोग करने का आसान तरीका है।
वेट्स: पैरामीटर गुणा बाइट्स#
मॉडल को संख्याओं के एक बड़े ढेर के रूप में सोचें, जिन्हें वेट्स या पैरामीटर कहते हैं। आपको उत्तर देने के लिए, कंप्यूटर को उन सभी को एक साथ तेज़ मेमोरी में रखना होता है। तो पहला अनुमान सीधा गुणा है: अरबों में पैरामीटर × प्रति वेट बाइट्स = गीगाबाइट्स। एक वेट 16-बिट पर 2 बाइट, 8-बिट पर 1 बाइट और 4-बिट पर 0.5 बाइट लेता है। क्वांटाइज़ेशन बस यही करता है: प्रति संख्या कम बिट्स।
इस श्रेणी का एक मॉडल लें, Qwen3.5-122B-A10B। इसका Hugging Face पेज (30 अक्टूबर 2026 को जाँचा गया) लाइसेंस के रूप में Apache-2.0 बताता है, वेट्स को BF16 और F32 में प्रकाशित करता है, और आकार 125B पैरामीटर बताता है। 125B के लिए:
- 16 बिट पर: 125 × 2 = 250 GB
- 8 बिट पर: 125 × 1 = 125 GB
- 4 बिट पर: 125 × 0.5 = 62.5 GB
- 2 बिट पर: 125 × 0.25 = 31.25 GB
2-बिट वाली पंक्ति भी कार्ड से लगभग दोगुनी है। और ये न्यूनतम हैं, कुल नहीं: इनमें कॉन्टेक्स्ट कैश (अगले भाग) और रनटाइम का अपना ओवरहेड शामिल नहीं है, और असली क्वांटाइज़्ड फ़ॉर्मेट थोड़ा और जोड़ते हैं।
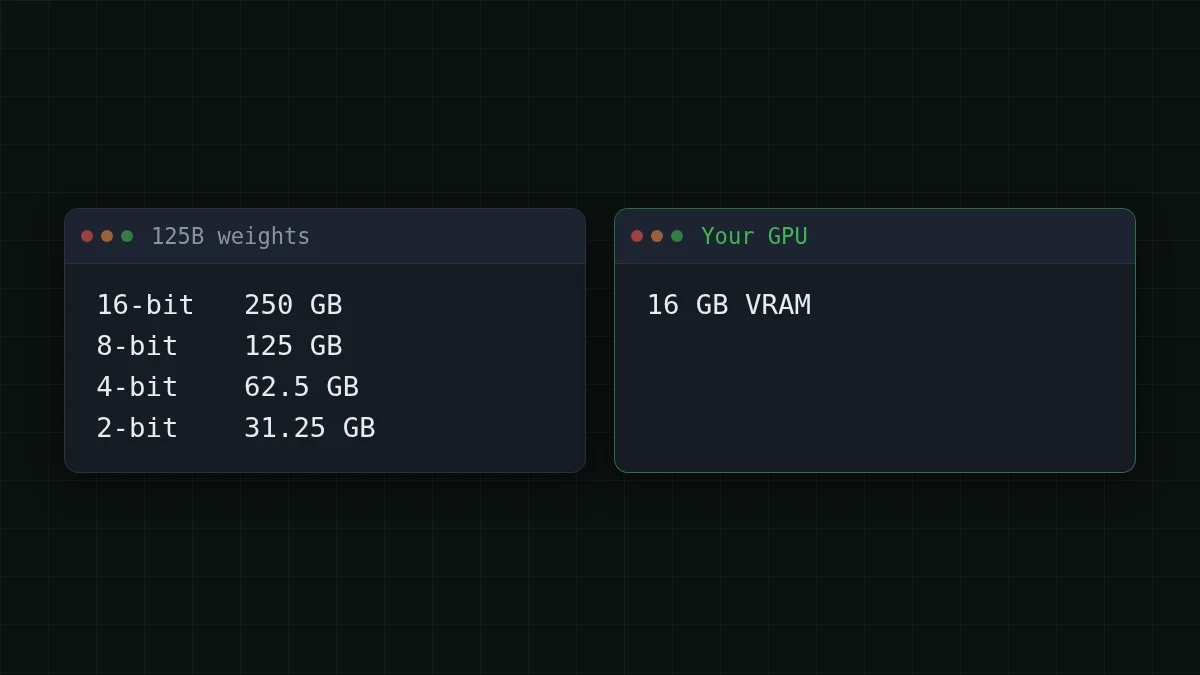
यह देखने के लिए सूत्र पलटें कि 16 GB कार्ड कितना रख सकता है। 4-बिट पर यह 16 / 0.5 = 32 अरब पैरामीटर है, और कुछ और जगह लेने से पहले यही सीमा है। योग खुद आज़माएँ:
संख्या का अनुमान लगाएँ
4-बिट पर 32B मॉडल के वेट्स कितने GB लेते हैं?
आपका अनुमान
0100
उत्तर दिखाएँ
उत्तर: 16
32 × 0.5 = 16 GB। आपके प्रश्न का एक शब्द पढ़ने से पहले ही कार्ड भर जाता है, इसलिए 16 GB कार्ड के लिए 32B ऊपरी सीमा है और आरामदायक आकार इससे कम होते हैं।
“122B-A10B”: कौन-सी संख्या मायने रखती है#
नाम में दो संख्याएँ हैं। मॉडल कार्ड के अनुसार, मॉडल में कुल 122B पैरामीटर हैं और प्रत्येक टोकन के लिए 10B सक्रिय हैं। यह मिश्रण-ऑफ़-एक्सपर्ट्स मॉडल है: अंदर कई छोटे विशेषज्ञ सब-नेटवर्क हैं, और हर टोकन के लिए एक राउटर उनमें से केवल कुछ को जगाता है।
122 शेल्फ़ वाली एक लाइब्रेरी सोचें जहाँ कोई भी प्रश्न आपको उनमें से 10 तक भेजता है। आपका पढ़ने का प्रयास कम है, लेकिन पूरी लाइब्रेरी को अभी भी इमारत के अंदर होना चाहिए, क्योंकि आप नहीं जान सकते कि अगले शब्द को कौन-से शेल्फ़ चाहिए होंगे।
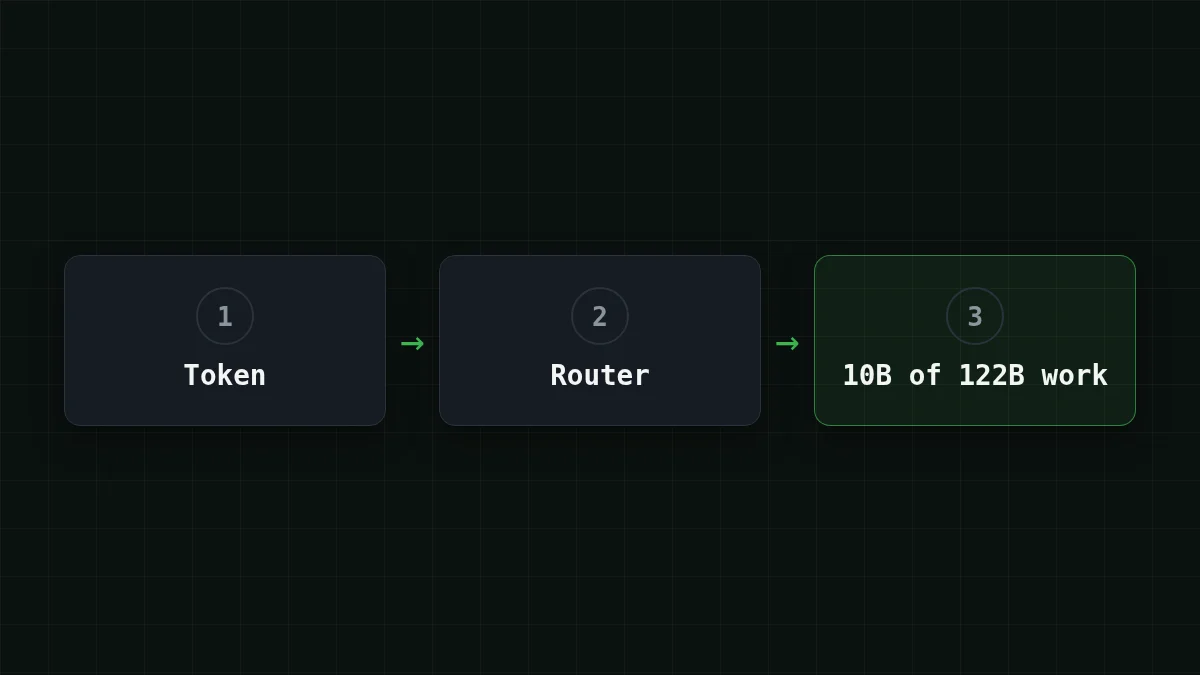
तो: मेमोरी कुल का पीछा करती है, कंप्यूट सक्रिय का। दस अरब सक्रिय पैरामीटर एक टोकन को कंप्यूट करने में सस्ता बनाते हैं, स्टोर करने में नहीं। जो सेटअप एक्सपर्ट्स का कुछ हिस्सा RAM या डिस्क में रखता है, वह कितनी तेज़ी से चलता है यह आपकी RAM, डिस्क और सॉफ़्टवेयर पर निर्भर करता है। कोई ईमानदार एकल संख्या नहीं है, इसलिए ऐसी किसी भी हेडलाइन से सावधान रहें जो एक संख्या देती हो।
त्वरित जाँच
एक मॉडल को 122B-A10B कहा जाता है। कौन-सी संख्या मोटे तौर पर तय करती है कि उसके वेट्स को कितनी मेमोरी चाहिए?
उत्तर दिखाएँ
उत्तर: 122B कुल पैरामीटर
सभी एक्सपर्ट्स को संग्रहीत करना होता है, क्योंकि राउटर अगले टोकन के लिए उनमें से कोई भी चुन सकता है। 10B केवल बताता है कि एक टोकन में कितना काम लगता है।
दूसरा बिल: कॉन्टेक्स्ट कैश#
वेट्स स्थिर हिस्सा हैं। दूसरा हिस्सा चैट करते समय बढ़ता है। हर नए टोकन के लिए पूरी बातचीत दोबारा पढ़ने से बचने के लिए, मॉडल हर उस टोकन पर नोट्स रखता है जो उसने पहले देखा है: KV कैश (कीज़ और वैल्यूज़)। लंबा कॉन्टेक्स्ट, बड़ा कैश। यदि आप कॉन्टेक्स्ट पक्ष को शुरू से समझना चाहते हैं, तो कॉन्टेक्स्ट विंडो पर एक अलग गाइड है।
प्रति टोकन कैश लेता है: 2 × लेयर्स × KV हेड्स × हेड साइज़ × बाइट्स। मान लें किसी मॉडल में 48 लेयर्स, 8 KV हेड्स, 128 का हेड साइज़ और 16-बिट कैश है (यह एक अनुमानित आकार है, किसी मॉडल कार्ड से नहीं):
- एक टोकन: 2 × 48 × 8 × 128 × 2 = 196608 बाइट्स, लगभग 0.2 MB
- 32,768 टोकन: 196608 × 32768 = 6442450944 बाइट्स, लगभग 6.4 GB
- 131,072 टोकन (128K): 196608 × 131072 = 25769803776 बाइट्स, लगभग 25.8 GB
128K पर वह कैश अकेला पूरे कार्ड से बड़ा है। आपकी असली संख्याएँ मॉडल के config.json (लेयर्स, KV हेड्स, हेड साइज़) में हैं, और कुछ आर्किटेक्चर कैश को बहुत छोटा रखते हैं, इसलिए इसे विधि मानें, किसी एक मॉडल पर फ़ैसला नहीं।
Qwen3.5-122B-A10B कार्ड दिखाता है कि बड़ा सिरा कैसा दिखता है: इसके सर्विंग उदाहरण पूरे 262,144-टोकन कॉन्टेक्स्ट पर 8 GPUs में टेंसर पैरेललिज़्म का उपयोग करते हैं। यदि मेमोरी खत्म हो जाए, तो यह कॉन्टेक्स्ट छोटा करने की सलाह देता है जबकि थिंकिंग बनाए रखने के लिए कम से कम 128K रखें, और vLLM फ़्लैग - कैश के लिए मेमोरी खाली करने हेतु विज़न एनकोडर छोड़ देता है।
एक दर्जन पंक्तियों में आपका अपना अनुमान#
दोनों हिस्सों को मिलाएँ:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9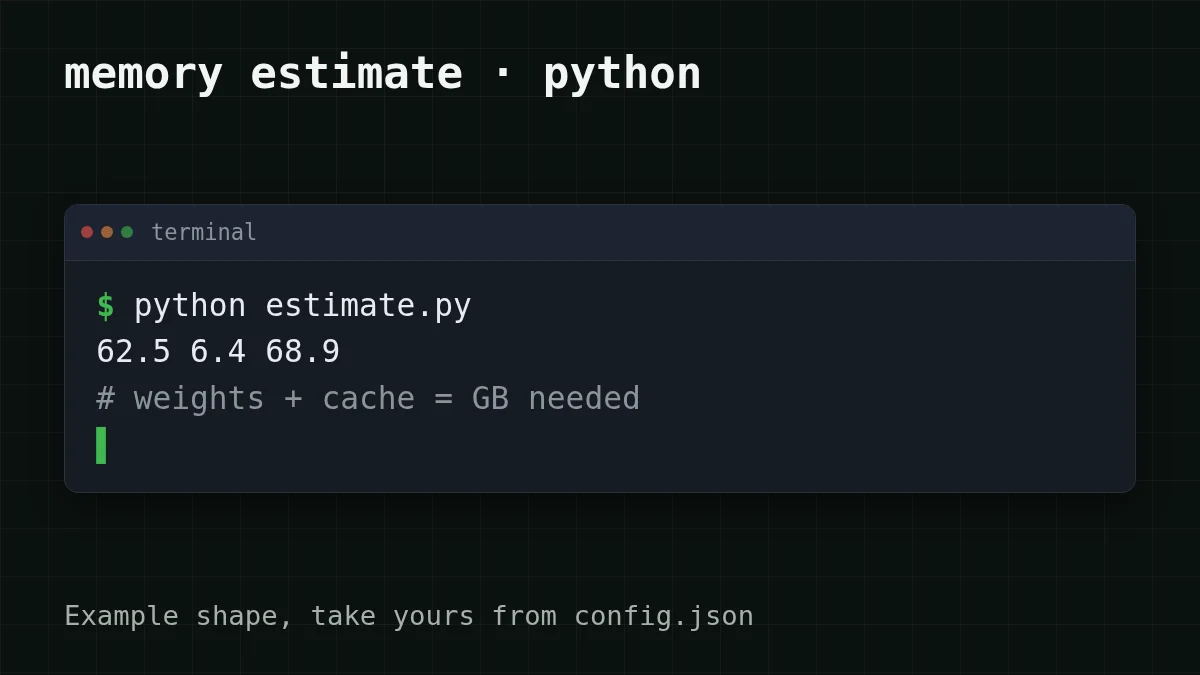
अब वास्तविकता की जाँच। मान लें आपके PC में 16 GB कार्ड के साथ 32 GB RAM है: 16 + 32 = 48 GB, जो स्क्रिप्ट द्वारा प्रिंट किए गए 68.9 GB से अभी भी कम है। ऑफ़लोडिंग को डिस्क तक भी पहुँचना पड़ेगा, और आप एक बड़ा मॉडल ज़्यादातर स्टोरेज से चला रहे होंगे, कार्ड से नहीं।
जब API आसान विकल्प है#
हर काम के लिए आपके डेस्क पर बड़ा मॉडल ज़रूरी नहीं है। आपको कौन-सा वर्णन करता है?
अपना मामला चुनें
आपकी स्थिति से कौन-सा सबसे नज़दीक है?
उत्तर देखने के लिए एक विकल्प चुनें
मैं अपनी मशीन पर मॉडल चलते देखना चाहता/चाहती हूँ
छोटा चुनें: 4-बिट पर, 7B मॉडल वेट्स के लिए लगभग 7 × 0.5 = 3.5 GB लेता है, इसलिए यह लंबी चैट के लिए जगह के साथ 16 GB कार्ड में फ़िट हो जाता है। मॉडल कैसे व्यवहार करते हैं यह सीखना लोकली चलाने का सबसे अच्छा कारण है। DeepSeek के लिए लोकल या API भी देखें।
महीने में कुछ हज़ार अनुरोध, और मुझे मज़बूत मॉडल चाहिए
उन्हें API पर भेजें। आप मेमोरी खरीदने या किराए पर लेने से बचते हैं, कुछ इंस्टॉल करने की ज़रूरत नहीं, और बिल केवल उन टोकन का है जो आप वास्तव में उपयोग करते हैं।
लंबे दस्तावेज़ या लंबा इतिहास रखने वाला एजेंट
कैश वह हिस्सा है जो बढ़ता है, और आपके अपने हार्डवेयर पर यह उसी मेमोरी के लिए वेट्स से मुकाबला करता है। API के साथ कॉन्टेक्स्ट विंडो किसी और की समस्या है: CheapTokens पर DeepSeek-V4-Flash और GLM-5.3-Flash 380K और 390K टोकन लेते हैं।
व्यवहार में यह कैसा दिखता है। मान लें एक सपोर्ट बॉट महीने में 3,000 टिकट सारांशित करता है, प्रत्येक में लगभग 2,000 टोकन इन और 400 टोकन आउट। महीने भर में यह 2000 × 3000 = 6000000 इनपुट टोकन और 400 × 3000 = 1200000 आउटपुट टोकन है। DeepSeek-V4-Flash पर, इनपुट की लागत $0.015 और आउटपुट की $0.10 प्रति 1M टोकन है, इसलिए पूरा महीना $0.21 होता है। नीचे दी गई तालिका हर मॉडल पर वही लोड दिखाती है, साथ में OpenRouter कॉलम भी है ताकि आप कुल, इनपुट और आउटपुट को एक साथ मिलाकर तुलना कर सकें:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 3,000 अनुरोध | OpenRouter, 3,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
प्रति अनुरोध 2,000 इनपुट और 400 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
अनुरोध स्वयं वही OpenAI-शैली कॉल है जो आप किसी भी प्रदाता को करेंगे। बेस URL https:/ है, और मॉडल id पूरा deepseek- है:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
उत्तर में इनपुट और आउटपुट टोकन गणना के साथ एक usage ब्लॉक होता है, इसलिए पहले दर्जन के बाद आप ऊपर के अनुमान को अपने टिकटों से जाँच सकते हैं। DeepSeek-V4-Flash आपको प्रति उत्तर 32,768 आउटपुट टोकन तक देता है, चौबीसों घंटे एक ही कीमत पर, और GLM-5.3-Flash 8,192 तक के साथ हल्का रोज़मर्रा का विकल्प है। सेटअप विवरण डॉक्स में हैं, मॉडल पेज सस्ता DeepSeek है, और पूरी मूल्य सूची मूल्य पेज पर है।
अगली बार जब किसी मॉडल के नाम के साथ आकार आए, तो आपके पास तीन चरण हैं: गुणा करें, कैश जोड़ें, कार्ड से तुलना करें।


