نئے سیکھنے والوں کے لیے AIگائیڈ
کیا 125B ماڈل 16 GB GPU پر چل سکتا ہے؟ میموری کا حساب
125B اوپن ماڈل کو کتنی میموری چاہیے: وزن، کوانٹائزیشن اور KV کیش چند سطروں کے حساب میں، اور کب API اسے استعمال کرنے کا آسان طریقہ ہے۔
اس صفحہ پر
مختصر جواب: نہیں۔ 125B پیرامیٹرز والے ماڈل کو 4-بٹ کمپریشن کے بعد بھی اس کے وزن کے لیے تقریباً 62.5 GB درکار ہوتے ہیں، اور 16 GB کا گرافکس کارڈ اس کا تقریباً ایک چوتھائی رکھتا ہے۔ آپ اسے باقی حصہ سسٹم RAM یا ڈسک میں ڈال کر پھر بھی شروع کر سکتے ہیں، لیکن پھر کارڈ وہ چیز نہیں رہتا جو فیصلہ کرتا ہے کہ معاملات کیسے چلیں گے۔
نیچے: یہ نمبر خود چند سطروں میں کیسے نکالیں، ماڈل کے نام میں “122B-A10B” دراصل کیا بتاتا ہے، اور کب API کو درخواستیں بھیجنا بڑے ماڈل کے استعمال کا آسان طریقہ ہے۔
وزن: پیرامیٹرز ضرب بائٹس#
ماڈل کو اعداد کے ایک بہت بڑے ڈھیر کے طور پر تصور کریں، جنہیں وزن یا پیرامیٹرز کہتے ہیں۔ آپ کو جواب دینے کے لیے کمپیوٹر کو یہ سب ایک ساتھ تیز میموری میں چاہیے ہوتے ہیں۔ تو پہلا اندازہ سادہ ضرب ہے: ارب میں پیرامیٹرز × فی وزن بائٹس = گیگا بائٹس۔ ایک وزن 16-بٹ پر 2 بائٹس، 8-بٹ پر 1 بائٹ اور 4-بٹ پر 0.5 بائٹ لیتا ہے۔ کوانٹائزیشن بس یہی کرتی ہے: فی عدد کم بٹس۔
اس طبقے کا ایک ماڈل لیں، Qwen3.5-122B-A10B۔ اس کے Hugging Face صفحے (30 اکتوبر 2026 کو چیک کیا گیا) پر لائسنس کے طور پر Apache-2.0 درج ہے، وزن BF16 اور F32 میں شائع کیے گئے ہیں، اور سائز 125B پیرامیٹرز بتایا گیا ہے۔ 125B کے لیے:
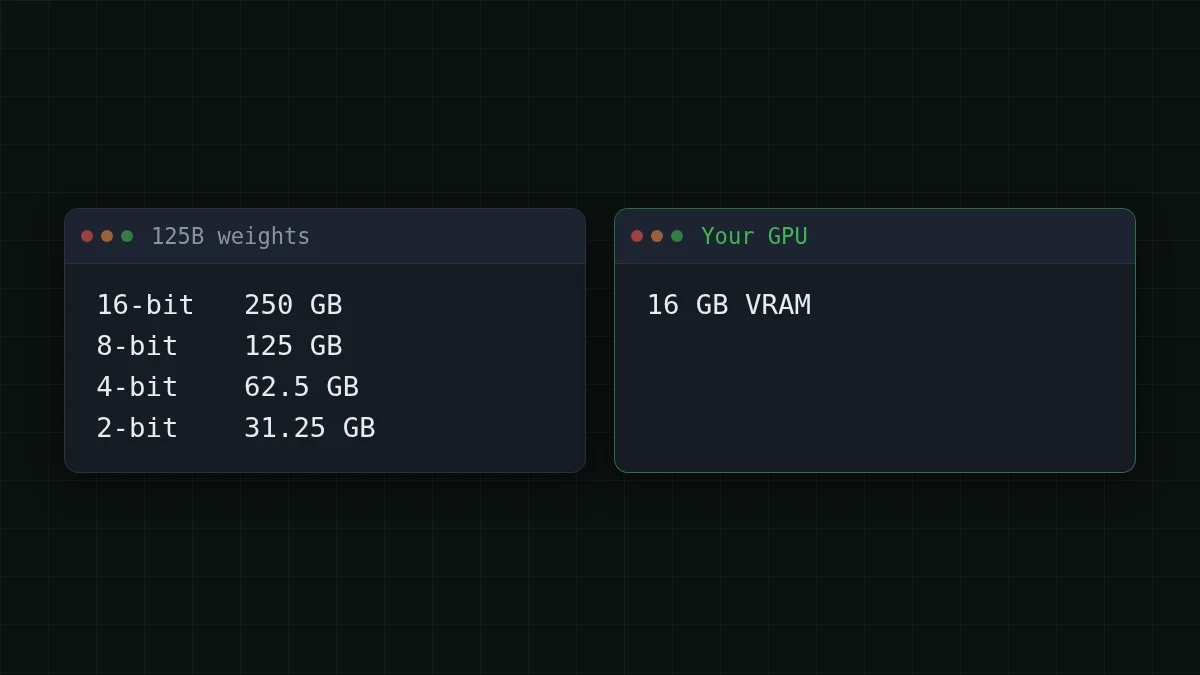
- 16 بٹ پر: 125 × 2 = 250 GB
- 8 بٹ پر: 125 × 1 = 125 GB
- 4 بٹ پر: 125 × 0.5 = 62.5 GB
- 2 بٹ پر: 125 × 0.25 = 31.25 GB
2-بٹ والی سطر بھی کارڈ سے تقریباً دوگنی ہے۔ اور یہ کم از کم حدیں ہیں، کل نہیں: ان میں کانٹیکسٹ کیش (اگلے حصے) اور رن ٹائم کا اپنا اوور ہیڈ شامل نہیں، اور حقیقی کوانٹائزڈ فارمیٹس اس کے اوپر تھوڑا اضافہ کرتے ہیں۔
فارمولا الٹ کر دیکھیں کہ 16 GB کارڈ کتنا رکھ سکتا ہے۔ 4-بٹ پر یہ 16 / 0.5 = 32 ارب پیرامیٹرز ہے، اور یہی حد ہے اس سے پہلے کہ کسی اور چیز کو جگہ چاہیے ہو۔ حساب خود آزمائیں:
نمبر کا اندازہ لگائیں
4-بٹ پر 32B ماڈل کے وزن کتنے GB لیتے ہیں؟
آپ کا اندازہ
0100
جواب دکھائیں
جواب: 16
32 × 0.5 = 16 GB۔ آپ کے سوال کا ایک لفظ پڑھنے سے پہلے ہی کارڈ بھر جاتا ہے، اس لیے 16 GB کارڈ کے لیے 32B زیادہ سے زیادہ حد ہے اور آرام دہ سائزیں اس سے کم ہوتی ہیں۔
“122B-A10B”: کون سا نمبر شمار ہوتا ہے#
نام میں دو نمبر ہیں۔ ماڈل کارڈ کے مطابق، ماڈل میں کل 122B پیرامیٹرز ہیں اور ہر ٹوکن کے لیے 10B فعال ہیں۔ یہ mixture-of-experts ماڈل ہے: اندر بہت سے چھوٹے ماہر ذیلی نیٹ ورکس ہیں، اور ہر ٹوکن کے لیے ایک راؤٹر ان میں سے صرف چند کو جگاتا ہے۔
ایک لائبریری سوچیں جس میں 122 شیلف ہوں اور کوئی بھی سوال آپ کو ان میں سے 10 تک بھیجے۔ آپ کی پڑھنے کی محنت کم ہے، لیکن پوری لائبریری کو عمارت کے اندر ہی رہنا ہوگا، کیونکہ آپ نہیں جان سکتے کہ اگلے لفظ کو کون سے شیلف چاہیے ہوں گے۔
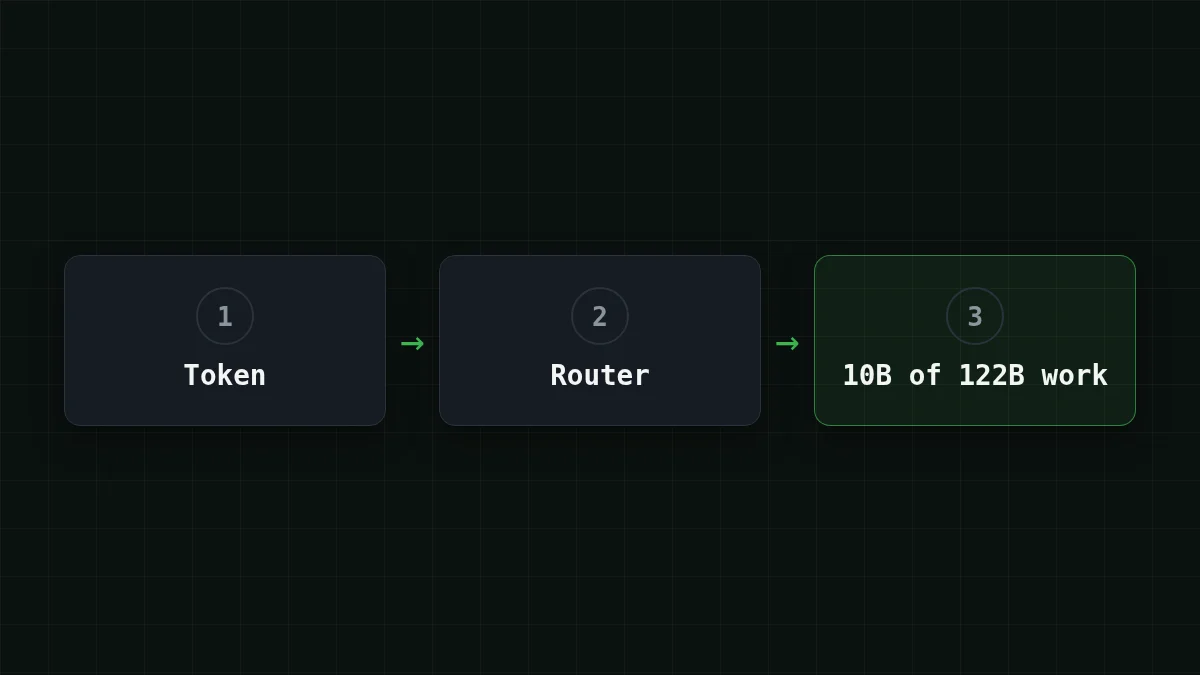
تو: میموری کل کی پیروی کرتی ہے، کمپیوٹ فعال کی۔ دس ارب فعال پیرامیٹرز ٹوکن کو کمپیوٹ کے لحاظ سے سستا بناتے ہیں، ذخیرہ کرنے کے لحاظ سے نہیں۔ جو سیٹ اپ ماہرین کا کچھ حصہ RAM یا ڈسک میں رکھتا ہے اس کی رفتار آپ کی RAM، ڈسک اور سافٹ ویئر پر منحصر ہے۔ کوئی ایماندار واحد عدد نہیں ہے، اس لیے کسی بھی ایسی سرخی سے ہوشیار رہیں جو ایک عدد دے۔
فوری جانچ
ایک ماڈل کو 122B-A10B کہا جاتا ہے۔ کون سا نمبر تقریباً طے کرتا ہے کہ اس کے وزن کو کتنی میموری چاہیے؟
جواب دکھائیں
جواب: 122B کل پیرامیٹرز
تمام ماہرین کو ذخیرہ کرنا ضروری ہے، کیونکہ راؤٹر اگلے ٹوکن کے لیے ان میں سے کوئی بھی چن سکتا ہے۔ 10B صرف یہ بتاتا ہے کہ ایک ٹوکن کتنا کام لیتا ہے۔
دوسرا بل: کانٹیکسٹ کیش#
وزن مقررہ حصہ ہیں۔ دوسرا حصہ چیٹ کے دوران بڑھتا ہے۔ ہر نئے ٹوکن کے لیے پوری گفتگو دوبارہ پڑھنے سے بچنے کے لیے، ماڈل ہر اس ٹوکن پر نوٹس رکھتا ہے جو وہ پہلے دیکھ چکا ہے: KV کیش (کیز اور ویلیوز)۔ لمبا کانٹیکسٹ، بڑا کیش۔ اگر آپ کانٹیکسٹ کا پہلو شروع سے سمجھنا چاہتے ہیں، تو کانٹیکسٹ ونڈو کی الگ گائیڈ موجود ہے۔
فی ٹوکن کیش لیتا ہے: 2 × لیئرز × KV ہیڈز × ہیڈ سائز × بائٹس۔ فرض کریں ایک ماڈل میں 48 لیئرز، 8 KV ہیڈز، 128 کا ہیڈ سائز اور 16-بٹ کیش ہے (یہ فرضی شکل ہے، کسی ماڈل کارڈ سے نہیں):
- ایک ٹوکن: 2 × 48 × 8 × 128 × 2 = 196608 بائٹس، تقریباً 0.2 MB
- 32,768 ٹوکنز: 196608 × 32768 = 6442450944 بائٹس، تقریباً 6.4 GB
- 131,072 ٹوکنز (128K): 196608 × 131072 = 25769803776 بائٹس، تقریباً 25.8 GB
128K پر یہ کیش اکیلا پورے کارڈ سے بڑا ہے۔ آپ کے حقیقی اعداد ماڈل کے config.json میں ہیں (لیئرز، KV ہیڈز، ہیڈ سائز)، اور کچھ آرکیٹیکچرز کیش کو بہت چھوٹا رکھتے ہیں، اس لیے اسے طریقہ سمجھیں، کسی ایک ماڈل پر فیصلہ نہیں۔
Qwen3.5-122B-A10B کارڈ دکھاتا ہے کہ بڑا سرا کیسا لگتا ہے: اس کی سروِنگ مثالیں مکمل 262,144-ٹوکن کانٹیکسٹ پر 8 GPUs میں ٹینسر پیراللزم استعمال کرتی ہیں۔ اگر میموری ختم ہو جائے، تو یہ کانٹیکسٹ چھوٹا کرنے کا مشورہ دیتا ہے جبکہ سوچ کو برقرار رکھنے کے لیے کم از کم 128K رکھیں، اور vLLM کا فلیگ - وژن انکوڈر چھوڑ دیتا ہے تاکہ کیش کے لیے میموری آزاد ہو۔
اپنا اندازہ ایک درجن سطروں میں#
دونوں حصے ملا دیں:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9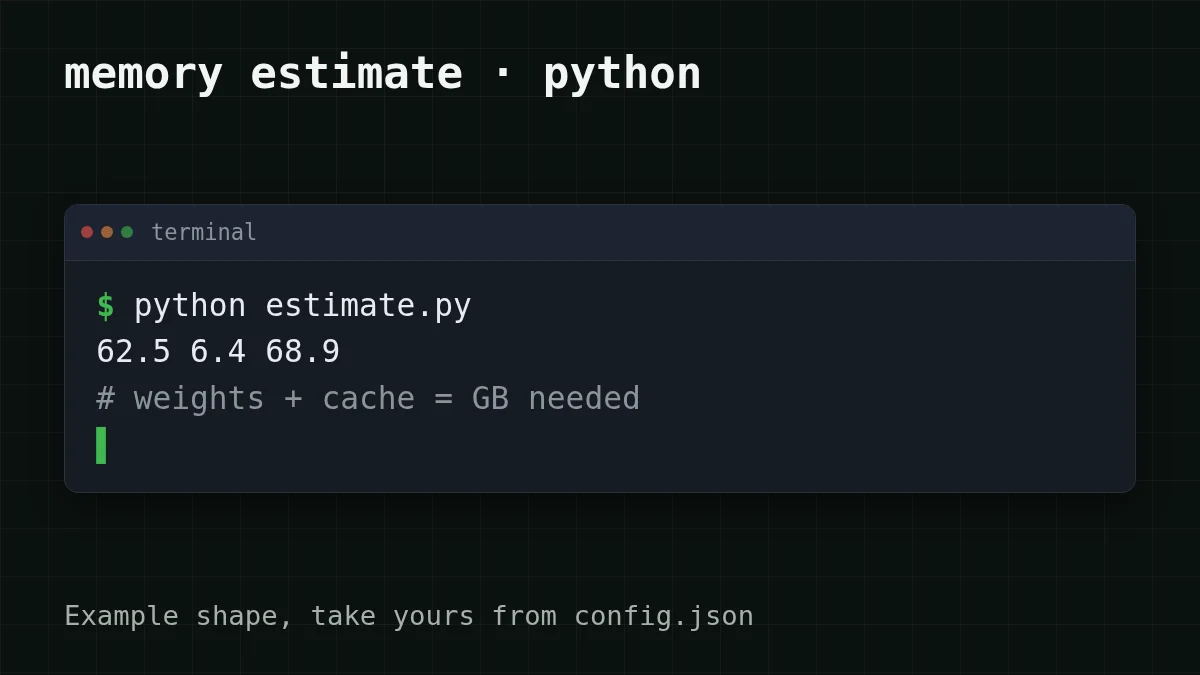
اب حقیقت کی جانچ۔ فرض کریں آپ کے PC میں 16 GB کارڈ کے ساتھ 32 GB RAM ہے: 16 + 32 = 48 GB، جو اسکرپٹ کے چھاپے 68.9 GB سے اب بھی کم ہے۔ آف لوڈنگ کو ڈسک تک بھی پہنچنا پڑے گا، اور آپ بڑا ماڈل زیادہ تر اسٹوریج سے چلا رہے ہوں گے، کارڈ سے نہیں۔
جب API آسان انتخاب ہے#
ہر کام کے لیے آپ کی میز پر بڑا ماڈل ضروری نہیں۔ کون سی بات آپ پر لاگو ہوتی ہے؟
اپنا کیس منتخب کریں
آپ کے معاملے سے سب سے قریب کیا ہے؟
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
میں ماڈل کو اپنی مشین پر چلتے دیکھنا چاہتا ہوں
چھوٹا منتخب کریں: 4-بٹ پر، 7B ماڈل وزن کے لیے تقریباً 7 × 0.5 = 3.5 GB لیتا ہے، تو یہ 16 GB کارڈ میں لمبی چیٹ کے لیے جگہ کے ساتھ فٹ ہو جاتا ہے۔ ماڈل کیسے برتاؤ کرتے ہیں یہ سیکھنا مقامی طور پر چلانے کی بہترین وجہ ہے۔ DeepSeek کے لیے مقامی یا API بھی دیکھیں۔
مہینے میں چند ہزار درخواستیں، اور مجھے مضبوط ماڈل چاہیے
انہیں API کو بھیجیں۔ آپ میموری خریدنے یا کرائے پر لینے سے بچ جاتے ہیں، کچھ انسٹال کرنے کی ضرورت نہیں، اور بل صرف ان ٹوکنز کا ہے جو آپ واقعی استعمال کرتے ہیں۔
لمبی دستاویزات یا ایجنٹ جو لمبی تاریخ رکھتا ہے
کیش وہ حصہ ہے جو بڑھتا ہے، اور آپ کے اپنے ہارڈ ویئر پر یہ وزن کے ساتھ اسی میموری کے لیے مقابلہ کرتا ہے۔ API کے ساتھ کانٹیکسٹ ونڈو کسی اور کا مسئلہ ہے: CheapTokens پر DeepSeek-V4-Flash اور GLM-5.3-Flash 380K اور 390K ٹوکنز لیتے ہیں۔
عملی طور پر یہ کیسا لگتا ہے۔ فرض کریں ایک سپورٹ بوٹ مہینے میں 3,000 ٹکٹس کا خلاصہ کرتا ہے، ہر ایک میں تقریباً 2,000 ٹوکن ان پٹ اور 400 ٹوکن آؤٹ پٹ۔ مہینے بھر میں یہ 2000 × 3000 = 6000000 ان پٹ ٹوکنز اور 400 × 3000 = 1200000 آؤٹ پٹ ٹوکنز ہیں۔ DeepSeek-V4-Flash پر، ان پٹ $0.015 اور آؤٹ پٹ $0.10 فی 1M ٹوکنز ہے، تو پورا مہینہ $0.21 بنتا ہے۔ نیچے دیا گیا جدول ہر ماڈل پر یہی بوجھ دکھاتا ہے، ساتھ OpenRouter کالم بھی تاکہ آپ کل، ان پٹ اور آؤٹ پٹ ملا کر موازنہ کر سکیں:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 3,000 درخواستیں | OpenRouter، 3,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
فی درخواست 2,000 ان پٹ اور 400 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
درخواست خود وہی OpenAI طرز کی کال ہے جو آپ کسی بھی پرووائیڈر کو کریں گے۔ بیس URL https:/ ہے، اور ماڈل آئی ڈی مکمل deepseek- ہے:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
جواب میں usage بلاک ہوتا ہے جس میں ان پٹ اور آؤٹ پٹ ٹوکنز کی گنتی ہوتی ہے، تاکہ آپ پہلے درجن کے بعد اوپر کے اندازے کو اپنے ٹکٹس سے جانچ سکیں۔ DeepSeek-V4-Flash آپ کو فی جواب 32,768 آؤٹ پٹ ٹوکنز تک دیتا ہے ایک ہی قیمت پر چوبیس گھنٹے، اور GLM-5.3-Flash 8,192 تک کے ساتھ ہلکا روزمرہ آپشن ہے۔ سیٹ اپ کی تفصیلات ڈاکس میں ہیں، ماڈل صفحہ سستا DeepSeek ہے، اور مکمل قیمت کی فہرست قیمتوں کے صفحے پر ہے۔
اگلی بار جب ماڈل کے نام کے ساتھ سائز آئے، تو آپ کے پاس تین قدم ہیں: ضرب کریں، کیش شامل کریں، کارڈ سے موازنہ کریں۔


