AI для новичковИнструкция
Влезет ли модель на 125B в видеокарту на 16 ГБ: считаем память
Сколько памяти нужно открытой модели на 125B: веса, квантизация и KV-кэш в нескольких строках расчёта и случаи, когда проще взять API.
Содержание
Коротко: нет. Только веса модели на 125 миллиардов параметров занимают около 62,5 ГБ даже после сжатия до 4 бит, а видеокарта на 16 ГБ вмещает примерно четверть от этого. Запустить её всё равно можно, если остальное вытеснить в оперативную память или на диск, но тогда исход определяет уже не карта.
Ниже: как получить это число самому в несколько строк, что на самом деле означает «122B-A10B» в названии модели и когда запросы к API — более простой способ пользоваться большой моделью.
Веса: параметры на байты#
Представьте модель как огромную стопку чисел — весов, или параметров. Чтобы ответить вам, компьютеру нужны все они сразу, в быстрой памяти. Поэтому первая прикидка — обычное умножение: параметры в миллиардах × байт на вес = гигабайты. При 16 битах вес занимает 2 байта, при 8 битах — 1 байт, при 4 битах — 0,5 байта. Именно это и делает квантизация: меньше бит на число.
Возьмём модель этого класса — Qwen3.5-122B-A10B. На её странице в Hugging Face (проверено 30 октября 2026 года) указана лицензия Apache-2.0, веса выложены в BF16 и F32, а размер записан как 125B параметров. Для 125B:
- 16 бит: 125 × 2 = 250 ГБ
- 8 бит: 125 × 1 = 125 ГБ
- 4 бита: 125 × 0,5 = 62,5 ГБ
- 2 бита: 125 × 0,25 = 31,25 ГБ
Даже строка на 2 бита почти вдвое больше карты. И это нижняя граница, а не итог: сюда не вошли кэш контекста (следующие разделы) и накладные расходы самой программы, а реальные квантованные форматы добавляют ещё немного.
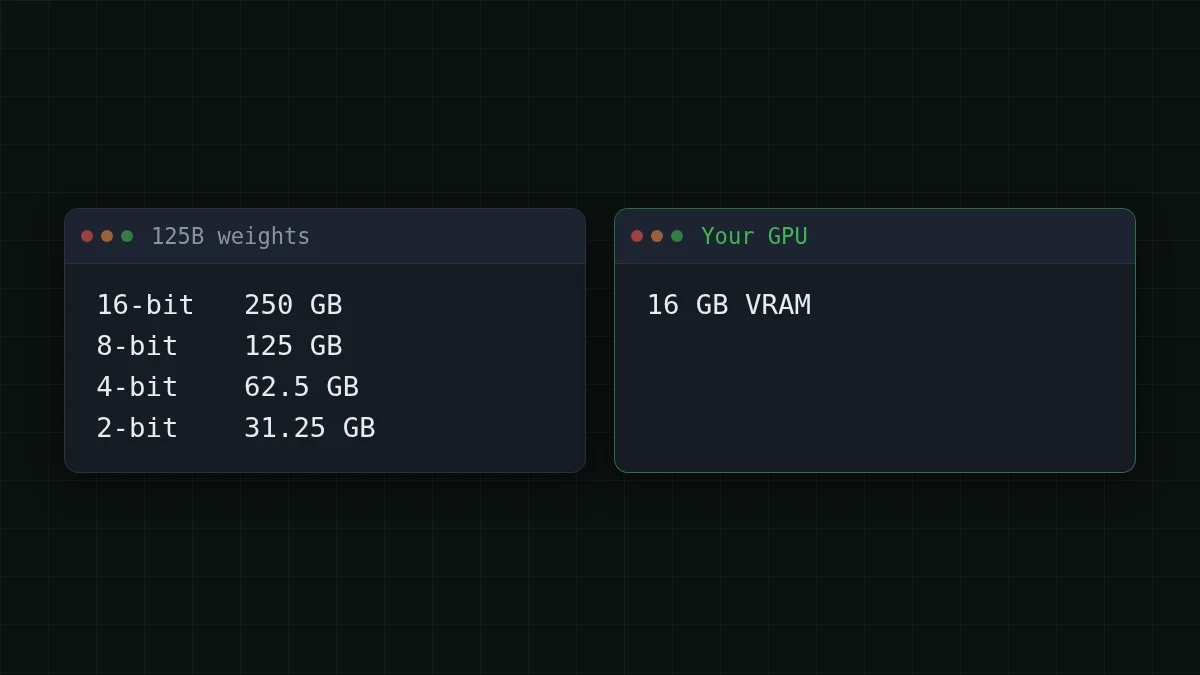
Перевернём формулу и посмотрим, что помещается в 16 ГБ. В 4 бита это 16 / 0,5 = 32 миллиарда параметров — и это потолок, пока для остального места нет. Посчитайте сами:
Угадайте число
Сколько ГБ занимают веса модели на 32B в 4 бита?
Ваш вариант
0100
Показать ответ
Ответ: 16
32 × 0,5 = 16 ГБ. Карта заполнена ещё до того, как модель прочла первое слово вашего вопроса. Поэтому 32B — потолок для 16 ГБ, а комфортные размеры лежат ниже.
«122B-A10B»: какое число считается#
В названии два числа. По карточке модели, всего в ней 122B параметров, а на каждый токен активны 10B. Это модель со смесью экспертов: внутри много небольших специализированных подсетей, и для каждого токена маршрутизатор будит лишь несколько из них.
Представьте библиотеку со 122 полками, где на любой вопрос вы идёте только к десяти. Читать приходится немного, но вся библиотека всё равно должна стоять в здании: какие полки понадобятся для следующего слова, заранее неизвестно.
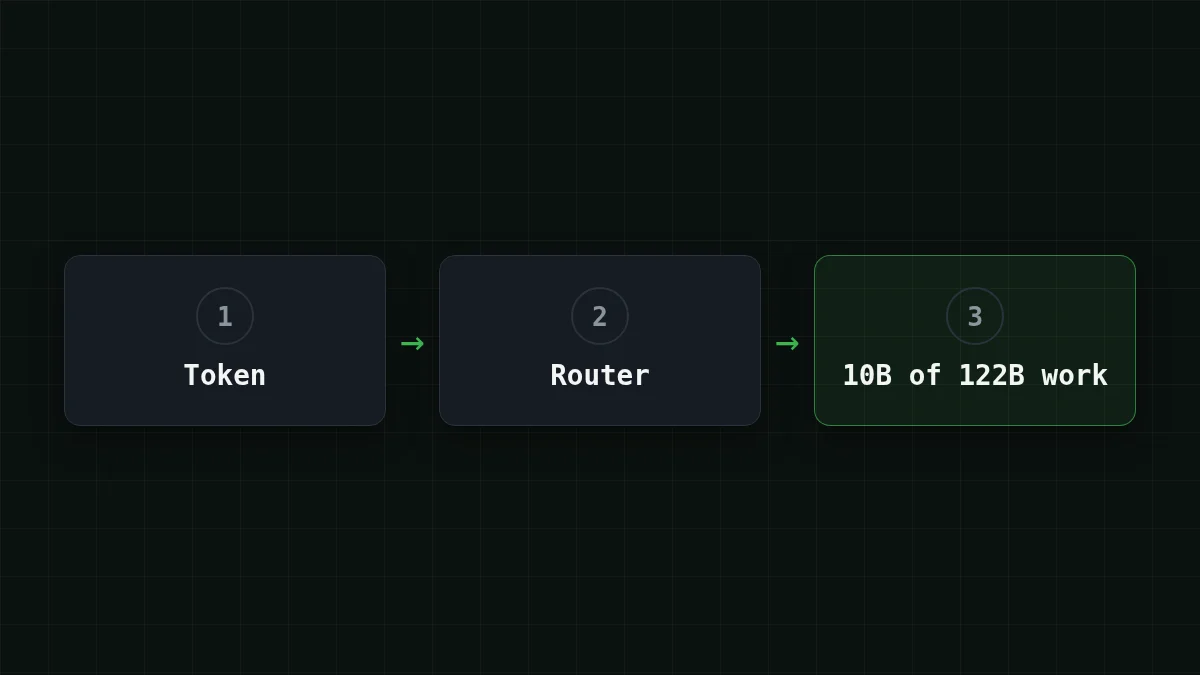
Итак: память следует за общим числом, вычисления — за активным. Десять миллиардов активных параметров делают токен дешёвым для расчёта, но не для хранения. Как быстро работает схема, где часть экспертов лежит в оперативной памяти или на диске, зависит от вашей памяти, диска и программы. Честной единой цифры нет, поэтому с подозрением относитесь к любому заголовку, где она названа.
Быстрая проверка
Модель называется 122B-A10B. Какое число примерно задаёт, сколько памяти нужно её весам?
Показать ответ
Ответ: 122B параметров всего
Хранить надо всех экспертов: маршрутизатор может выбрать любого для следующего токена. Число 10B говорит лишь, сколько работы стоит один токен.
Второй счёт: кэш контекста#
Веса — постоянная часть. Вторая часть растёт по ходу диалога. Чтобы не перечитывать всю переписку заново для каждого нового токена, модель хранит заметки по каждому уже увиденному токену: это KV-кэш (ключи и значения). Чем длиннее контекст, тем больше кэш. Если нужен разбор контекста с нуля, есть отдельная статья про контекстное окно.
На один токен кэш занимает: 2 × слои × KV-головы × размер головы × байты. Допустим, у модели 48 слоёв, 8 KV-голов, размер головы 128 и кэш в 16 бит (форма условная, не из карточки какой-либо модели):
- один токен: 2 × 48 × 8 × 128 × 2 = 196608 байт, около 0,2 МБ
- 32 768 токенов: 196608 × 32768 = 6442450944 байт, около 6,4 ГБ
- 131 072 токена (128K): 196608 × 131072 = 25769803776 байт, около 25,8 ГБ
На 128K один только кэш больше всей карты. Ваши настоящие числа лежат в config.json модели (слои, KV-головы, размер головы), а некоторые архитектуры хранят кэш заметно компактнее — так что это метод, а не приговор конкретной модели.
Карточка Qwen3.5-122B-A10B показывает, как выглядит большой масштаб: в примерах запуска используется тензорный параллелизм на 8 GPU при полном контексте в 262 144 токена. Если памяти не хватает, она советует сократить контекст, но оставить не меньше 128K, чтобы сохранить способность рассуждать, а флаг vLLM - пропускает визуальный энкодер и освобождает память под кэш.
Своя оценка в дюжине строк#
Сложим обе части:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9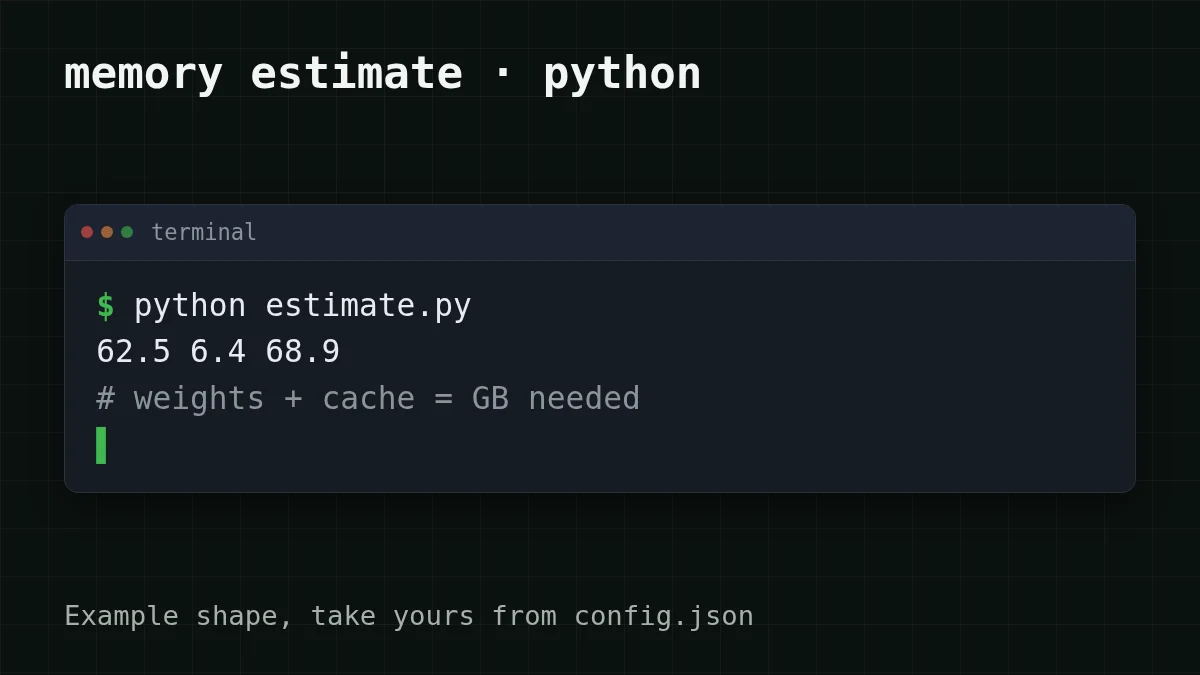
Теперь проверка реальностью. Допустим, рядом с картой на 16 ГБ у вас 32 ГБ оперативной памяти: 16 + 32 = 48 ГБ, а скрипт выдал 68,9 ГБ. Вытеснять придётся и на диск, и большая модель будет работать в основном из хранилища, а не из карты.
Когда проще взять API#
Большая модель на вашем столе нужна не каждой задаче. Что ближе к вашему случаю?
Выберите свой случай
Что ближе к вашему случаю?
Выберите вариант, чтобы увидеть ответ
Хочу посмотреть, как модель работает на моём компьютере
Возьмите небольшую: в 4 бита модель на 7B занимает под веса около 7 × 0,5 = 3,5 ГБ, то есть помещается в карту на 16 ГБ с запасом на длинный чат. Разбираться, как ведут себя модели, — лучший повод запускать локально. Смотрите также локально или API на примере DeepSeek.
Несколько тысяч запросов в месяц, и нужна сильная модель
Отправляйте их в API. Не нужно покупать или арендовать память, ничего не нужно ставить, а счёт — только за реально использованные токены.
Длинные документы или агент с длинной историей
Растёт именно кэш, и на своём железе он борется с весами за ту же память. С API окно контекста — не ваша забота: DeepSeek-V4-Flash и GLM-5.3-Flash в CheapTokens принимают 380K и 390K токенов.
Как это выглядит на практике. Допустим, поддержка суммаризирует 3 000 тикетов в месяц, по 2 000 токенов на входе и 400 на выходе. За месяц это 2000 × 3000 = 6000000 входных и 400 × 3000 = 1200000 выходных токенов. В DeepSeek-V4-Flash вход стоит $0.015, выход — $0.10 за 1M токенов, и весь месяц выходит в $0.21. Таблица ниже показывает ту же нагрузку по всем моделям, рядом столбец OpenRouter, чтобы сравнивать в сумме, вход и выход вместе:
| Модель | Вход $/1M | Выход $/1M | За запрос | 3 000 запросов | OpenRouter, 3 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2 000 входных и 400 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Сам запрос — обычный вызов в стиле OpenAI, как к любому провайдеру. Базовый адрес — https:/, id модели — полный deepseek-:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
В ответе есть блок usage с числом входных и выходных токенов, так что после первых десятка тикетов вы сверите оценку выше со своими данными. DeepSeek-V4-Flash даёт до 32 768 токенов в одном ответе по одной цене в любое время суток, а GLM-5.3-Flash — более лёгкий вариант на каждый день, до 8 192 токенов. Подробности настройки — в документации, страница модели — дешёвый DeepSeek, полный прайс — на странице цен.
В следующий раз, когда рядом с названием модели стоит размер, у вас есть три шага: умножить, добавить кэш, сравнить с картой.


