Maaari bang tumakbo ang isang 125B na modelo sa isang 16 GB na GPU? Ang matematika ng memorya
Gaano karaming memorya ang kailangan ng isang 125B open model: mga timbang, quantization at KV cache sa ilang linya ng matematika, at kung kailan ang API ang mas simpleng paraan upang gamitin ito.
Sa pahinang ito
Maikling sagot: hindi. Ang 125B-parameter na modelo ay nangangailangan ng humigit-kumulang 62.5 GB para sa mga timbang nito kahit pagkatapos ng 4-bit compression, at ang 16 GB na graphics card ay may hawak na mga isang-kapat nito. Maaari mo pa rin itong simulan sa pamamagitan ng pagtulak sa natitira sa system RAM o sa disk, ngunit hindi na ang card ang magpapasya kung paano tatakbo ang mga bagay.
Sa ibaba: kung paano mo makukuha ang numerong iyon sa ilang linya, ano ang tunay na sinasabi ng “122B-A10B” sa pangalan ng modelo, at kung kailan ang pagpapadala ng mga kahilingan sa isang API ang mas simpleng paraan upang gumamit ng malaking modelo.
Mga Timbang: parameter na beses bytes#
Isipin ang isang modelo bilang isang malaking tumpok ng mga numero, na tinatawag na mga timbang o parameter. Upang sagutin ka, kailangan ng computer ang lahat ng ito sa mabilis na memorya nang sabay-sabay. Kaya ang unang pagtatantya ay simpleng multiplikasyon: parameter sa bilyon × bytes bawat timbang = gigabytes. Ang isang timbang ay tumatagal ng 2 bytes sa 16-bit, 1 byte sa 8-bit at 0.5 byte sa 4-bit. Iyon lang ang ginagawa ng quantization: mas kaunting bits bawat numero.
Kunin ang isang modelo ng klase na ito, Qwen3.5-122B-A10B. Ang Hugging Face page nito (sinuri noong 30 Oktubre 2026) ay nagpangalan ng Apache-2.0 bilang lisensya, inilathala ang mga timbang bilang BF16 at F32, at inilista ang laki bilang 125B parameter. Para sa 125B:
- Sa 16 bits: 125 × 2 = 250 GB
- Sa 8 bits: 125 × 1 = 125 GB
- Sa 4 bits: 125 × 0.5 = 62.5 GB
- Sa 2 bits: 125 × 0.25 = 31.25 GB
Kahit ang 2-bit na linya ay halos dalawang beses ang card. At ang mga ito ay sahig, hindi kabuuan: hindi nila isinasama ang context cache (susunod na seksyon) at ang sariling overhead ng runtime, at ang mga tunay na quantized na format ay nagdaragdag ng kaunti sa itaas.
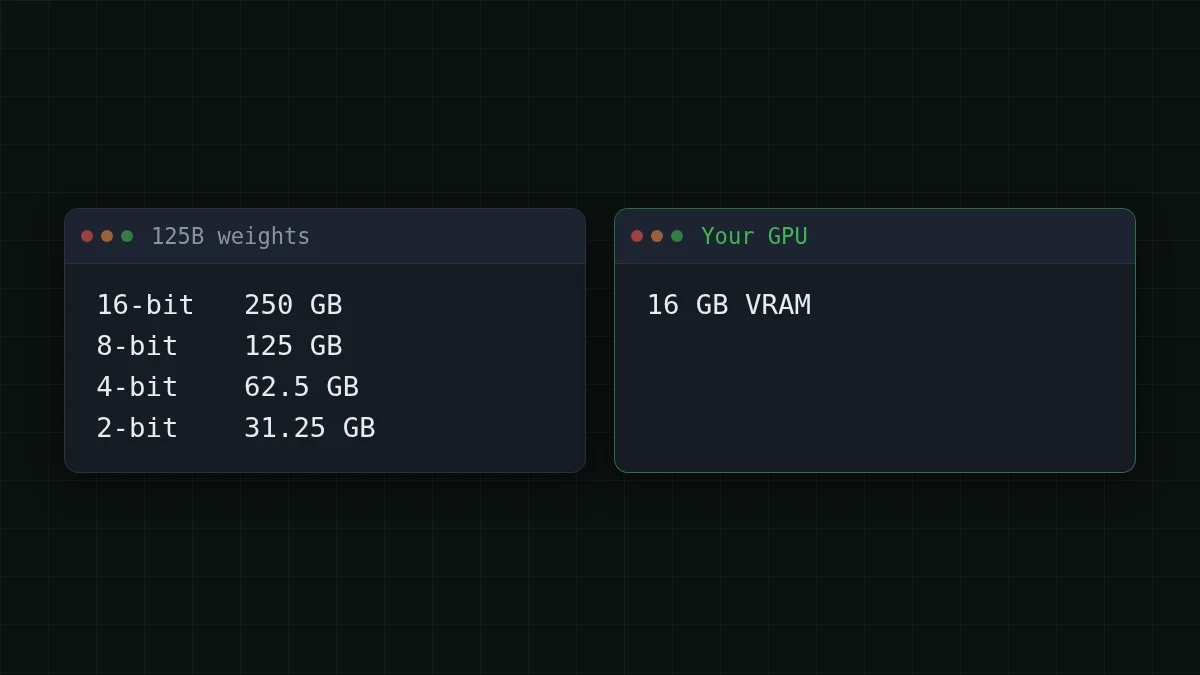
Baliktarin ang formula upang makita kung ano ang kayang hawakan ng 16 GB na card. Sa 4-bit iyon ay 16 / 0.5 = 32 bilyong parameter, at iyon ang kisame bago pa may iba pang kailangan ng espasyo. Subukan mo mismo ang sum:
Hulaan ang numero
Ilang GB ang kinakailangan ng mga timbang ng isang 32B na modelo sa 4-bit?
Ang iyong hula
0100
Ipakita ang sagot
Sagot: 16
32 × 0.5 = 16 GB. Puno na ang card bago pa man basahin ng modelo ang isang salita ng iyong tanong, kaya 32B ang bubong para sa isang 16 GB na card at ang mga komportableng laki ay mas mababa.
“122B-A10B”: aling numero ang binibilang#
Ang pangalan ay may dalawang numero. Ayon sa model card, ang modelo ay may 122B parameter sa kabuuan at 10B aktibo para sa bawat token. Ito ay isang mixture-of-experts na modelo: sa loob ay maraming maliliit na espesyalistang sub-network, at para sa bawat token isang router ang gumising lamang ng ilan sa kanila.
Isipin ang isang aklatan na may 122 shelf kung saan ang anumang solong tanong ay magpapadala sa iyo sa 10 sa kanila. Maliit ang iyong pagsisikap sa pagbabasa, ngunit ang buong aklatan ay kailangan pa ring nasa loob ng gusali, dahil hindi mo malalaman kung aling mga shelf ang kakailanganin ng susunod na salita.
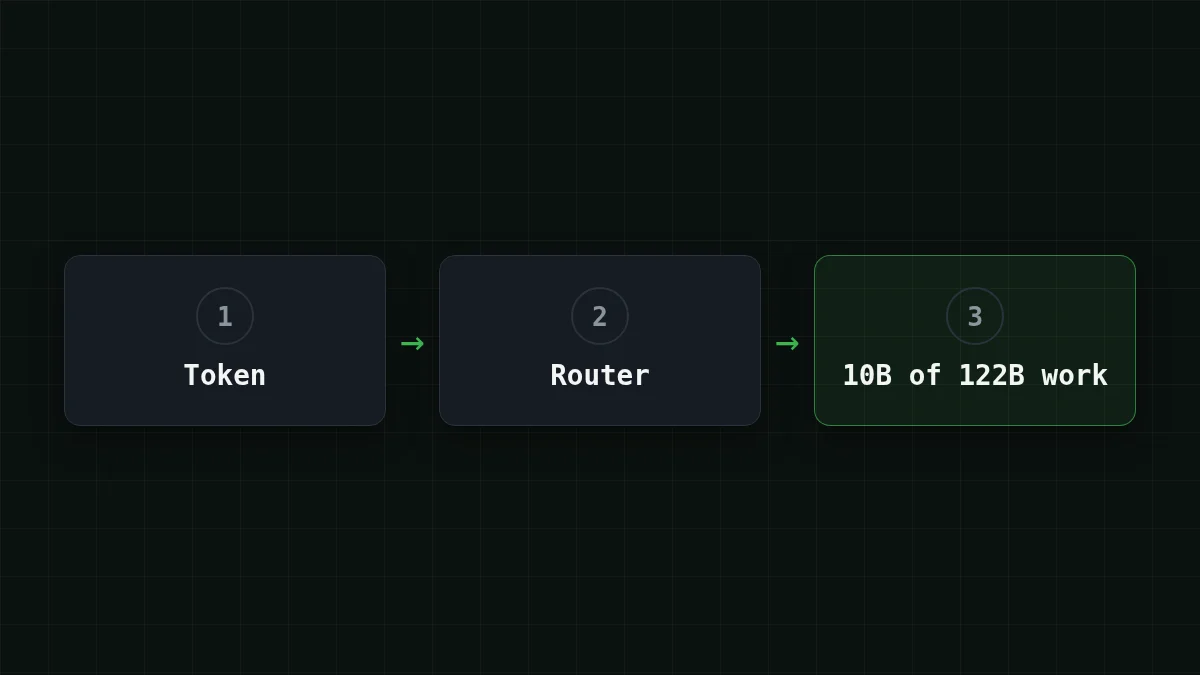
Kaya: ang memorya ay sumusunod sa kabuuan, ang compute ay sumusunod sa aktibo. Sampung bilyong aktibong parameter ang gumagawa ng isang token na mura sa compute, hindi mura sa storage. Kung gaano kabilis tumakbo ang isang setup na nagpapanatili ng bahagi ng mga expert sa RAM o sa disk ay depende sa iyong RAM, disk at software. Walang tapat na solong pigura, kaya mag-ingat sa anumang headline na nagbibigay nito.
Mabilisang pagsusuri
Ang isang modelo ay tinatawag na 122B-A10B. Aling numero ang halos nagtatakda kung gaano karaming memorya ang kailangan ng mga timbang nito?
Ipakita ang sagot
Sagot: Ang 122B na kabuuang parameter
Lahat ng expert ay dapat na naka-imbak, dahil ang router ay maaaring pumili ng alinman sa kanila para sa susunod na token. Ang 10B ay nagsasabi lamang kung gaano karaming trabaho ang kinakailangan ng isang token.
Ang pangalawang bayarin: ang context cache#
Ang mga timbang ay ang fixed na bahagi. Ang iba pang bahagi ay lumalaki habang nag-uusap kayo. Upang maiwasan ang muling pagbasa ng buong usapan para sa bawat bagong token, ang modelo ay nagpapanatili ng mga tala sa bawat token na nakita na nito: ang KV cache (mga key at value). Mas mahaba ang context, mas malaki ang cache. Kung gusto mong ipaliwanag mula sa simula ang panig ng context, mayroong hiwalay na gabay sa context window.
Bawat token ang cache ay tumatagal ng: 2 × layers × KV heads × head size × bytes. Sabihin nating ang isang modelo ay may 48 layers, 8 KV heads, isang head size na 128 at isang 16-bit na cache (isang ipinapalagay na hugis, hindi ang mula sa anumang model card):
- isang token: 2 × 48 × 8 × 128 × 2 = 196608 bytes, mga 0.2 MB
- 32,768 token: 196608 × 32768 = 6442450944 bytes, mga 6.4 GB
- 131,072 token (128K): 196608 × 131072 = 25769803776 bytes, mga 25.8 GB
Sa 128K ang cache na iyon lamang ay mas malaki kaysa sa buong card. Ang iyong tunay na mga numero ay nasa config.json ng modelo (layers, KV heads, head size), at ang ilang arkitektura ay nagpapanatili ng cache na mas maliit, kaya ituring ito bilang ang paraan, hindi bilang hatol sa isang modelo.
Ang Qwen3.5-122B-A10B card ay nagpapakita kung ano ang hitsura ng malaking dulo: ang mga halimbawa ng serving nito ay gumagamit ng tensor parallelism sa 8 GPU sa buong 262,144-token na context. Kung maubos ang memorya, pinapayuhan nitong paikliin ang context habang pinapanatili ang hindi bababa sa 128K upang mapanatili ang pag-iisip, at ang vLLM flag na - ay lumalaktaw sa vision encoder upang magbakante ng memorya para sa cache.
Ang iyong sariling pagtatantya sa isang dosenang linya#
Pagsamahin ang dalawang bahagi:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9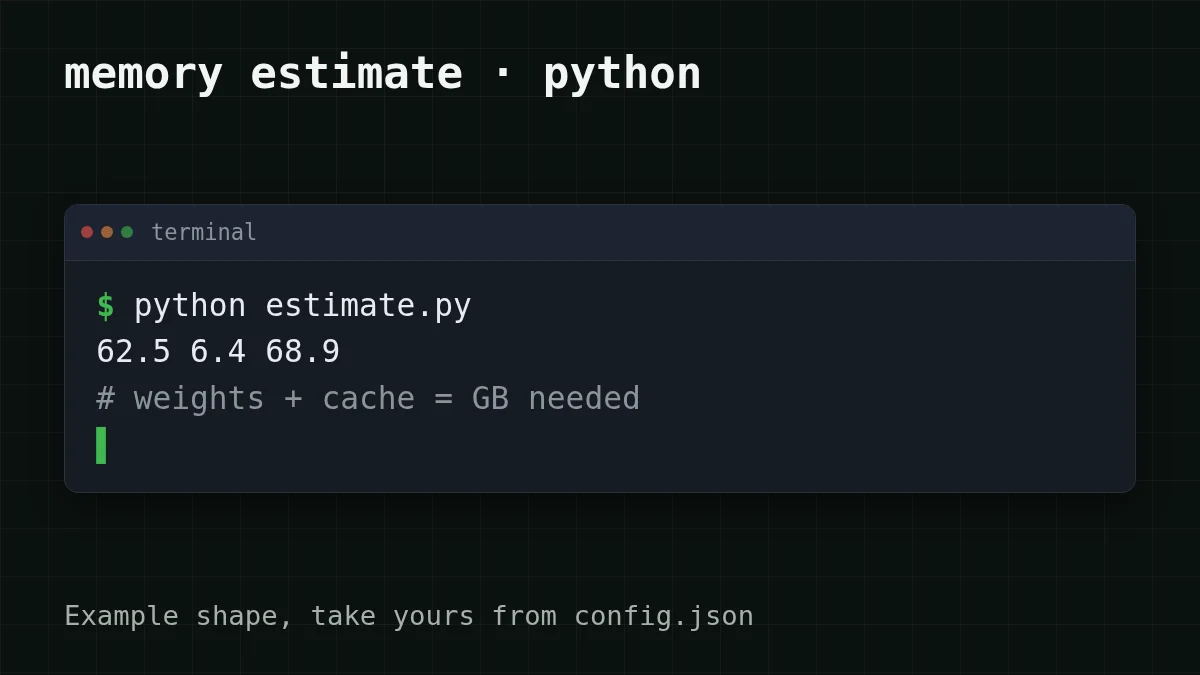
Ngayon ang reality check. Sabihin nating ang iyong PC ay may 32 GB na RAM katabi ng 16 GB na card: 16 + 32 = 48 GB, mas mababa pa rin sa 68.9 GB na inilimbag ng script. Ang offloading ay kailangang umabot din sa disk, at ikaw ay magpapatakbo ng isang malaking modelo na halos mula sa storage kaysa sa card.
Kailan ang API ang mas simpleng pagpipilian#
Hindi lahat ng gawain ay nangangailangan ng malaking modelo sa iyong mesa. Alin ang naglalarawan sa iyo?
Piliin ang iyong kaso
Alin ang pinakamalapit sa iyong kaso?
Pumili ng opsyon upang makita ang sagot
Gusto kong makita ang isang modelo na tumatakbo sa sarili kong makina
Pumili ng maliit: sa 4-bit, ang isang 7B na modelo ay tumatagal ng mga 7 × 0.5 = 3.5 GB para sa mga timbang, kaya kasya ito sa isang 16 GB na card na may espasyo para sa mahabang usapan. Ang pag-aaral kung paano kumilos ang mga modelo ay ang pinakamagandang dahilan upang tumakbo nang lokal. Tingnan din ang lokal o API para sa DeepSeek.
Ilang libong kahilingan sa isang buwan, at gusto ko ng malakas na modelo
Ipadala ang mga ito sa isang API. Laktawan mo ang pagbili o pag-upa ng memorya, walang i-install, at ang bayarin ay para lamang sa mga token na aktwal mong ginagamit.
Mahahabang dokumento o isang agent na nagpapanatili ng mahabang kasaysayan
Ang cache ang bahaging lumalaki, at sa iyong sariling hardware ito ay nakikipagkumpitensya sa mga timbang para sa parehong memorya. Sa isang API ang context window ay problema ng iba: ang DeepSeek-V4-Flash at GLM-5.3-Flash sa CheapTokens ay tumatanggap ng 380K at 390K token.
Ano ang hitsura nito sa pagsasanay. Sabihin nating ang isang support bot ay nagbubuod ng 3,000 ticket sa isang buwan, bawat isa ay mga 2,000 token papasok at 400 token palabas. Sa buong buwan iyon ay 2000 × 3000 = 6000000 input token at 400 × 3000 = 1200000 output token. Sa DeepSeek-V4-Flash, ang input ay nagkakahalaga ng $0.015 at output $0.10 bawat 1M token, kaya ang buong buwan ay umabot sa $0.21. Ang talahanayan sa ibaba ay nagpapakita ng parehong load sa bawat modelo, kasama ang OpenRouter column sa tabi nito upang maihambing mo sa kabuuan, input at output nang magkasama:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 3,000 mga kahilingan | OpenRouter, 3,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2,000 input at 400 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Ang kahilingan mismo ay ang parehong OpenAI-style na tawag na gagawin mo sa anumang provider. Ang base URL ay https:/, at ang model id ay ang buong deepseek-:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
Ang tugon ay nagdadala ng usage block na may input at output token counts, upang masuri mo ang pagtatantya sa itaas laban sa iyong sariling mga ticket pagkatapos ng unang dosena. Ang DeepSeek-V4-Flash ay nagbibigay sa iyo ng hanggang 32,768 output token bawat sagot sa isang presyo sa buong araw, at ang GLM-5.3-Flash ay ang mas magaan na pang-araw-araw na opsyon na may hanggang 8,192. Ang mga detalye ng setup ay nasa docs, ang model page ay murang DeepSeek, at ang buong listahan ng presyo ay nasa pricing page.
Sa susunod na ang isang pangalan ng modelo ay may kasamang laki, mayroon ka nang tatlong hakbang: i-multiply, idagdag ang cache, ihambing sa card.


