AI per principiantiGuida
Un modello da 125B può girare su una GPU da 16 GB? La matematica della memoria
Quanta memoria serve a un modello aperto da 125B: pesi, quantizzazione e cache KV in poche righe di calcolo, e quando un'API è il modo più semplice per usarlo.
In questa pagina
Risposta breve: no. Un modello da 125 miliardi di parametri richiede circa 62,5 GB per i suoi pesi anche dopo la compressione a 4 bit, e una scheda grafica da 16 GB ne contiene circa un quarto. Puoi comunque avviarlo spingendo il resto nella RAM di sistema o sul disco, ma a quel punto la scheda non è più ciò che decide come vanno le cose.
Di seguito: come ricavare quel numero da solo in poche righe, cosa ti dice davvero "122B-A10B" nel nome di un modello e quando inviare richieste a un'API è il modo più semplice per usare un modello grande.
Pesi: parametri per byte#
Immagina un modello come un enorme mucchio di numeri, chiamati pesi o parametri. Per risponderti, il computer deve averli tutti in memoria veloce contemporaneamente. Quindi la prima stima è una semplice moltiplicazione: parametri in miliardi × byte per peso = gigabyte. Un peso occupa 2 byte a 16 bit, 1 byte a 8 bit e 0,5 byte a 4 bit. È tutto ciò che fa la quantizzazione: meno bit per numero.
Prendi un modello di questa classe, Qwen3.5-122B-A10B. La sua pagina su Hugging Face (verificata il 30 ottobre 2026) indica Apache-2.0 come licenza, pubblica i pesi in BF16 e F32 e riporta la dimensione come 125B parametri. Per 125B:
- A 16 bit: 125 × 2 = 250 GB
- A 8 bit: 125 × 1 = 125 GB
- A 4 bit: 125 × 0,5 = 62,5 GB
- A 2 bit: 125 × 0,25 = 31,25 GB
Anche la riga a 2 bit è quasi il doppio della scheda. E questi sono minimi, non totali: escludono la cache del contesto (sezioni successive) e l'overhead del runtime stesso, e i formati quantizzati reali aggiungono un po' in più.
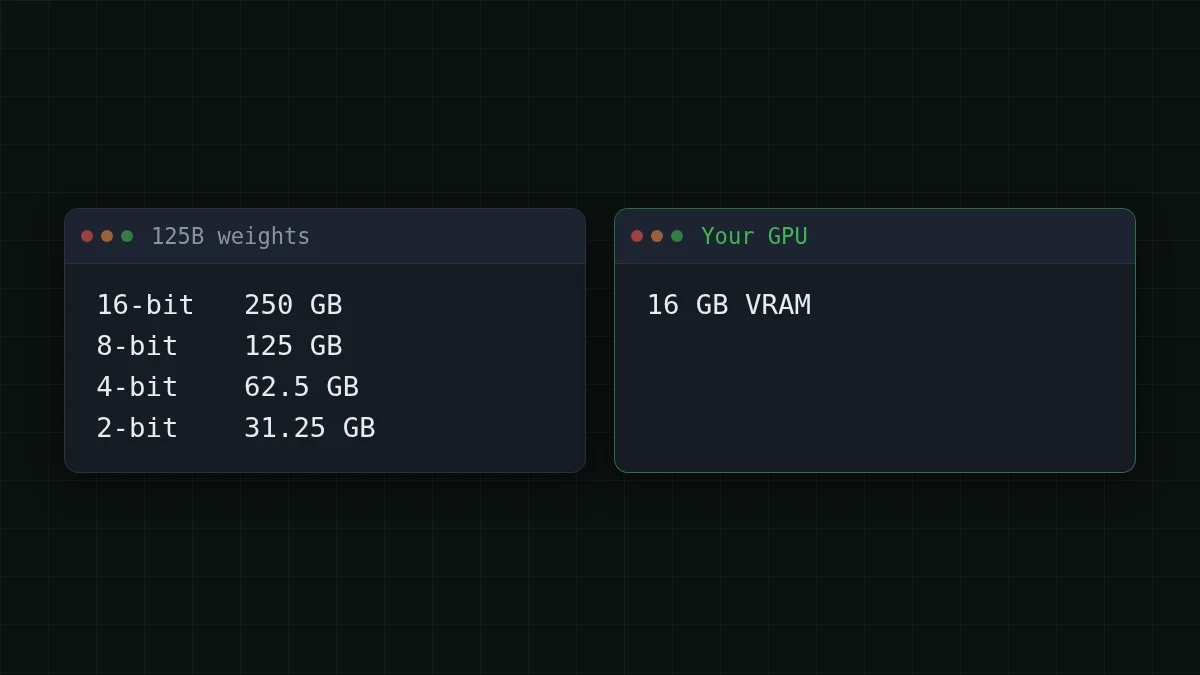
Inverti la formula per vedere cosa può contenere una scheda da 16 GB. A 4 bit sono 16 / 0,5 = 32 miliardi di parametri, e questo è il tetto prima che qualcos'altro debba trovare spazio. Prova il calcolo da solo:
Indovina il numero
Quanti GB occupano i pesi di un modello da 32B a 4 bit?
La tua risposta
0100
Mostra risposta
Risposta: 16
32 × 0,5 = 16 GB. La scheda è piena prima che il modello abbia letto una sola parola della tua domanda, quindi 32B è il tetto per una scheda da 16 GB e le dimensioni comode stanno più in basso.
"122B-A10B": quale numero conta#
Il nome racchiude due numeri. Secondo la model card, il modello ha 122B parametri in totale e 10B attivi per ogni token. È un modello mixture-of-experts: all'interno ci sono molte piccole sottoreti specializzate, e per ogni token un router ne risveglia solo alcune.
Pensa a una biblioteca con 122 scaffali in cui ogni singola domanda ti manda su 10 di essi. Il tuo sforzo di lettura è piccolo, ma l'intera biblioteca deve comunque stare nell'edificio, perché non puoi sapere quali scaffali serviranno per la parola successiva.
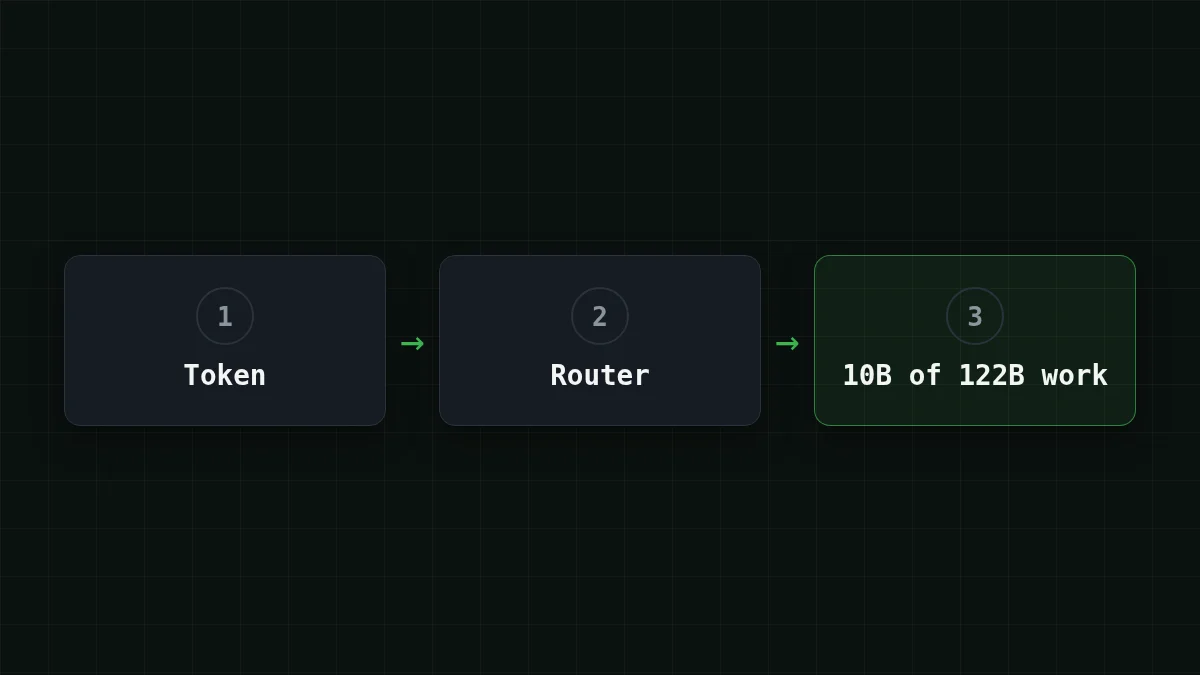
Quindi: la memoria segue il totale, il calcolo segue gli attivi. Dieci miliardi di parametri attivi rendono un token economico da calcolare, non economico da memorizzare. La velocità di una configurazione che tiene parte degli esperti in RAM o su disco dipende dalla tua RAM, dal disco e dal software. Non esiste un singolo valore onesto, quindi diffida di qualsiasi titolo che ne fornisca uno.
Verifica rapida
Un modello si chiama 122B-A10B. Quale numero determina approssimativamente quanta memoria servono i suoi pesi?
Mostra risposta
Risposta: I 122B parametri totali
Tutti gli esperti devono essere memorizzati, perché il router può sceglierne uno qualsiasi per il token successivo. I 10B ti dicono solo quanto lavoro richiede un token.
Il secondo conto: la cache del contesto#
I pesi sono la parte fissa. L'altra parte cresce mentre chatti. Per evitare di rileggere l'intera conversazione a ogni nuovo token, il modello conserva appunti su ogni token già visto: la cache KV (chiavi e valori). Contesto più lungo, cache più grande. Se vuoi che il lato contesto sia spiegato da zero, c'è una guida separata alla finestra di contesto.
Per token la cache occupa: 2 × layer × KV head × dimensione head × byte. Supponiamo che un modello abbia 48 layer, 8 KV head, una dimensione head di 128 e una cache a 16 bit (una forma ipotetica, non quella di nessuna model card):
- un token: 2 × 48 × 8 × 128 × 2 = 196608 byte, circa 0,2 MB
- 32.768 token: 196608 × 32768 = 6442450944 byte, circa 6,4 GB
- 131.072 token (128K): 196608 × 131072 = 25769803776 byte, circa 25,8 GB
A 128K quella sola cache è più grande dell'intera scheda. I tuoi numeri reali sono nel config.json del modello (layer, KV head, dimensione head), e alcune architetture mantengono la cache molto più piccola, quindi trattalo come il metodo, non come un verdetto su un singolo modello.
La card di Qwen3.5-122B-A10B mostra come appare il lato grande: i suoi esempi di serving usano il tensor parallelism su 8 GPU al contesto completo di 262.144 token. Se la memoria si esaurisce, consiglia di accorciare il contesto mantenendo almeno 128K per preservare il thinking, e il flag vLLM - salta l'encoder vision per liberare memoria per la cache.
La tua stima in una dozzina di righe#
Metti insieme le due parti:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9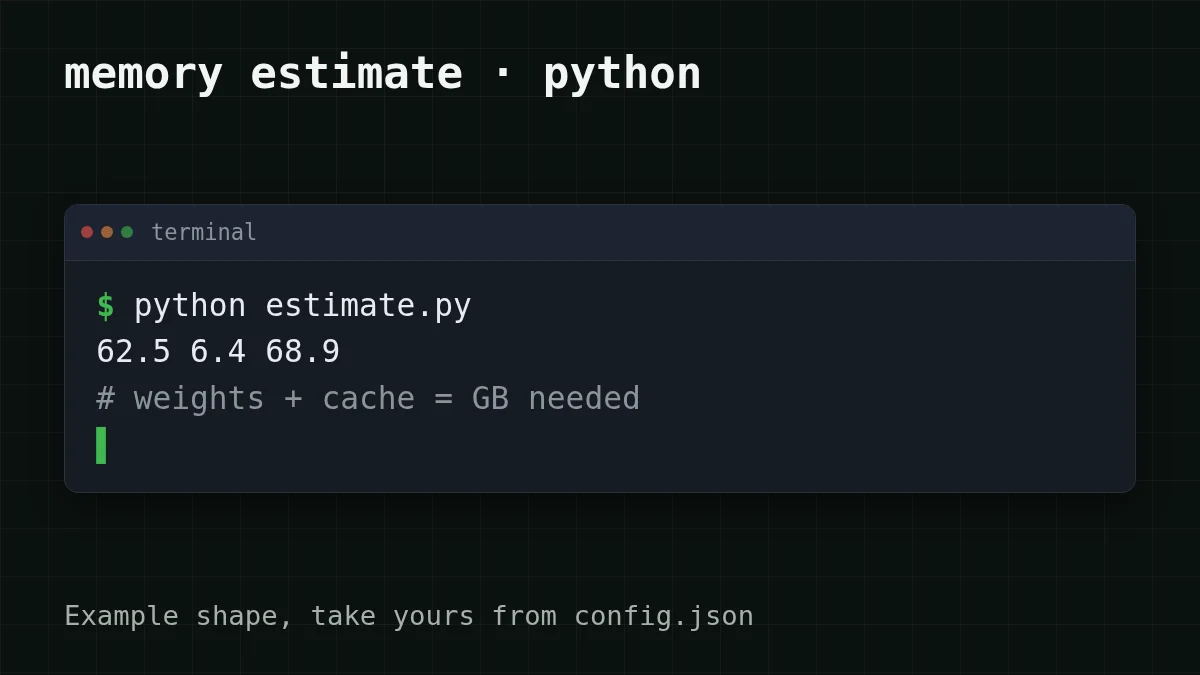
Ora il controllo di realtà. Supponiamo che il tuo PC abbia 32 GB di RAM accanto alla scheda da 16 GB: 16 + 32 = 48 GB, ancora sotto i 68,9 GB stampati dallo script. L'offloading dovrebbe ricorrere anche al disco, e starai eseguendo un modello grande principalmente dallo storage anziché dalla scheda.
Quando un'API è la scelta più semplice#
Non ogni attività richiede un modello grande sulla tua scrivania. Quale ti descrive?
Scegli il tuo caso
Quale è più vicino al tuo caso?
Scegli un'opzione per vedere la risposta
Voglio vedere un modello girare sulla mia macchina
Scegline uno piccolo: a 4 bit, un modello da 7B occupa circa 7 × 0,5 = 3,5 GB per i pesi, quindi sta in una scheda da 16 GB con spazio per una lunga chat. Imparare come si comportano i modelli è il motivo migliore per eseguirli in locale. Vedi anche locale o API per DeepSeek.
Poche migliaia di richieste al mese, e voglio un modello forte
Inviale a un'API. Eviti di comprare o affittare memoria, non c'è nulla da installare e il conto è solo per i token che usi davvero.
Documenti lunghi o un agente che mantiene una lunga cronologia
La cache è la parte che cresce, e sul tuo hardware compete con i pesi per la stessa memoria. Con un'API la finestra di contesto è un problema di qualcun altro: DeepSeek-V4-Flash e GLM-5.3-Flash su CheapTokens arrivano a 380K e 390K token.
Come appare in pratica. Supponiamo che un bot di supporto riassuma 3.000 ticket al mese, ciascuno con circa 2.000 token in input e 400 token in output. Nell'arco del mese sono 2000 × 3000 = 6000000 token di input e 400 × 3000 = 1200000 token di output. Su DeepSeek-V4-Flash, l'input costa $0.015 e l'output $0.10 per 1M token, quindi l'intero mese arriva a $0.21. La tabella qui sotto mostra lo stesso carico su ogni modello, con la colonna OpenRouter accanto per confrontare il totale, input e output insieme:
| Modello | Input $/1M | Output $/1M | Per richiesta | 3000 richieste | OpenRouter, 3000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2000 token di input e 400 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
La richiesta stessa è la stessa chiamata in stile OpenAI che faresti a qualsiasi provider. L'URL di base è https:/ e l'id del modello è il deepseek- completo:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
La risposta contiene un blocco usage con i conteggi dei token di input e output, così puoi verificare la stima sopra con i tuoi ticket dopo la prima dozzina. DeepSeek-V4-Flash ti dà fino a 32.768 token di output per risposta a un prezzo costante tutto il giorno, e GLM-5.3-Flash è l'opzione quotidiana più leggera con fino a 8.192. I dettagli di configurazione sono nella documentazione, la pagina del modello è DeepSeek economico e il listino completo è nella pagina dei prezzi.
La prossima volta che un nome di modello arriva con una dimensione, hai i tre passaggi: moltiplica, aggiungi la cache, confronta con la scheda.


