Yeni başlayanlar için AIKılavuz
125B'lik bir model 16 GB'lık GPU'da çalışır mı? Bellek matematiği
125B'lik açık bir modelin ne kadar bellek gerektirdiği: birkaç satır matematikle ağırlıklar, niceleme ve KV önbelleği ve kullanmanın daha basit yolu olarak API'nin ne zaman uygun olduğu.
Bu sayfada
Kısa cevap: hayır. 125B parametreli bir model, 4-bit sıkıştırmadan sonra bile ağırlıkları için yaklaşık 62,5 GB gerektirir ve 16 GB'lık bir ekran kartı bunun yaklaşık dörtte birini tutar. Geri kalanını sistem RAM'ine veya diske iterek yine de başlatabilirsiniz, ancak o zaman işlerin nasıl gideceğine artık kart karar vermez.
Aşağıda: bu sayıyı birkaç satırda kendiniz nasıl elde edeceğiniz, bir model adındaki “122B-A10B”nin size gerçekte ne söylediği ve büyük bir modeli kullanmanın daha basit yolu olarak API'ye istek göndermenin ne zaman uygun olduğu.
Ağırlıklar: parametre çarpı bayt#
Bir modeli, ağırlık veya parametre adı verilen dev bir sayı yığını olarak düşünün. Size yanıt vermek için bilgisayarın hepsini aynı anda hızlı bellekte tutması gerekir. Yani ilk tahmin düz çarpımdır: milyarlarca parametre × ağırlık başına bayt = gigabayt. Bir ağırlık 16-bit'te 2 bayt, 8-bit'te 1 bayt ve 4-bit'te 0,5 bayt yer kaplar. Niceleme dediğiniz şey bundan ibarettir: sayı başına daha az bit.
Bu sınıftan bir model alın, Qwen3.5-122B-A10B. Hugging Face sayfası (30 Ekim 2026'da kontrol edildi) lisans olarak Apache-2.0 belirtir, ağırlıkları BF16 ve F32 olarak yayınlar ve boyutu 125B parametre olarak listeler. 125B için:
- 16 bit'te: 125 × 2 = 250 GB
- 8 bit'te: 125 × 1 = 125 GB
- 4 bit'te: 125 × 0,5 = 62,5 GB
- 2 bit'te: 125 × 0,25 = 31,25 GB
2-bit satırı bile kartın neredeyse iki katı. Ve bunlar taban değerler, toplamlar değil: bağlam önbelleğini (sonraki bölümler) ve çalışma zamanının kendi ek yükünü hesaba katmazlar ve gerçek nicelenmiş formatlar üstüne biraz daha ekler.
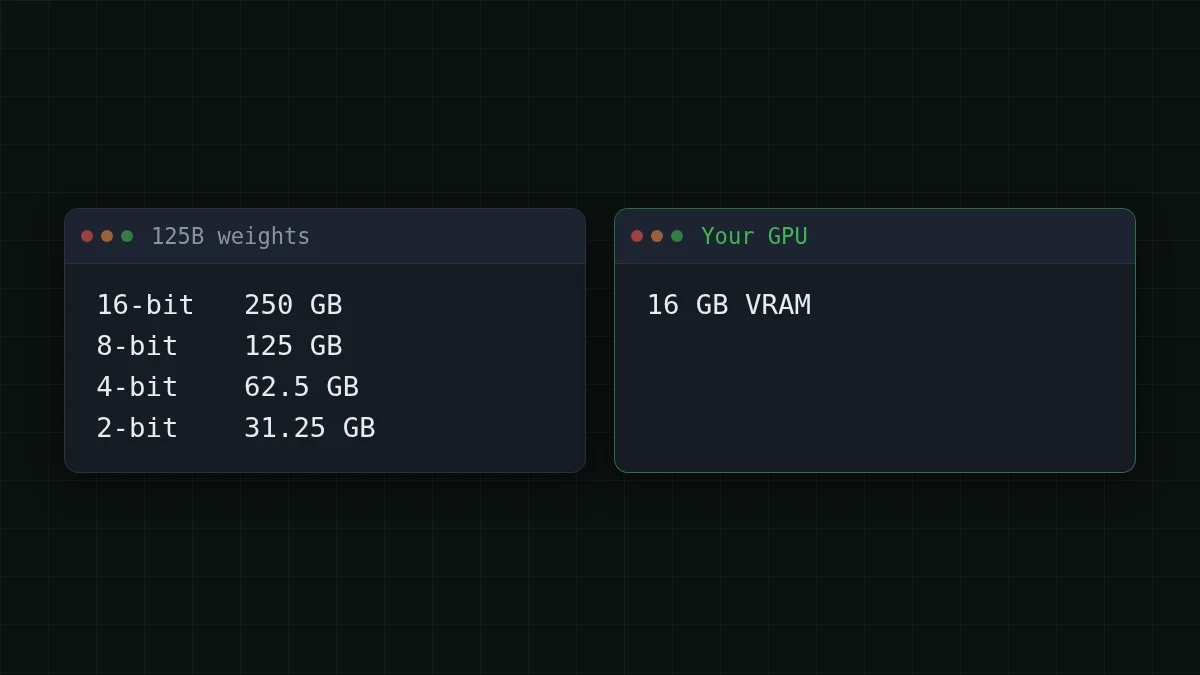
16 GB'lık bir kartın neleri tutabileceğini görmek için formülü ters çevirin. 4-bit'te bu 16 / 0,5 = 32 milyar parametredir ve başka hiçbir şeyin yer ihtiyacı olmadan önceki tavan budur. Toplamı kendiniz deneyin:
Sayıyı tahmin et
32B'lik bir modelin ağırlıkları 4-bit'te kaç GB yer kaplar?
Tahminin
0100
Cevabı göster
Cevap: 16
32 × 0,5 = 16 GB. Model sorunuzun tek bir kelimesini okumadan kart dolar, yani 16 GB'lık bir kart için tavan 32B'dir ve rahat boyutlar daha aşağıdadır.
“122B-A10B”: hangi sayı önemli#
Ad iki sayıyı bir arada taşır. Model kartına göre modelin toplamda 122B parametresi ve her token için 10B aktif parametresi vardır. Bu bir uzmanlar karışımı modelidir: içinde birçok küçük uzman alt ağ vardır ve her token için bir yönlendirici bunlardan yalnızca birkaçını uyandırır.
122 raflı bir kütüphane düşünün; herhangi bir soru sizi bunlardan 10'una gönderir. Okuma çabanız azdır, ancak bir sonraki kelimenin hangi raflara ihtiyaç duyacağını bilemeyeceğiniz için tüm kütüphanenin hâlâ binanın içinde olması gerekir.
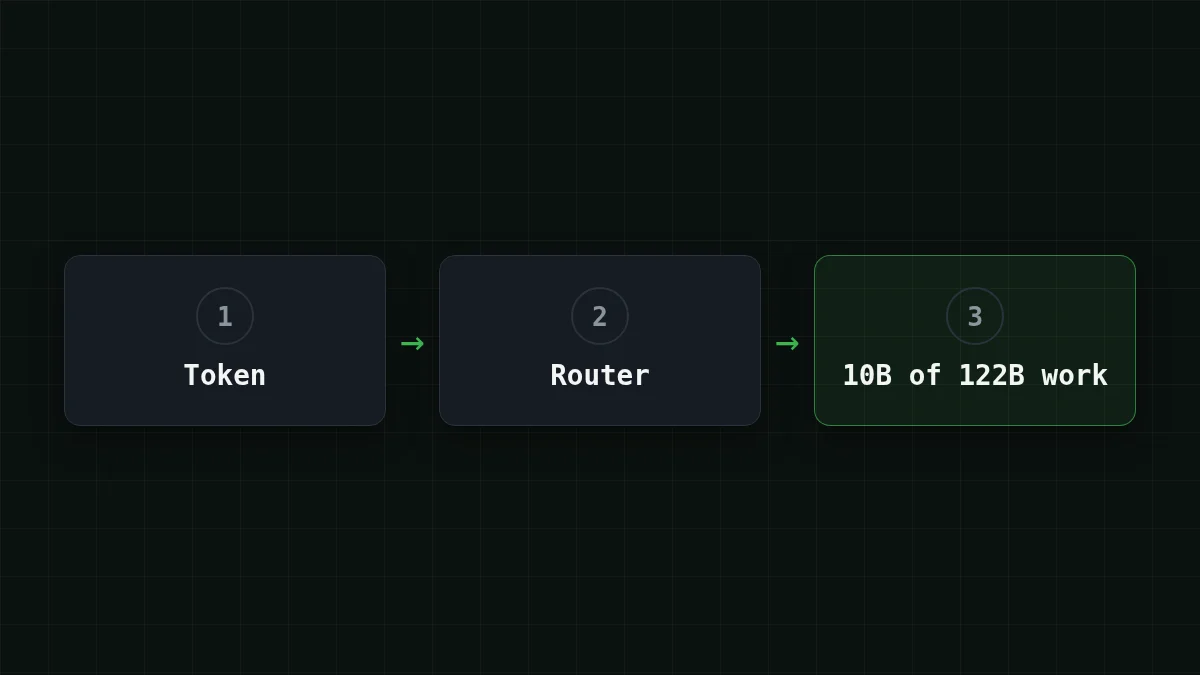
Yani: bellek toplamı izler, hesaplama aktif olanı izler. On milyar aktif parametre bir token'ı hesaplaması ucuz yapar, depolaması ucuz değil. Uzmanların bir kısmını RAM'de veya diskte tutan bir kurulumun ne kadar hızlı çalışacağı RAM'inize, diskinize ve yazılımınıza bağlıdır. Dürüst tek bir rakam yoktur, bu yüzden tek bir rakam veren her manşete karşı dikkatli olun.
Hızlı kontrol
Bir modele 122B-A10B deniyor. Ağırlıklarının ne kadar bellek gerektirdiğini kabaca hangi sayı belirler?
Cevabı göster
Cevap: 122B toplam parametre
Tüm uzmanlar saklanmalıdır, çünkü yönlendirici bir sonraki token için herhangi birini seçebilir. 10B yalnızca bir token'ın ne kadar iş aldığını söyler.
İkinci fatura: bağlam önbelleği#
Ağırlıklar sabit kısımdır. Diğer kısım siz sohbet ettikçe büyür. Her yeni token için tüm konuşmayı yeniden okumaktan kaçınmak için model, daha önce gördüğü her token hakkında notlar tutar: KV önbelleği (anahtarlar ve değerler). Daha uzun bağlam, daha büyük önbellek. Bağlam tarafının sıfırdan anlatımını isterseniz, bağlam penceresi için ayrı bir rehber var.
Token başına önbellek şunu alır: 2 × katman × KV kafası × kafa boyutu × bayt. Diyelim ki bir modelde 48 katman, 8 KV kafası, 128 kafa boyutu ve 16-bit önbellek var (varsayımsal bir şekil, herhangi bir model kartından alınmamıştır):
- bir token: 2 × 48 × 8 × 128 × 2 = 196608 bayt, yaklaşık 0,2 MB
- 32.768 token: 196608 × 32768 = 6442450944 bayt, yaklaşık 6,4 GB
- 131.072 token (128K): 196608 × 131072 = 25769803776 bayt, yaklaşık 25,8 GB
128K'da yalnızca bu önbellek tüm karttan daha büyüktür. Gerçek sayılarınız modelin config.json dosyasındadır (katmanlar, KV kafaları, kafa boyutu) ve bazı mimariler önbelleği çok daha küçük tutar, bu yüzden bunu bir modele ilişkin hüküm değil, yöntem olarak ele alın.
Qwen3.5-122B-A10B kartı büyük ucun nasıl göründüğünü gösterir: sunum örnekleri, tam 262.144 token bağlamında 8 GPU üzerinde tensör paralelliği kullanır. Bellek tükenirse, düşünmeyi korumak için en az 128K tutarak bağlamı kısaltmayı önerir ve vLLM bayrağı -, önbellek için bellek boşaltmak üzere görüntü kodlayıcıyı atlar.
Bir düzine satırda kendi tahmininiz#
İki kısmı bir araya getirin:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9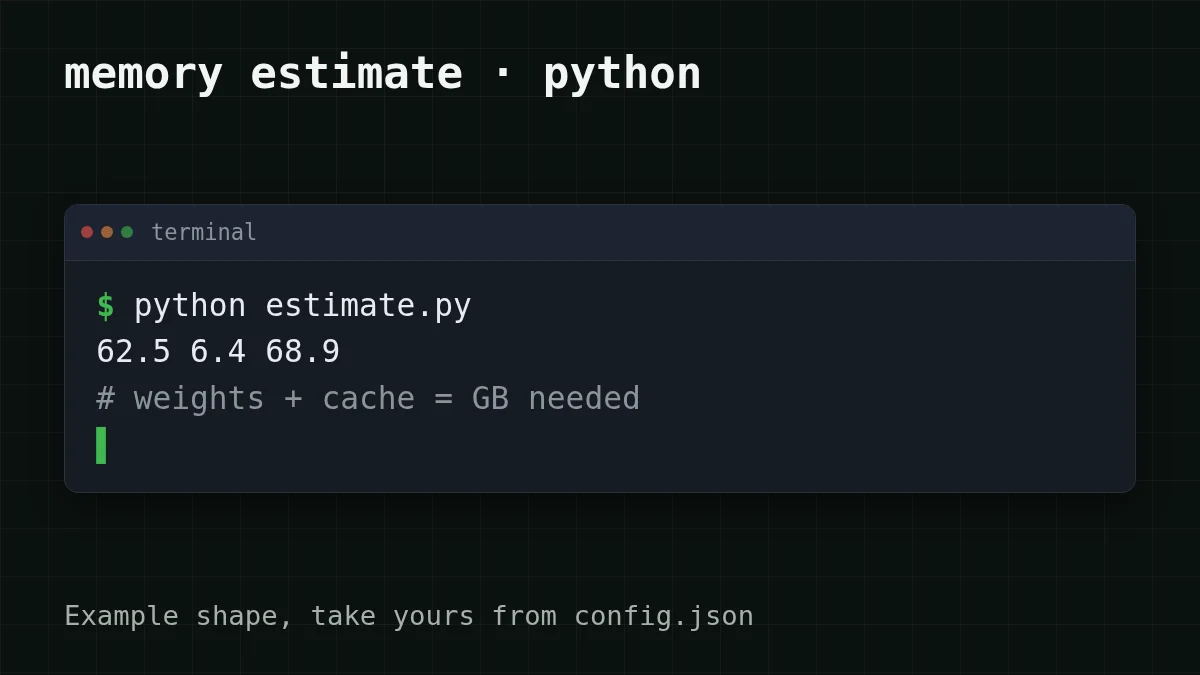
Şimdi gerçeklik kontrolü. Diyelim ki PC'nizde 16 GB'lık kartın yanında 32 GB RAM var: 16 + 32 = 48 GB, betiğin yazdırdığı 68,9 GB'ın hâlâ altında. Boşaltmanın diske de uzanması gerekirdi ve büyük bir modeli karttan çok depolama biriminden çalıştırıyor olurdunuz.
API'nin daha basit seçim olduğu durumlar#
Her görev masanızda büyük bir model gerektirmez. Hangisi sizi tanımlıyor?
Durumunu seç
Hangisi durumunuza en yakın?
Cevabı görmek için bir seçenek seçin
Bir modelin kendi makinemde çalıştığını görmek istiyorum
Küçük bir tane seçin: 4-bit'te 7B'lik bir model ağırlıklar için yaklaşık 7 × 0,5 = 3,5 GB alır, yani uzun bir sohbete yer bırakarak 16 GB'lık bir karta sığar. Modellerin nasıl davrandığını öğrenmek, yerel çalıştırmak için en iyi nedendir. Ayrıca bkz. DeepSeek için yerel mi API mi.
Ayda birkaç bin istek ve güçlü bir model istiyorum
Bunları bir API'ye gönderin. Bellek satın almayı veya kiralamayı atlarsınız, kurulacak bir şey yoktur ve fatura yalnızca gerçekten kullandığınız token'lar içindir.
Uzun belgeler veya uzun bir geçmiş tutan bir ajan
Büyüyen kısım önbellektir ve kendi donanımınızda aynı bellek için ağırlıklarla yarışır. Bir API ile bağlam penceresi başkasının sorunudur: CheapTokens'te DeepSeek-V4-Flash ve GLM-5.3-Flash 380K ve 390K token alır.
Bunun pratikte nasıl göründüğü. Diyelim ki bir destek botu ayda 3.000 talep özetliyor, her biri yaklaşık 2.000 token giriş ve 400 token çıkış. Ay boyunca bu 2000 × 3000 = 6000000 giriş token'ı ve 400 × 3000 = 1200000 çıkış token'ı eder. DeepSeek-V4-Flash'te giriş 1M token başına $0.015 ve çıkış $0.10 tutar, yani tüm ay $0.21 eder. Aşağıdaki tablo aynı yükü her modelde gösterir, yanında OpenRouter sütunuyla birlikte, böylece toplam, giriş ve çıkışı bir arada karşılaştırabilirsiniz:
| Model | Giriş $/1M | Çıkış $/1M | İstek başına | 3.000 istek | OpenRouter, 3.000 istek |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
İstek başına 2.000 giriş ve 400 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
İsteğin kendisi, herhangi bir sağlayıcıya yapacağınız aynı OpenAI tarzı çağrıdır. Temel URL https:/ ve model kimliği tam deepseek-:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
Yanıt, giriş ve çıkış token sayılarını içeren bir usage bloğu taşır, böylece ilk bir düzineden sonra yukarıdaki tahmini kendi taleplerinizle karşılaştırabilirsiniz. DeepSeek-V4-Flash size yanıt başına 32.768 çıkış token'ına kadar, günün her saati tek fiyatla sunar ve GLM-5.3-Flash 8.192'ye kadar olan daha hafif günlük seçenektir. Kurulum ayrıntıları dokümanlarda, model sayfası ucuz DeepSeek ve tam fiyat listesi fiyatlandırma sayfasında.
Bir dahaki sefere bir model adı bir boyutla geldiğinde, artık üç adımınız var: çarp, önbelleği ekle, kartla karşılaştır.


