ツールと連携ガイド
Cherry Studio を CheapTokens に接続する: カスタムプロバイダーと Base URL
Cherry Studio でカスタムプロバイダーを追加する: 末尾スラッシュ付きの Base URL、API キー、モデル ID、Model Check、さらに 401 と 404 の修正方法。
このページの内容
Cherry Studio で CheapTokens を使うには、カスタムプロバイダーを追加します(設定 → モデルプロバイダー → プロバイダーを追加)。OpenAI Base URL フィールドに https:/ を入れ、API キーを貼り付け、モデル ID deepseek- を手動で追加します。その後 Model Check でキーを確認し、あいさつを送ってみてください。作業はこれだけです。唯一つまずきやすいのは、URL 末尾のスラッシュです。
デスクトップのチャットアプリを開くのは、複数のモデルを 1 つのウィンドウで、その背後に 1 つの残高を置きたいからであり、サービスごとにブラウザタブを開きたいからではありません。Cherry Studio はそのために作られています。Windows、macOS、Linux 向けのオープンソース AI ワークステーション(AGPL-3.0 Community Edition)で、チャット、エージェント、ナレッジベースを備え、OpenAI 互換のサービスなら何でもカスタムプロバイダーとして受け付けます。CheapTokens は OpenAI Chat Completions 形式に対応しているので、そのまま使えます。以下の手順は Cherry Studio のドキュメントにあるカスタムプロバイダーのページに従い、2026 年 11 月 7 日に確認したものです。アプリ自体は変わるので、ラベルが移動していたら近くで同じ言葉を探してください。
アプリを開く前に必要なもの#
3 つだけ、どれも短いものです。
- Base URL:
https:/(末尾のスラッシュ付き。理由は次のセクションにあります)/ api. cheaptokens. dev/ v1/ - CheapTokens アカウントの API キー。共有ノートに貼らず、コピーできる場所に保管しておきます
- 完全なモデル ID。価格表の短い名前は API では受け付けられません。ゲートウェイ ID を使ってください。例えば
deepseek-です。他の ID は list-models ガイド と CheapTokens ドキュメント にあります。ai/ DeepSeek- V4- Flash- 0731
カスタムプロバイダーを追加する#
設定(歯車アイコン)を開き、モデルプロバイダーを選びます。プロバイダー一覧の一番下に + プロバイダーを追加 があります。クリックすると カスタムプロバイダーを追加 ダイアログが表示されます。
次のように入力します。
テーブルを右にスクロールしてください →
| フィールド | 入力する内容 |
|---|---|
| プロバイダー名 | CheapTokens(自分が認識できる任意の名前) |
| API キー | CheapTokens のキー |
| OpenAI Base URL | https:/ |
Cherry Studio はデフォルトで「OpenAI」と「Anthropic」のエンドポイントフィールドを表示します。実際に使うプロトコルだけを入力してください。通常のチャットなら OpenAI のほうで、Anthropic のフィールドは空のままで構いません。各 Base URL フィールドの下に、最終的なリクエストパスのプレビューが表示されます。これを読んでください。何かを送信する前に誤ったアドレスを見つける最速の方法です。
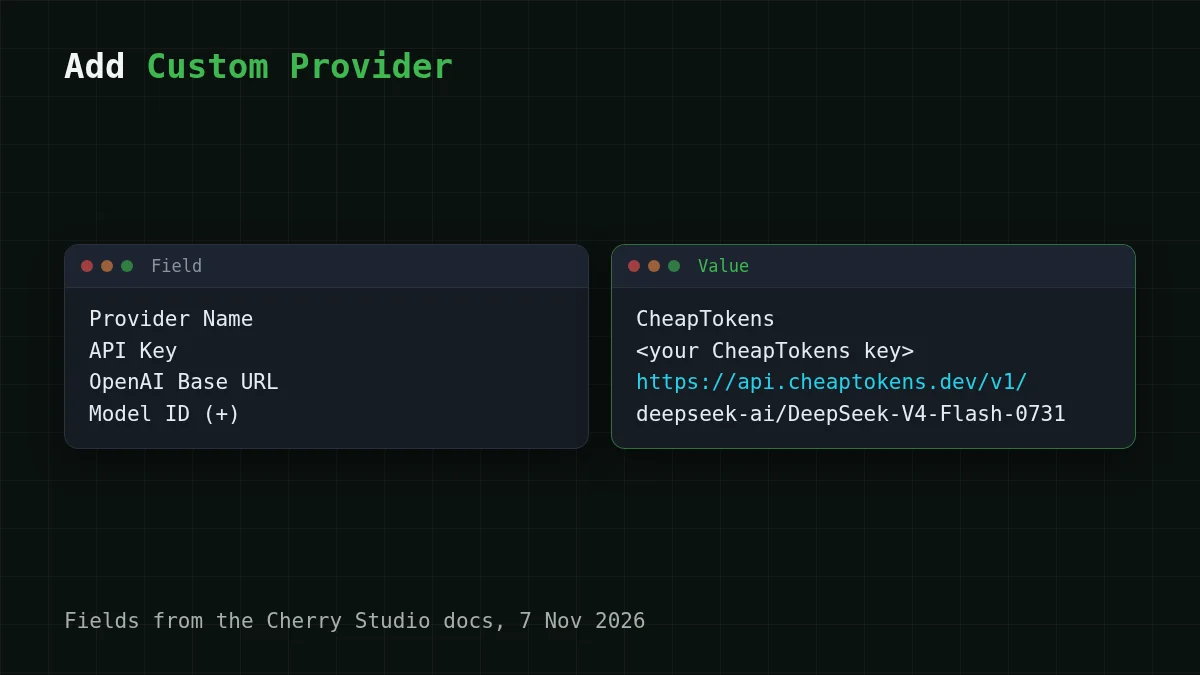
追加 をクリックして保存します。
末尾のスラッシュが重要な理由#
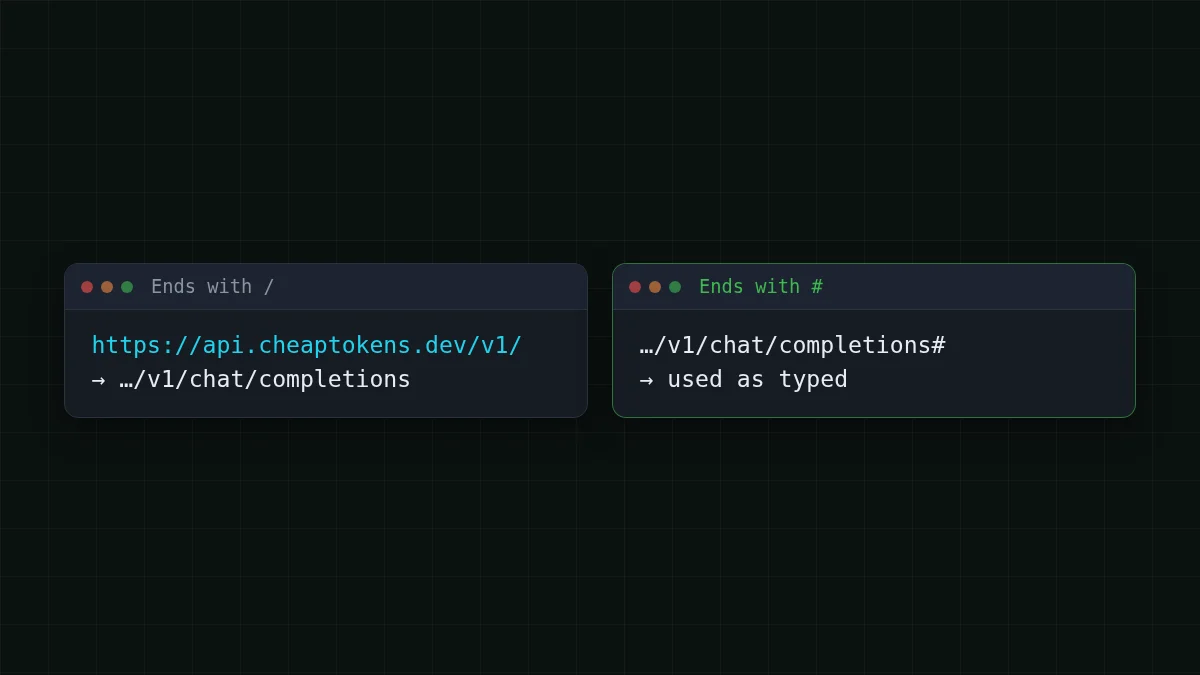
Cherry Studio はドキュメントにある 3 つのルールで Base URL からリクエスト URL を組み立てます(2026 年 11 月 7 日確認)。
https:/のようなルートアドレスには/ example. com /が追加されますv1/ chat/ completions /で終わるアドレスにはchat/completionsだけが追加されます#で終わるアドレスは入力どおりに使われ、何も追加されません
CheapTokens は /v1 の下にあるため、https:/ が https:/ に変換される形式です。これが API の期待するパスです。フィールド下のプレビューはまさにそう表示されるはずです。/v1/v1/ と表示されたり、/v1 がまったくない場合は、先に進む前にフィールドを修正してください。
キー、モデル、Model Check#
プロバイダーのページに戻ると、小さな手順が 5 つあります。この順番で行ってください。
順番に並べる
プロバイダーをこの順番で接続する
項目をドラッグするか矢印を使う
- プロバイダーの有効化スイッチをオンにする(ページ右上)
- API キーを入力する
- Model Check をクリックしてキーを検証する
- Base URL を確認する
- モデル管理の + ボタンでモデル ID を追加する
手順 5 についての注意。ページにはサービスからモデル一覧を取得する モデルを同期 ボタンもあります。確実な方法は + で自分で ID を追加することです。deepseek- を deepseek-ai/ の部分まで正確に入力してください。追加できるモデルは次のとおりです。
テーブルを右にスクロールしてください →
| モデル | 入力するモデル ID | コンテキスト | 最大回答 |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32,768 トークン |
| GLM-5.3-Flash | zai- |
390K | 8,192 トークン |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8,192 トークン |
Model Check はキーフィールドの隣にあるボタンで、Cherry Studio のドキュメントによればキーが有効かどうかを確認します。エラーが出た場合は下のエラーセクションに進んでください。原因は通常、3 つのフィールドのいずれかです。
最初のメッセージを送る#
新しいチャットを開き、上部のモデルセレクターで CheapTokens プロバイダーと追加したモデルを選び、「トークンとは何かを 2 文で説明してください」のような短いメッセージを書きます。モデルから返信が来れば、キー、アドレス、モデル ID という一連の流れがすべて機能しています。
アプリなしでリクエストを確認したい場合は、次のシンプルな Chat Completions 呼び出しを使います。
export CHEAPTOKENS_API_KEY="paste-your-key-here"

curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Explain what a token is in two sentences."}]}'
返信は JSON で、テキストは choices[0]. に、トークン数は usage に入っています。
デスクトップチャットに入れるモデル#
チャットウィンドウはエージェントループとは別の仕事です。質問し、読み、また質問します。そのときに重要なのは 2 点、回答をどれだけ長くできるかと、どれだけ大きな会話が収まるかです。
- DeepSeek-V4-Flash — 一般的なチャットや長い文書のデフォルト選択肢。回答あたり最大 32,768 出力トークン、380K コンテキスト、時間帯を問わず同一価格。入力と出力を合計すると OpenRouter より安価です。
- GLM-5.3-Flash — 日常的なチャット向けで、3 つの中で最大のウィンドウ(390K)。入力・出力ともに OpenRouter より安価です。
- MiniMax-M2.7 — 180K コンテキストでチャットやエージェント的なタスク向け。入力・出力ともに OpenRouter より安価です。
3 つとも 1 つの残高の背後にあるので、同じプロバイダーに 3 つの ID をすべて追加し、キーに触れることなくモデルセレクターで切り替えられます。
チャットセッションのコスト#
おおよその目安です。20 メッセージの会話があるとします。各メッセージはそれまでの履歴を再送するため、1 リクエストあたり平均で入力約 6,000 トークン、出力約 500 トークンになります(理由は 長いチャットが高くつく理由 で説明しています)。DeepSeek-V4-Flash での 1 リクエストは $0.00014 です。その 20 回分が下の計算機にあります。スライダーを自分のチャットに合わせて動かしてください。
コスト計算機
20 メッセージのチャットセッション 1 回
リクエストあたりの入力トークン数: 6,000 · リクエストあたりの出力トークン数: 500 · 1日あたりのリクエスト数: 20
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0028 | $0.084 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0028 | $0.084 |
| MiniMax-M2.7$0.05$0.15 | $0.0075 | $0.225 |
下の表は同じセッションをすべてのモデルで実行し、比較用に OpenRouter の列も加えています。
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 20 リクエスト | OpenRouter、20 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.0028 | $0.0049 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00014 | $0.0028 | $0.0098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00038 | $0.0075 | $0.09 |
リクエストあたり 6,000 入力トークンと 500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
1M トークンあたりの現在の価格は CheapTokens の料金 を参照してください。
うまくいかない場合#
ほとんどの問題は同じ 3 つのフィールド、キー、URL、モデル ID から来ます。表示される内容を原因に照らし合わせてください。
ペアを合わせる
症状から考えられる原因を特定する
左の項目をタップしてから、そのペアをタップ
- 401 UnauthorizedAPI キーがない、入力ミスがある、余計なスペースが入っている
- 404 Not FoundBase URL が間違っている: パスのプレビューが /v1/chat/completions で終わっていない
- アプリが不明なモデルを報告するモデル ID が短い名前になっている可能性が高い。プレフィックス付きの完全な ID を入力する
- アプリが残高不足を報告する残高が空で、チャージが必要な可能性が高い
これらのエラーのより詳しい解説は API 401 または 404: キー、Base URL、モデル ID の誤り を参照してください。デスクトップアプリではなくブラウザベースのチャットを使いたい場合は、Open WebUI も同じ方法で動作します。
出典: Cherry Studio ドキュメント、カスタムプロバイダーおよびプロバイダー設定ページ、2026 年 11 月 7 日確認。プロジェクトは github.com/CherryHQ/cherry-studio にあります。


