ٹولز اور انٹیگریشنزگائیڈ
Cherry Studio کو CheapTokens سے جوڑیں: کسٹم پرووائیڈر، Base URL
Cherry Studio میں کسٹم پرووائیڈر شامل کریں: آخر میں slash والا Base URL، API key، ماڈل id اور Model Check، نیز 401 اور 404 کے حل۔
اس صفحہ پر
Cherry Studio میں CheapTokens استعمال کرنے کے لیے، ایک کسٹم پرووائیڈر شامل کریں (Settings → Model Provider → Add Provider)، OpenAI Base URL فیلڈ میں https:/ ڈالیں، اپنی API key پیسٹ کریں اور ماڈل id deepseek- دستی طور پر شامل کریں۔ پھر Model Check سے key چیک کریں اور hello کہیں۔ بس اتنا ہی کام ہے؛ صرف ایک تفصیل پریشان کرتی ہے اور وہ ہے URL کے آخر میں موجود slash۔
آپ ڈیسک ٹاپ چیٹ ایپ اس لیے کھولتے ہیں کہ آپ کو کئی ماڈلز کے لیے ایک ونڈو اور ان سب کے پیچھے ایک بیلنس چاہیے، ہر سروس کے لیے الگ براؤزر ٹیب نہیں۔ Cherry Studio اسی کے لیے بنایا گیا ہے: یہ Windows، macOS اور Linux (AGPL-3.0 Community Edition) کے لیے ایک اوپن سورس AI ورک اسٹیشن ہے جس میں چیٹ، ایجنٹس اور نالج بیسز شامل ہیں، اور یہ کسی بھی OpenAI-compatible سروس کو کسٹم پرووائیڈر کے طور پر قبول کرتا ہے۔ CheapTokens OpenAI Chat Completions فارمیٹ استعمال کرتا ہے، اس لیے یہ موزوں ہے۔ نیچے دیے گئے مراحل Cherry Studio کے کسٹم پرووائیڈرز والے ڈاکس صفحے کی پیروی کرتے ہیں، جو 7 نومبر 2026 کو چیک کیا گیا؛ ایپ خود بدلتی رہتی ہے، اس لیے اگر کوئی لیبل ہٹ گیا ہو تو قریب ہی وہی لفظ تلاش کریں۔
ایپ کھولنے سے پہلے آپ کو کیا چاہیے#
تین چیزیں، سب مختصر:
- Base URL:
https:/(آخر میں slash کے ساتھ — وجہ اگلے حصے میں ہے)؛/ api. cheaptokens. dev/ v1/ - اپنے CheapTokens اکاؤنٹ سے ایک API key، جسے آپ کاپی کر سکیں، کسی مشترکہ نوٹ میں پیسٹ نہ کریں؛
- مکمل ماڈل id۔ قیمت کی فہرست والا مختصر نام API قبول نہیں کرتا؛ gateway id استعمال کریں، مثلاً
deepseek-۔ باقی ids list-models گائیڈ اور CheapTokens ڈاکس میں ہیں۔ai/ DeepSeek- V4- Flash- 0731
کسٹم پرووائیڈر شامل کریں#
Settings (گیئر آئیکن) کھولیں، پھر Model Provider۔ پرووائیڈر فہرست کے نیچے + Add Provider ہے۔ اس پر کلک کریں اور Add Custom Provider ڈائیلاگ ظاہر ہوگا۔
اسے اس طرح بھریں:
ٹیبل کو دائیں طرف اسکرول کریں →
| فیلڈ | کیا درج کریں |
|---|---|
| Provider Name | CheapTokens (کوئی بھی نام جو آپ پہچان سکیں) |
| API Key | آپ کی CheapTokens key |
| OpenAI Base URL | https:/ |
Cherry Studio بطور ڈیفالٹ 'OpenAI' اور 'Anthropic' endpoint فیلڈز دکھاتا ہے۔ صرف وہی پروٹوکول بھریں جو آپ واقعی استعمال کرتے ہیں؛ عام چیٹ کے لیے یہ OpenAI والا ہے، اور Anthropic فیلڈ خالی رہ سکتی ہے۔ ہر Base URL فیلڈ کے نیچے ایپ حتمی request path کا پیش منظر دکھاتی ہے۔ اسے پڑھیں۔ کچھ بھی بھیجنے سے پہلے غلط پتہ پکڑنے کا یہ تیز ترین طریقہ ہے۔
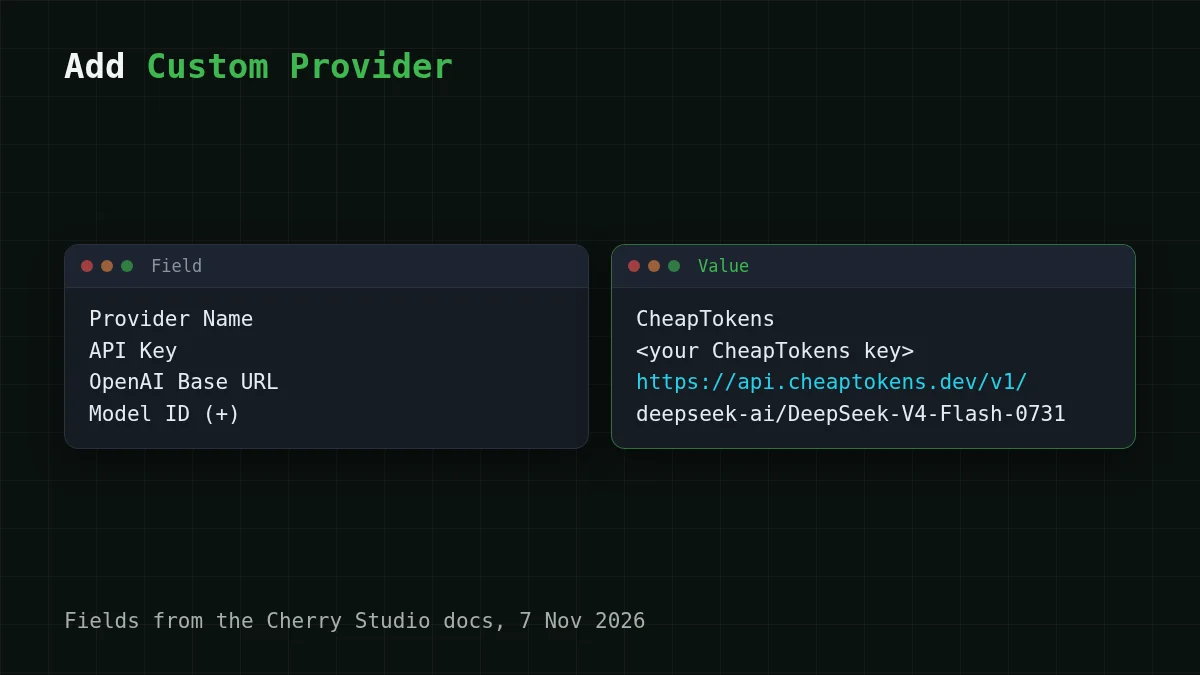
محفوظ کرنے کے لیے Add پر کلک کریں۔
آخر میں slash کیوں اہم ہے#
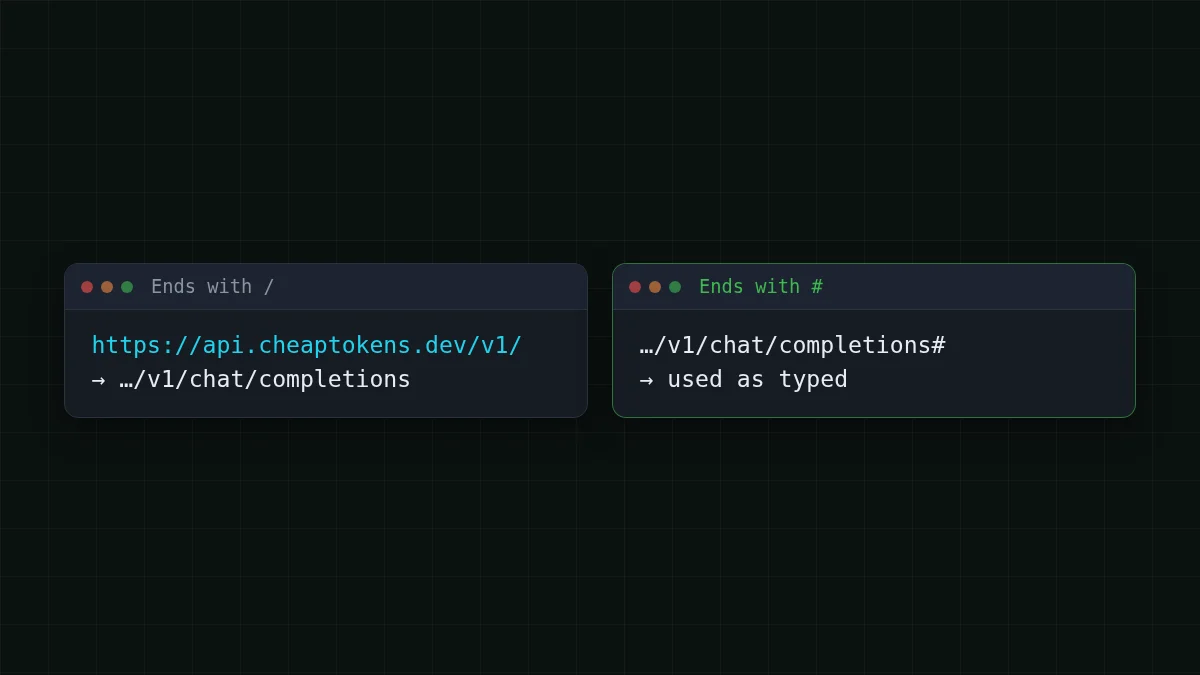
Cherry Studio اپنے ڈاکس (7 نومبر 2026 کو چیک شدہ) میں تین اصولوں کے تحت آپ کے Base URL سے request URL بناتا ہے:
https:/جیسا root پتہ/ example. com /شامل کر لیتا ہے؛v1/ chat/ completions /پر ختم ہونے والا پتہ صرفchat/completionsشامل کرتا ہے؛#پر ختم ہونے والا پتہ بالکل ویسے ہی استعمال ہوتا ہے، کچھ شامل نہیں ہوتا۔
CheapTokens /v1 کے تحت ہے، اس لیے https:/ وہ شکل ہے جو https:/ بنتی ہے — وہی path جو API توقع کرتا ہے۔ فیلڈ کے نیچے پیش منظر بالکل یہی دکھانا چاہیے۔ اگر آپ کو /v1/v1/ نظر آئے یا /v1 بالکل نہ ہو تو آگے بڑھنے سے پہلے فیلڈ درست کریں۔
Key، ماڈل اور Model Check#
پرووائیڈر کے صفحے پر واپس آنے پر پانچ چھوٹے مراحل ہیں۔ انہیں اسی ترتیب سے کریں:
ترتیب دیں
Connect the provider in this order
آئٹمز کو گھسیٹیں یا تیروں کا استعمال کریں
- پرووائیڈر کا enable سوئچ آن کریں (اس کے صفحے کے اوپر دائیں جانب)
- API key درج کریں
- key کی تصدیق کے لیے Model Check پر کلک کریں
- Base URL چیک کریں
- model management میں + بٹن سے ماڈل id شامل کریں
مرحلہ 5 پر ایک نوٹ۔ صفحے پر Sync models بٹن بھی ہے جو سروس سے ماڈل فہرست حاصل کرتا ہے۔ قابلِ اعتماد طریقہ یہ ہے کہ آپ خود + سے id شامل کریں: deepseek- بالکل ویسے ہی ٹائپ کریں، deepseek-ai/ والے حصے کے ساتھ۔ آپ کون سے ماڈلز شامل کر سکتے ہیں:
ٹیبل کو دائیں طرف اسکرول کریں →
| ماڈل | ٹائپ کرنے کے لیے ماڈل id | Context | زیادہ سے زیادہ جواب |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32,768 tokens |
| GLM-5.3-Flash | zai- |
390K | 8,192 tokens |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8,192 tokens |
Model Check key فیلڈ کے ساتھ والا بٹن ہے؛ Cherry Studio ڈاکس کے مطابق، یہ جانچتا ہے کہ key درست ہے۔ اگر یہ شکایت کرے تو نیچے error والے حصے پر جائیں: وجہ عموماً تین فیلڈز میں سے کوئی ایک ہوتی ہے۔
پہلا پیغام بھیجیں#
ایک نئی چیٹ کھولیں، اوپر model selector میں CheapTokens پرووائیڈر اور وہ ماڈل منتخب کریں جو آپ نے شامل کیا، اور کچھ مختصر لکھیں، جیسے 'Explain what a token is in two sentences.' ماڈل کی طرف سے جواب کا مطلب ہے کہ پوری زنجیر کام کر رہی ہے: key، پتہ، ماڈل id۔
ایپ کے بغیر request دیکھنا چاہتے ہیں؟ یہ ایک سادہ Chat Completions کال ہے:
export CHEAPTOKENS_API_KEY="paste-your-key-here"

curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Explain what a token is in two sentences."}]}'
جواب JSON ہے جس میں متن choices[0]. میں اور token counts usage میں ہیں۔
ڈیسک ٹاپ چیٹ میں کون سا ماڈل ڈالیں#
چیٹ ونڈو ایجنٹ لوپ سے مختلف کام ہے: آپ پوچھتے ہیں، پڑھتے ہیں، دوبارہ پوچھتے ہیں۔ پھر دو چیزیں اہم ہوتی ہیں: جوابات کتنے لمبے ہو سکتے ہیں اور کتنی بڑی گفتگو سماتی ہے۔
- DeepSeek-V4-Flash — عام چیٹ اور طویل دستاویزات کے لیے ڈیفالٹ انتخاب: فی جواب 32,768 output tokens تک، 380K context، کسی بھی وقت ایک ہی قیمت۔ مجموعی طور پر، input اور output ملا کر، یہ OpenRouter سے سستا ہے۔
- GLM-5.3-Flash — روزمرہ چیٹ کے لیے تینوں میں سب سے بڑی ونڈو (390K)، input اور output دونوں پر OpenRouter سے سستا۔
- MiniMax-M2.7 — 180K context کے ساتھ چیٹ اور ایجنٹ طرز کے کام، دونوں طرف OpenRouter سے سستا۔
تینوں ایک ہی بیلنس کے پیچھے ہیں، اس لیے آپ تینوں ids ایک ہی پرووائیڈر میں شامل کر کے key کو چھوئے بغیر model selector میں بدل سکتے ہیں۔
چیٹ سیشن کا خرچ#
ایک موٹا اندازہ یہ ہے۔ فرض کریں آپ کی 20 پیغامات کی گفتگو ہے۔ ہر پیغام پچھلی تاریخ دوبارہ بھیجتا ہے، اس لیے ایک request میں اوسطاً تقریباً 6,000 tokens input اور 500 tokens output ہوتے ہیں (وجہ لمبی چیٹ زیادہ مہنگی کیوں ہے میں بیان کی گئی ہے)۔ DeepSeek-V4-Flash پر ایک request کی قیمت $0.00014 ہے۔ ان میں سے بیس نیچے کیلکولیٹر میں ہیں؛ سلائیڈرز کو اپنی چیٹس کے مطابق حرکت دیں۔
لاگت کیلکولیٹر
One 20-message chat session
فی درخواست ان پٹ ٹوکنز: 6,000 · فی درخواست آؤٹ پٹ ٹوکنز: 500 · فی دن درخواستیں: 20
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0028 | $0.084 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0028 | $0.084 |
| MiniMax-M2.7$0.05$0.15 | $0.0075 | $0.225 |
نیچے دیا گیا جدول وہی سیشن تمام ماڈلز پر چلاتا ہے، موازنے کے لیے OpenRouter کالم کے ساتھ:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 20 درخواستیں | OpenRouter، 20 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.0028 | $0.0049 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00014 | $0.0028 | $0.0098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00038 | $0.0075 | $0.09 |
فی درخواست 6,000 ان پٹ اور 500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
فی 1M tokens موجودہ قیمتوں کے لیے CheapTokens pricing دیکھیں۔
اگر یہ کام نہ کرے#
زیادہ تر مسائل انہی تین فیلڈز سے آتے ہیں: key، URL، ماڈل id۔ جو آپ دیکھتے ہیں اسے وجہ سے ملائیں:
جوڑے ملائیں
Match the symptom to the likely cause
بائیں طرف کسی آئٹم پر ٹیپ کریں، پھر اس کا جوڑا
- 401 UnauthorizedAPI key غائب ہے، غلط ٹائپ ہوئی ہے یا اس میں کوئی فالتو space ہے
- 404 Not FoundBase URL غلط ہے: path کا پیش منظر /v1/chat/completions پر ختم نہیں ہوتا
- ایپ نامعلوم ماڈل بتاتی ہےغالباً ماڈل id مختصر نام ہے؛ prefix کے ساتھ مکمل id ٹائپ کریں
- ایپ ناکافی بیلنس بتاتی ہےغالباً بیلنس خالی ہے اور اسے ٹاپ اپ کی ضرورت ہے
ان errors کی مزید تفصیلی وضاحت کے لیے API 401 or 404: wrong key, base URL or model id دیکھیں۔ اور اگر آپ ڈیسک ٹاپ ایپ کے بجائے براؤزر پر مبنی چیٹ پسند کرتے ہیں تو Open WebUI اسی طرح کام کرتا ہے۔
ماخذ: Cherry Studio ڈاکس، کسٹم پرووائیڈر اور پرووائیڈر settings کے صفحات، 7 نومبر 2026 کو چیک شدہ؛ پروجیکٹ github.com/CherryHQ/cherry-studio پر ہے۔


