Conecte o Cherry Studio ao CheapTokens: provedor personalizado, Base URL
Adicione um provedor personalizado no Cherry Studio: a Base URL com a barra no final, chave de API, id do modelo e Model Check, além de correções para 401 e 404.
Nesta página
Para usar o CheapTokens no Cherry Studio, adicione um provedor personalizado (Configurações → Provedor de Modelos → Adicionar Provedor), coloque https:/ no campo OpenAI Base URL, cole sua chave de API e adicione o id do modelo deepseek- manualmente. Depois verifique a chave com Model Check e diga olá. É só isso; o único detalhe que pega é a barra no final da URL.
Você abre um app de chat para desktop porque quer uma janela para vários modelos e um saldo por trás deles, não uma aba de navegador por serviço. O Cherry Studio é feito para isso: é uma estação de trabalho de IA open-source para Windows, macOS e Linux (AGPL-3.0 Community Edition) com chat, agentes e bases de conhecimento, e aceita qualquer serviço compatível com OpenAI como provedor personalizado. O CheapTokens fala o formato OpenAI Chat Completions, então se encaixa. Os passos abaixo seguem a página de docs do Cherry Studio sobre provedores personalizados, verificada em 7 de novembro de 2026; o app em si muda, então se um rótulo tiver se movido, procure a mesma palavra por perto.
O que você precisa antes de abrir o app#
Três coisas, todas curtas:
- a Base URL:
https:/(com a barra no final — o motivo está na próxima seção);/ api. cheaptokens. dev/ v1/ - uma chave de API da sua conta CheapTokens, guardada em algum lugar de onde você possa copiá-la, não colada em uma nota compartilhada;
- o id completo do modelo. O nome curto da lista de preços não é aceito pela API; use o id do gateway, por exemplo
deepseek-. Os outros ids estão no guia de listagem de modelos e na documentação do CheapTokens.ai/ DeepSeek- V4- Flash- 0731
Adicione o provedor personalizado#
Abra Configurações (o ícone de engrenagem), depois Provedor de Modelos. No final da lista de provedores está + Adicionar Provedor. Clique nele e o diálogo Adicionar Provedor Personalizado aparece.
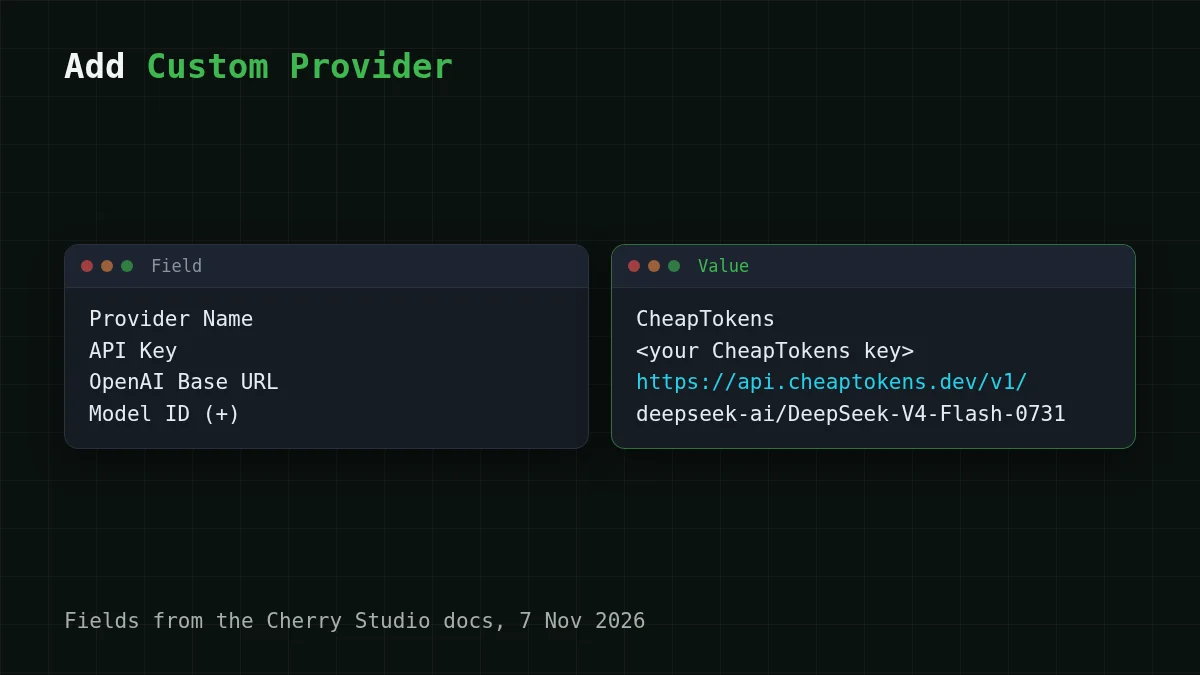
Preencha assim:
Role a tabela para a direita →
| Campo | O que inserir |
|---|---|
| Nome do Provedor | CheapTokens (qualquer nome que você reconheça) |
| Chave de API | sua chave CheapTokens |
| OpenAI Base URL | https:/ |
O Cherry Studio mostra campos de endpoint 'OpenAI' e 'Anthropic' por padrão. Preencha apenas o protocolo que você realmente usa; para um chat normal é o da OpenAI, e o campo Anthropic pode ficar vazio. Sob cada campo Base URL o app mostra uma prévia do caminho final da requisição. Leia. É a forma mais rápida de pegar um endereço errado antes de enviar qualquer coisa.
Clique em Adicionar para salvar.
Por que a barra no final importa#
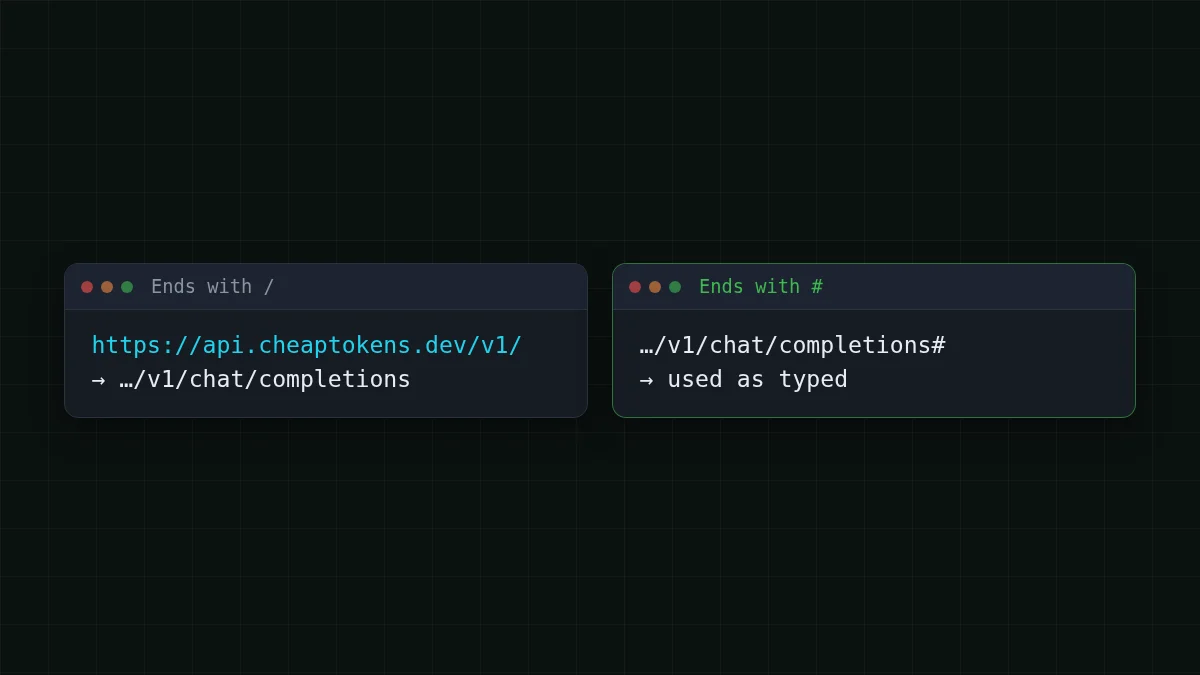
O Cherry Studio monta a URL da requisição a partir da sua Base URL por três regras em sua documentação (verificada em 7 de novembro de 2026):
- um endereço raiz como
https:/recebe/ example. com /anexado;v1/ chat/ completions - um endereço terminando em
/recebe apenaschat/completionsanexado; - um endereço terminando em
#é usado exatamente como digitado, sem nada adicionado.
O CheapTokens fica sob /v1, então https:/ é a forma que se transforma em https:/ — o caminho que a API espera. A prévia sob o campo deve mostrar exatamente isso. Se você vir /v1/v1/ ou nenhum /v1, corrija o campo antes de continuar.
Chave, modelo e Model Check#
De volta à página do provedor há cinco pequenos passos. Faça-os nesta ordem:
Colocar em ordem
Conecte o provedor nesta ordem
Arraste os itens ou use as setas
- Ative o interruptor de habilitação do provedor (canto superior direito da página dele)
- Insira a chave de API
- Clique em Model Check para verificar a chave
- Verifique a Base URL
- Adicione o id do modelo com o botão + no gerenciamento de modelos
Uma observação sobre o passo 5. A página também tem um botão Sincronizar modelos que busca uma lista de modelos do serviço. O caminho confiável é adicionar o id você mesmo com +: digite deepseek- exatamente, com a parte deepseek-ai/. Quais modelos você pode adicionar:
Role a tabela para a direita →
| Modelo | Id do modelo a digitar | Contexto | Resposta máxima |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32.768 tokens |
| GLM-5.3-Flash | zai- |
390K | 8.192 tokens |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8.192 tokens |
Model Check é o botão ao lado do campo da chave; segundo a documentação do Cherry Studio, ele verifica se a chave é válida. Se ele reclamar, pule para a seção de erros abaixo: a causa costuma ser um dos três campos.
Envie a primeira mensagem#
Abra um novo chat, escolha o provedor CheapTokens e o modelo que você adicionou no seletor de modelos no topo, e escreva algo curto, como 'Explique o que é um token em duas frases.' Uma resposta do modelo significa que toda a cadeia funciona: chave, endereço, id do modelo.
Quer ver uma requisição sem o app? Aqui está uma chamada Chat Completions simples:
export CHEAPTOKENS_API_KEY="paste-your-key-here"

curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Explain what a token is in two sentences."}]}'
A resposta é JSON com o texto em choices[0]. e as contagens de tokens em usage.
Qual modelo colocar em um chat de desktop#
Uma janela de chat é um trabalho diferente de um loop de agente: você pergunta, lê, pergunta de novo. Duas coisas então importam: quão longas as respostas podem ser e quão grande é a conversa que cabe.
- DeepSeek-V4-Flash — a escolha padrão para chat geral e documentos longos: até 32.768 tokens de saída por resposta, contexto de 380K, um preço a qualquer hora. No total, com entrada e saída contadas juntas, é mais barato que o OpenRouter.
- GLM-5.3-Flash — chat do dia a dia com a maior janela dos três (390K), mais barato que o OpenRouter tanto na entrada quanto na saída.
- MiniMax-M2.7 — chat e tarefas no estilo agente com contexto de 180K, mais barato que o OpenRouter nos dois lados.
Os três ficam atrás de um único saldo, então você pode adicionar os três ids ao mesmo provedor e alternar no seletor de modelos sem tocar na chave.
Quanto custa uma sessão de chat#
Aqui está um panorama aproximado. Digamos que você tenha uma conversa de 20 mensagens. Cada mensagem reenvia o histórico anterior, então uma requisição tem em média cerca de 6.000 tokens de entrada e 500 tokens de saída (um motivo abordado em por que um chat longo custa mais). Uma requisição no DeepSeek-V4-Flash custa $0.00014. Vinte delas estão na calculadora abaixo; mova os controles para corresponder aos seus próprios chats.
Calculadora de custos
Uma sessão de chat de 20 mensagens
Tokens de entrada por solicitação: 6.000 · Tokens de saída por solicitação: 500 · Solicitações por dia: 20
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0028 | $0.084 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0028 | $0.084 |
| MiniMax-M2.7$0.05$0.15 | $0.0075 | $0.225 |
A tabela abaixo executa a mesma sessão em todos os modelos, com uma coluna OpenRouter para comparação:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 20 solicitações | OpenRouter, 20 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00014 | $0.0028 | $0.0049 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00014 | $0.0028 | $0.0098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00038 | $0.0075 | $0.09 |
6.000 tokens de entrada e 500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Para preços atuais por 1M tokens, veja preços do CheapTokens.
Se não funcionar#
A maioria dos problemas vem dos mesmos três campos: chave, URL, id do modelo. Relacione o que você vê com a causa:
Emparelhar os pares
Relacione o sintoma com a provável causa
Toque num item à esquerda, depois no seu par
- 401 UnauthorizedA chave de API está ausente, digitada errado ou tem um espaço extra
- 404 Not FoundA Base URL está errada: a prévia do caminho não termina em /v1/chat/completions
- O app relata um modelo desconhecidoProvavelmente o id do modelo é o nome curto; digite o id completo com o prefixo
- O app relata saldo insuficienteProvavelmente o saldo está vazio e precisa de recarga
Para um passo a passo mais longo desses erros, veja API 401 ou 404: chave, base URL ou id de modelo errados. E se você preferir um chat baseado em navegador em vez de um app de desktop, o Open WebUI funciona da mesma forma.
Fontes: documentação do Cherry Studio, páginas de provedor personalizado e configurações de provedor, verificadas em 7 de novembro de 2026; o projeto está em github.com/CherryHQ/cherry-studio.


