Modele i porównaniaPorównanie
Najtańszy model API DeepSeek w 2026: deepseek-flash vs Pro
Oficjalne ceny API DeepSeek sprawdzone 29 października 2026: Flash vs Pro, szczyt vs poza szczytem, trafienia cache i ile naprawdę kosztują bot wsparcia i agent.
Na tej stronie
Twój rachunek za DeepSeek zależy od trzech rzeczy, których cena za token nie pokazuje: który model wywołujesz, o której godzinie go wywołujesz i jak dużą część promptu pamięta cache. Krótka odpowiedź: z dwóch oficjalnych modeli deepseek-flash jest tańszy w każdej kolumnie. Poza szczytem kosztuje $0.15 za 1M tokenów wejściowych (cache miss) i $0.60 za 1M tokenów wyjściowych. W szczycie obie stawki się podwajają.
Poniższe ceny pochodzą ze strony cennika DeepSeek, pobranej 29 października 2026. Strona nie podaje daty publikacji, więc datę pobrania traktuj jako datę cen.
Dwa oficjalne modele, jedna zmiana nazwy#
Oficjalne API sprzedaje dwa modele: deepseek-flash, obsługiwany przez DeepSeek-V4.1-Flash-1017, oraz deepseek-v4-pro, obsługiwany przez DeepSeek-V4-Pro-0813. Oba deklarują kontekst 1M i do 384K tokenów wyjściowych.
Jeśli twój kod nadal używa deepseek- lub deepseek-, nic się nie psuje. Nota wydania z 17 października 2026 DeepSeek mówi, że te modele są wycofane, a ich nazwy kierują teraz do DeepSeek-V4.1-Flash-1017 w cenie Flash. Co zmieniło się wewnątrz modelu, opisano w omówieniu wydania.
Oto ceny za 1M tokenów w USD:
Przewiń tabelę w prawo →
| Za 1M tokenów | Flash, poza szczytem | Flash, szczyt | Pro, poza szczytem | Pro, szczyt |
|---|---|---|---|---|
| Wejście, cache hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Wejście, cache miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Wyjście | $0.60 | $1.20 | $1.98 | $3.96 |
"Cache hit" oznacza, że DeepSeek rozpoznaje początek twojego promptu z wcześniejszego żądania i rozlicza tę część po niskiej stawce. Wyjaśnienie prompt caching opisuje mechanikę. Wszystko, co nie jest trafieniem, jest chybieniem.
Godziny szczytu: to samo żądanie, podwójna cena#
Szczyt to 01:00–04:00 i 06:00–10:00 UTC, od poniedziałku do piątku, z wyjątkiem chińskich świąt publicznych. Poza tymi oknami płacisz cenę poza szczytem, czyli połowę.
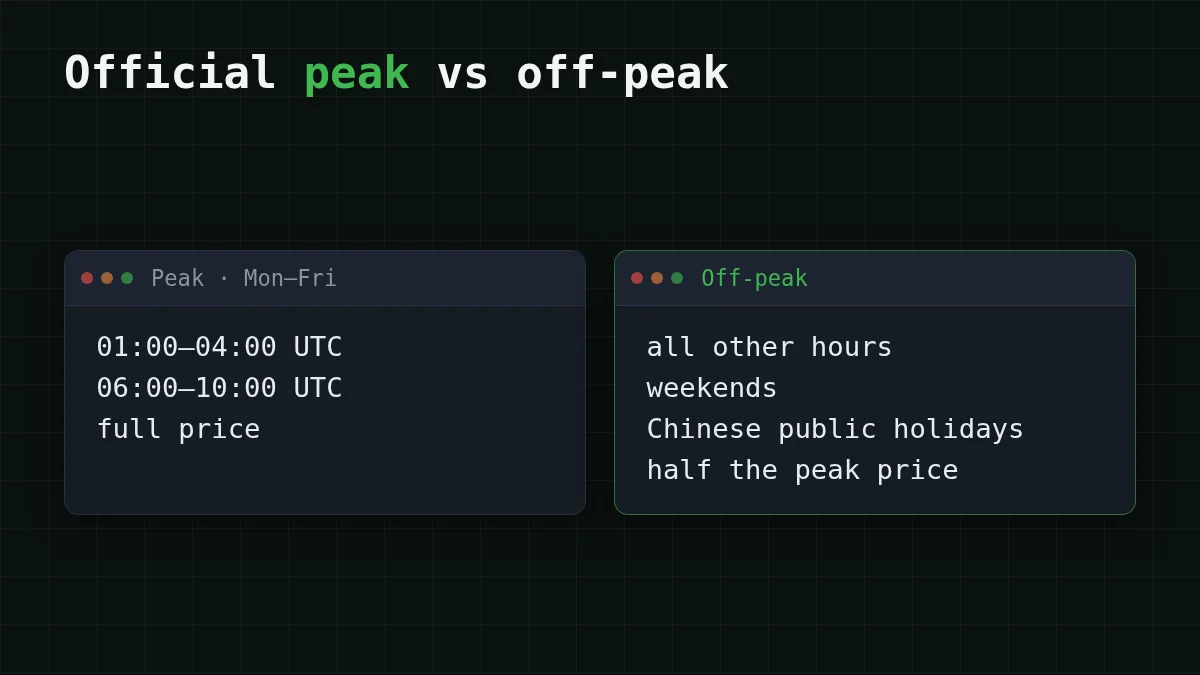
Siedem godzin dziennie brzmi jak niewiele. I jest: 7 × 5 = 35 z 168 godzin tygodnia, około jednej piątej. Ale te okna obejmują większość pekińskiego dnia pracy i europejski poranek, więc bot, który rozmawia z ludźmi w tych strefach czasowych, żyje w nich. Zadanie uruchamiane o 22:00 UTC nigdy nie zobaczy cen szczytu.
Zgadnij liczbę
Ile godzin dnia roboczego przypada na oficjalne okna szczytu?
Twoje przypuszczenie
024
Pokaż odpowiedź
Odpowiedź: 7
Siedem: 01:00–04:00 to 3 godziny, a 06:00–10:00 to 4 godziny, a 3 + 4 = 7.
Bot wsparcia: 1 000 żądań dziennie#
Załóżmy, że prowadzisz bota wsparcia. Każde żądanie niesie około 1 500 tokenów wejściowych (instrukcje plus wiadomość klienta) i zwraca około 400 tokenów. To 1,5M tokenów wejściowych i 0,4M wyjściowych dziennie, a dla uproszczenia nic z tego nie trafia w cache.
Na deepseek-flash w szczycie wejście to 1,5 × $0.30 = $0.45. Wyjście to 0,4 × $1.20 = $0.48. Dzień daje $0.45 + $0.48 = $0.93. Poza szczytem wejście to 1,5 × $0.15 = $0.225, a wyjście to 0,4 × $0.60 = $0.24, więc dzień to $0.225 + $0.24 = $0.465.
Na deepseek-v4-pro w szczycie wejście to 1,5 × $1.32 = $1.98. Wyjście to 0,4 × $3.96 = $1.584. Dzień daje $1.98 + $1.584 = $3.564.
Spójrz, gdzie idą pieniądze. Na Flash odpowiedzi o 400 tokenach kosztują nieco więcej niż prompty o 1 500 tokenach, bo wyjście jest drogą stroną. A Pro to model, który wybierasz po tym, jak test na twoich własnych zgłoszeniach pokaże, że odpowiedzi Flash są niewystarczające, a nie przed: ten test jest wart $3.564 dziennie w szczycie.
Pętla agenta: gdzie opłaca się cache#
Agent kodujący jest przeciwieństwem chatbota. Każdy krok ponownie wysyła ten sam duży prefiks: instrukcje, definicje narzędzi, pliki, które już przeczytał. Załóżmy, że przebieg to 100 kroków po 30 000 tokenów wejściowych i 2 000 tokenów wyjściowych, a 80% każdego promptu to ten powtarzany prefiks. To 3M tokenów wejściowych (2,4M trafień, 0,6M chybień) i 0,2M tokenów wyjściowych.
Na deepseek-flash w szczycie, bez żadnego cache: 3 × $0.30 = $0.90 za wejście plus 0,2 × $1.20 = $0.24 za wyjście, $0.90 + $0.24 = $1.14.
Przy 80% trafień: 2,4 × $0.006 = $0.0144 za trafienia, 0,6 × $0.30 = $0.18 za chybienia i te same $0.24 za wyjście, $0.0144 + $0.18 + $0.24 = $0.4344.
Cache obniżył wejście z $0.90 do $0.1944 i sprawił, że wyjście stało się największą pozycją na rachunku. To wzorzec z agentami: gdy prefiks jest w cache, odpowiedzi kosztują więcej niż czytanie. Utrzymuj początek promptu identyczny z kroku na krok, a to, co się zmienia, umieszczaj na końcu.
Zmień liczby na własną pętlę:
Kalkulator kosztów
Agent kodujący: 100 kroków
Tokeny wejściowe na żądanie: 30 000 · Tokeny wyjściowe na żądanie: 2000 · Żądania dziennie: 100
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
Kalkulator używa aktualnych cen, więc zmienia się wraz z cennikiem. Oficjalne liczby powyżej pozostają na dzień 29 października 2026.
Która konfiguracja pasuje do twojego zadania#
Wybierz swój przypadek
Wybierz najbliższe zadanie
Wybierz opcję, aby zobaczyć odpowiedź
Bot wsparcia, ruch przez cały dzień
Ruch nie czeka na godziny poza szczytem. Oficjalnie deepseek-flash w szczycie to liczba, z którą trzeba planować: $0.30 wejścia i $1.20 wyjścia za 1M tokenów. Jedna cena o każdej porze, jak DeepSeek-V4-Flash na CheapTokens, ułatwia przewidzenie miesięcznego rachunku.
Nocne zadanie wsadowe
Przenieś harmonogram poza 01:00–04:00 i 06:00–10:00 UTC, a zastosowanie ma oficjalna cena poza szczytem, czyli połowa szczytu. Jeśli zadania nie da się przenieść, realna jest cena szczytu.
Agent z dużym powtarzanym promptem
Utrzymuj prefiks promptu stabilny, aby współczynnik trafień cache pozostał wysoki, i licz się z tym, że wyjście stanie się największą częścią rachunku. Stała cena bez okien szczytu ułatwia budżetowanie takiej pętli.
Flash nie jest wystarczająco dobry
Najpierw przetestuj deepseek-v4-pro na próbce własnych zadań. Jego wejście przy cache miss to $1.32 w szczycie, a wyjście $3.96, więc powinien zarobić na tę cenę na twoich danych.
Te same obciążenia na CheapTokens#
Dla bota wsparcia i pętli agenta CheapTokens ma DeepSeek-V4-Flash: id deepseek-, kontekst 380K, do 32 768 tokenów wyjściowych na odpowiedź. To jedna cena o każdej porze, bez okien szczytu, jedno saldo dla wszystkich modeli i API zgodne z OpenAI i Anthropic pod https:/. W sumie, licząc wejście i wyjście razem, jest taniej niż OpenRouter.
Jedno żądanie bota wsparcia (1 500 wejścia, 400 wyjścia) kosztuje $0.000063. Opisany powyżej przebieg agenta na 100 kroków (3M wejścia, 0,2M wyjścia) kosztuje $0.065. Poniższa tabela to dzień bota, 1 000 żądań, we wszystkich naszych modelach z kolumną OpenRouter obok; zestaw ją z oficjalnymi liczbami powyżej:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
1500 tokenów wejściowych i 400 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
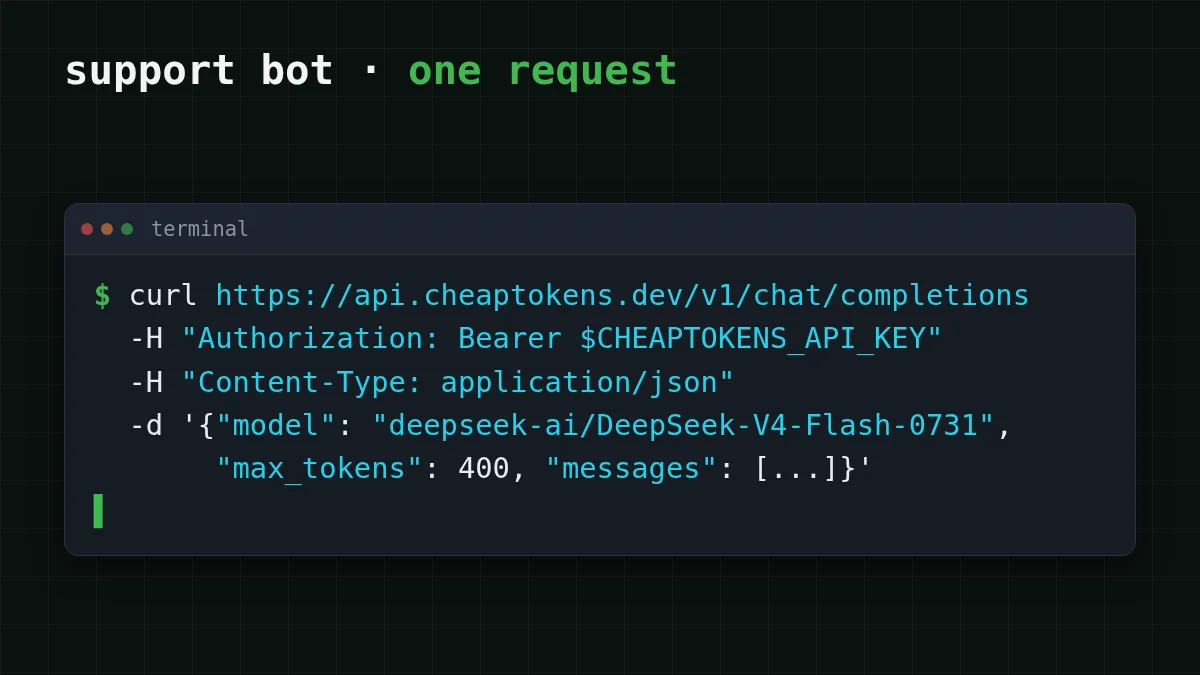
Aby samodzielnie wysłać żądanie bota (użyj id dokładnie tak, jak zapisano; krótkie id z etykiet cen nie są akceptowane):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
Odpowiedź zawiera blok usage z rzeczywistymi liczbami tokenów wejściowych i wyjściowych. Pomnóż je przez aktualne ceny albo wklej do tabeli powyżej, a otrzymasz koszt własnego żądania zamiast zgadywania.
Szczegóły połączenia znajdziesz w dokumentacji CheapTokens, na stronie DeepSeek i w aktualnej tabeli cen. Jeśli porównujesz DeepSeek z inną rodziną, MiniMax-M2.7 vs DeepSeek-V4-Flash stawia je obok siebie na tych samych zadaniach.


