Modelli e confrontiConfronto
Il modello API DeepSeek più economico nel 2026: deepseek-flash vs Pro
Prezzi ufficiali dell'API DeepSeek verificati il 29 ott 2026: Flash vs Pro, punta vs fuori punta, cache hit e quanto costano davvero un bot di supporto e un agente.
In questa pagina
La tua bolletta DeepSeek dipende da tre cose che il prezzo per token non mostra: quale modello chiami, a che ora lo chiami e quanta parte del tuo prompt ricorda la cache. La risposta breve: dei due modelli ufficiali, deepseek-flash è quello più economico in ogni colonna. Fuori punta costa $0.15 per 1M token di input (cache miss) e $0.60 per 1M token di output. In punta, entrambi raddoppiano.
I prezzi qui sotto provengono dalla pagina dei prezzi di DeepSeek, recuperata il 29 ottobre 2026. La pagina non riporta una data di pubblicazione, quindi considera la data di recupero come data del prezzo.
Due modelli ufficiali, un rename#
L'API ufficiale vende due modelli: deepseek-flash, servito da DeepSeek-V4.1-Flash-1017, e deepseek-v4-pro, servito da DeepSeek-V4-Pro-0813. Entrambi dichiarano una context di 1M e fino a 384K token di output.
Se il tuo codice dice ancora deepseek- o deepseek-, non si rompe nulla. La release note del 17 ottobre 2026 di DeepSeek dice che quei modelli sono ritirati e che i loro nomi ora instradano a DeepSeek-V4.1-Flash-1017 al prezzo Flash. Cosa è cambiato dentro il modello è trattato in un articolo sulla release.
Ecco i prezzi per 1M token, in USD:
Scorri la tabella verso destra →
| Per 1M token | Flash, fuori punta | Flash, punta | Pro, fuori punta | Pro, punta |
|---|---|---|---|---|
| Input, cache hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Input, cache miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Output | $0.60 | $1.20 | $1.98 | $3.96 |
"Cache hit" significa che DeepSeek riconosce l'inizio del tuo prompt da una richiesta precedente e fattura quella parte a tariffa ridotta. Spiegazione del prompt caching ne descrive il meccanismo. Tutto ciò che non è un hit è un miss.
Ore di punta: stessa richiesta, prezzo doppio#
La punta è 01:00–04:00 e 06:00–10:00 UTC, dal lunedì al venerdì, esclusi i giorni festivi pubblici cinesi. Fuori da quelle finestre paghi il prezzo fuori punta, che è la metà.
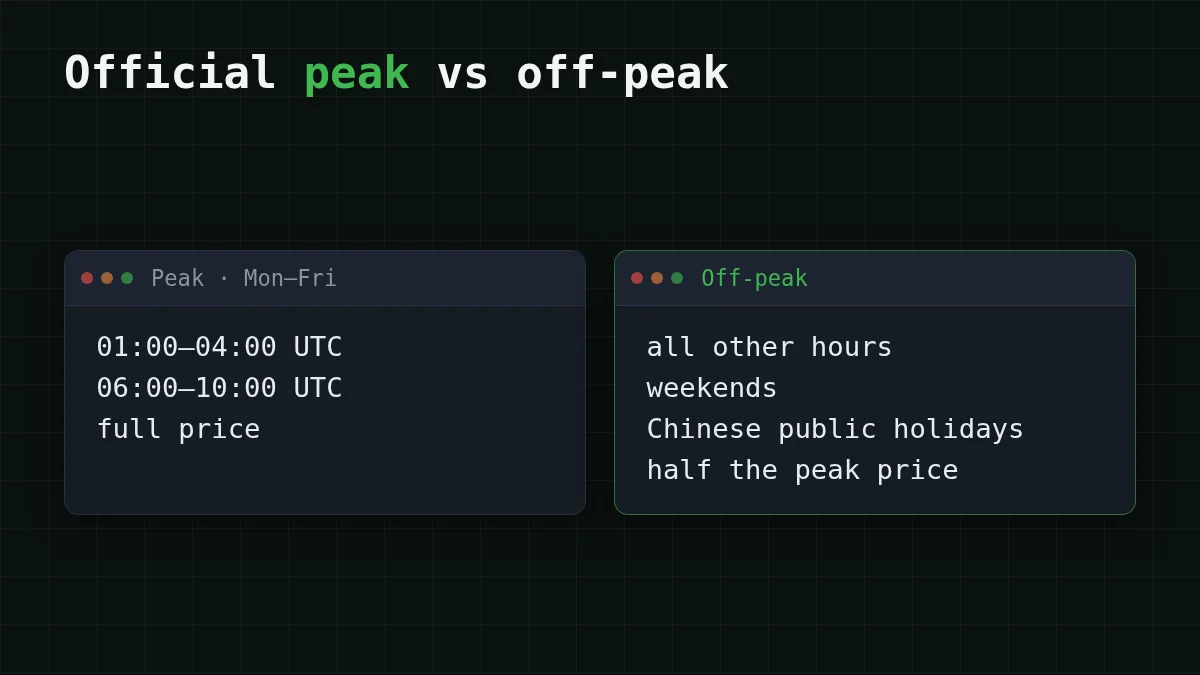
Sette ore al giorno sembrano poche. Lo sono: 7 × 5 = 35 delle 168 ore della settimana, circa un quinto. Ma quelle finestre coprono gran parte della giornata lavorativa di Pechino e la mattina europea, quindi un bot che parla con persone in quei fusi orari ci vive dentro. Un job che gira alle 22:00 UTC non vede mai il prezzo di punta.
Indovina il numero
Quante ore di un giorno feriale cadono nelle finestre di punta ufficiali?
La tua risposta
024
Mostra risposta
Risposta: 7
Sette: 01:00–04:00 sono 3 ore e 06:00–10:00 sono 4 ore, e 3 + 4 = 7.
Un bot di supporto: 1.000 richieste al giorno#
Supponi di gestire un bot di supporto. Ogni richiesta porta circa 1.500 token di input (le istruzioni più il messaggio del cliente) e restituisce circa 400 token. Sono 1,5M di input e 0,4M di output al giorno e, per semplicità, nulla di tutto ciò colpisce la cache.
Su deepseek-flash in punta, l'input è 1,5 × $0.30 = $0.45. L'output è 0,4 × $1.20 = $0.48. Un giorno arriva a $0.45 + $0.48 = $0.93. Fuori punta, l'input è 1,5 × $0.15 = $0.225 e l'output è 0,4 × $0.60 = $0.24, quindi un giorno è $0.225 + $0.24 = $0.465.
Su deepseek-v4-pro in punta, l'input è 1,5 × $1.32 = $1.98. L'output è 0,4 × $3.96 = $1.584. Un giorno arriva a $1.98 + $1.584 = $3.564.
Guarda dove vanno i soldi. Su Flash le risposte da 400 token costano poco più dei prompt da 1.500 token, perché l'output è il lato costoso. E Pro è il modello che scegli dopo che un test sui tuoi ticket mostra che le risposte di Flash non bastano, non prima: quel test vale $3.564 al giorno in punta.
Un loop di agente: dove conviene la cache#
Un agente di coding è l'opposto di un chatbot. Ogni passo reinvia lo stesso grande prefisso: istruzioni, definizioni degli strumenti, i file già letti. Supponi che un'esecuzione sia di 100 passi con 30.000 token di input e 2.000 token di output ciascuno, e che l'80% di ogni prompt sia quel prefisso ripetuto. Sono 3M di token di input (2,4M hit, 0,6M miss) e 0,2M di token di output.
Su deepseek-flash in punta, senza cache: 3 × $0.30 = $0.90 per l'input più 0,2 × $1.20 = $0.24 per l'output, $0.90 + $0.24 = $1.14.
Con l'80% di hit rate: 2,4 × $0.006 = $0.0144 per gli hit, 0,6 × $0.30 = $0.18 per i miss, e gli stessi $0.24 per l'output, $0.0144 + $0.18 + $0.24 = $0.4344.
La cache ha portato l'input da $0.90 a $0.1944 e ha reso l'output la voce più grande della bolletta. È il pattern degli agenti: una volta che il prefisso è in cache, le risposte costano più della lettura. Mantieni identico l'inizio del prompt da un passo all'altro e metti alla fine ciò che cambia.
Cambia i numeri con il tuo loop:
Calcolatore di costi
Un agente di coding: 100 passi
Token di input per richiesta: 30.000 · Token di output per richiesta: 2000 · Richieste al giorno: 100
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
Il calcolatore usa i prezzi live, quindi si muove quando si muove il listino. Le cifre ufficiali sopra restano al 29 ottobre 2026.
Quale configurazione si adatta al tuo lavoro#
Scegli il tuo caso
Scegli il lavoro più vicino
Scegli un'opzione per vedere la risposta
Bot di supporto, traffico tutto il giorno
Il traffico non aspetta le ore fuori punta. Ufficialmente, deepseek-flash in punta è il numero con cui pianificare: $0.30 di input e $1.20 di output per 1M token. Un prezzo unico a ogni ora, come DeepSeek-V4-Flash su CheapTokens, rende facile prevedere la bolletta mensile.
Job batch notturno
Sposta la pianificazione fuori da 01:00–04:00 e 06:00–10:00 UTC e si applica il prezzo ufficiale fuori punta, metà della punta. Se il job non può spostarsi, il prezzo di punta è quello reale.
Agente con un grande prompt ripetuto
Mantieni stabile il prefisso del prompt così che l'hit rate della cache resti alto, e aspettati che l'output diventi la parte più grande della bolletta. Un prezzo fisso senza finestre di punta rende facile fare budget per un loop come questo.
Flash non basta
Testa deepseek-v4-pro su un campione dei tuoi task prima. Il suo input con cache miss è $1.32 in punta e il suo output è $3.96, quindi dovrebbe guadagnarsi quel prezzo sui tuoi dati.
Gli stessi carichi su CheapTokens#
Per il bot di supporto e il loop di agente, CheapTokens ha DeepSeek-V4-Flash: id deepseek-, context 380K, fino a 32.768 token di output per risposta. È un prezzo unico a qualsiasi ora, senza finestre di punta, un saldo per tutti i modelli e un'API compatibile con OpenAI e Anthropic su https:/. In totale, contando insieme input e output, è più economico di OpenRouter.
Una richiesta del bot di supporto (1.500 in, 400 out) costa $0.000063. L'esecuzione dell'agente da 100 passi sopra (3M in, 0,2M out) costa $0.065. La tabella sotto è la giornata del bot, 1.000 richieste, su tutti i nostri modelli con la colonna OpenRouter accanto; mettila a confronto con le cifre ufficiali sopra:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
1500 token di input e 400 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
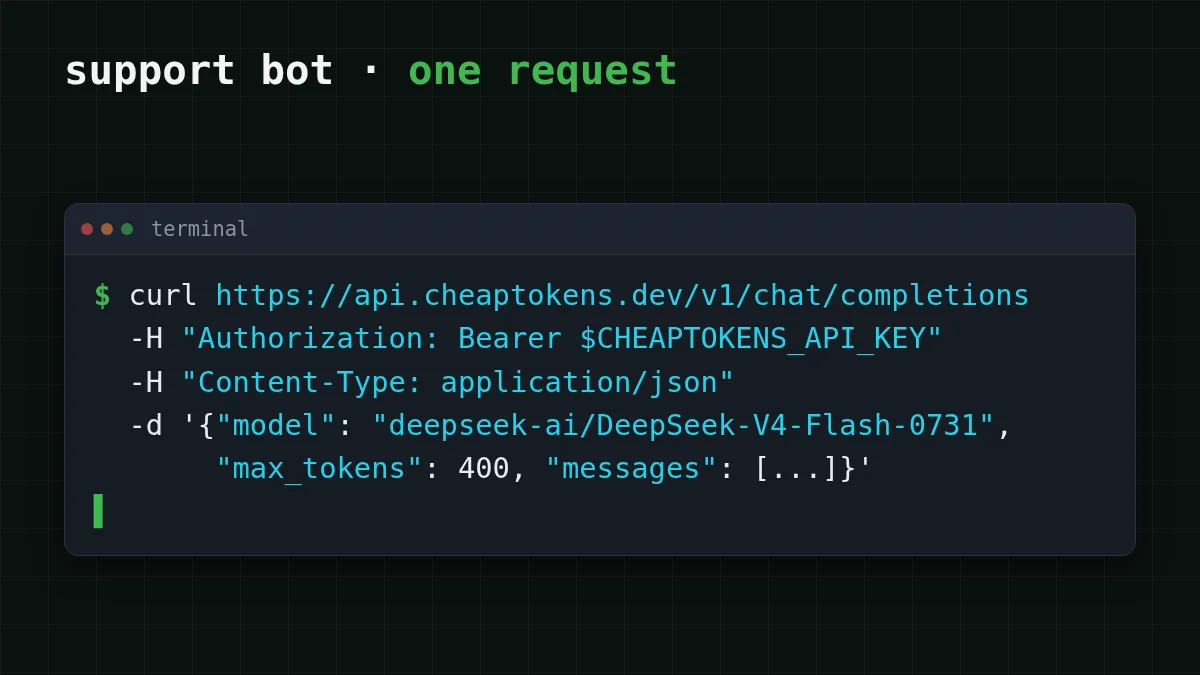
Per inviare tu stesso la richiesta del bot (usa l'id esattamente come scritto; gli id brevi delle etichette di prezzo non sono accettati):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
La risposta ha un blocco usage con i conteggi reali dei token di input e output. Moltiplicali per i prezzi live, o incollali nella tabella sopra, e hai il costo della tua richiesta invece di una stima.
Per i dettagli di connessione vedi la documentazione di CheapTokens, la pagina DeepSeek e la tabella dei prezzi live. Se stai confrontando DeepSeek con un'altra famiglia, MiniMax-M2.7 vs DeepSeek-V4-Flash li mette a confronto sugli stessi task.


