Modelos y comparativasComparativa
El modelo de API DeepSeek más barato en 2026: deepseek-flash vs Pro
Precios oficiales de la API DeepSeek comprobados el 29 de octubre de 2026: Flash vs Pro, punta vs fuera de punta, aciertos de caché y lo que realmente cuestan un bot de soporte y un agente.
En esta página
Tu factura de DeepSeek depende de tres cosas que el precio por token no muestra: qué modelo llamas, a qué hora lo llamas y cuánto de tu prompt recuerda la caché. La respuesta corta: de los dos modelos oficiales, deepseek-flash es el más barato en todas las columnas. Fuera de horas punta cuesta $0.15 por 1M de tokens de entrada (fallo de caché) y $0.60 por 1M de tokens de salida. En hora punta, ambos se duplican.
Los precios a continuación provienen de la página de precios de DeepSeek, consultada el 29 de octubre de 2026. La página no indica fecha de publicación, así que toma la fecha de consulta como fecha de precio.
Dos modelos oficiales, un cambio de nombre#
La API oficial vende dos modelos: deepseek-flash, servido por DeepSeek-V4.1-Flash-1017, y deepseek-v4-pro, servido por DeepSeek-V4-Pro-0813. Ambos listan un contexto de 1M y hasta 384K tokens de salida.
Si tu código todavía dice deepseek- o deepseek-, nada se rompe. La nota de lanzamiento del 17 de octubre de 2026 de DeepSeek dice que esos modelos están retirados y sus nombres ahora enrutan a DeepSeek-V4.1-Flash-1017 al precio de Flash. Lo que cambió dentro del modelo se cubre en el artículo del lanzamiento.
Aquí están los precios por 1M de tokens, en USD:
Desplaza la tabla hacia la derecha →
| Por 1M de tokens | Flash, fuera de punta | Flash, punta | Pro, fuera de punta | Pro, punta |
|---|---|---|---|---|
| Entrada, acierto de caché | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada, fallo de caché | $0.15 | $0.30 | $0.66 | $1.32 |
| Salida | $0.60 | $1.20 | $1.98 | $3.96 |
"Acierto de caché" significa que DeepSeek reconoce el inicio de tu prompt de una solicitud anterior y factura esa parte a la tarifa barata. Explicación del almacenamiento en caché de prompts tiene la mecánica. Todo lo que no es un acierto es un fallo.
Horas punta: misma solicitud, doble precio#
La hora punta es de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excepto festivos públicos chinos. Fuera de esas ventanas pagas el precio fuera de punta, que es la mitad.
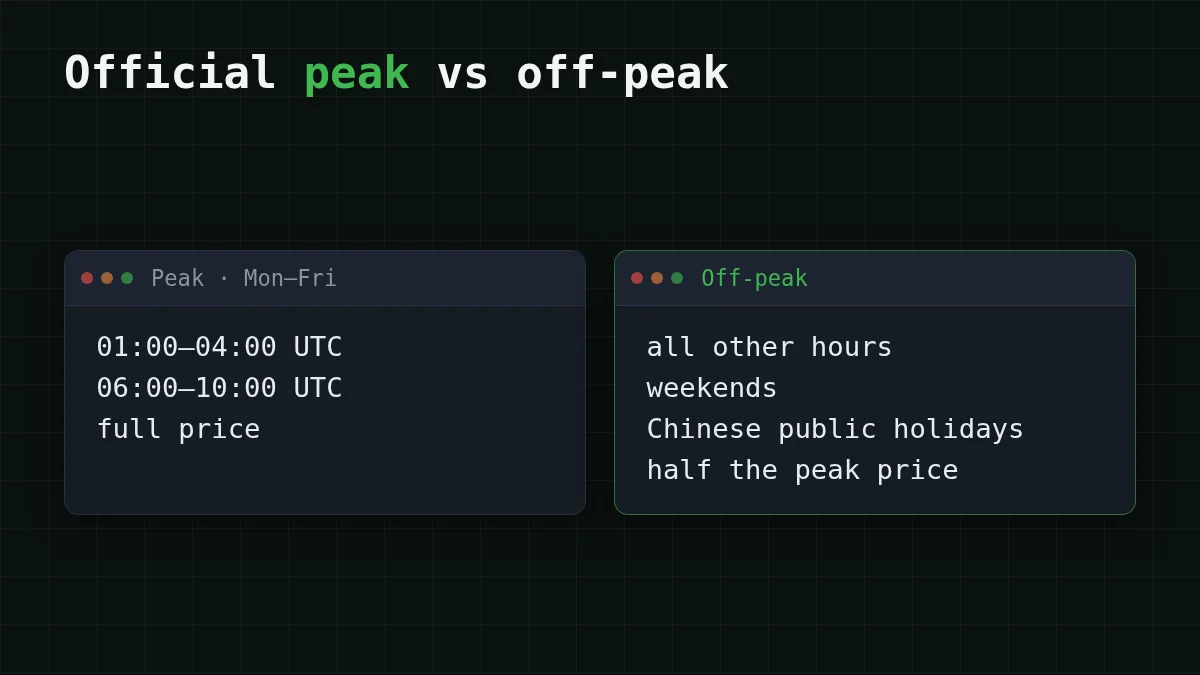
Siete horas al día suena poco. Lo es: 7 × 5 = 35 de las 168 horas de la semana, aproximadamente una quinta parte. Pero esas ventanas cubren la mayor parte de la jornada laboral de Pekín y la mañana europea, así que un bot que habla con personas en esas zonas horarias vive dentro de ellas. Un trabajo que se ejecuta a las 22:00 UTC nunca ve precios de punta.
Adivina el número
¿Cuántas horas de un día laborable caen dentro de las ventanas oficiales de punta?
Tu respuesta
024
Mostrar respuesta
Respuesta: 7
Siete: de 01:00 a 04:00 son 3 horas y de 06:00 a 10:00 son 4 horas, y 3 + 4 = 7.
Un bot de soporte: 1.000 solicitudes al día#
Supongamos que ejecutas un bot de soporte. Cada solicitud lleva unos 1.500 tokens de entrada (las instrucciones más el mensaje del cliente) y devuelve unos 400 tokens. Eso son 1,5M de entrada y 0,4M de salida al día, y por simplicidad nada de eso acierta en la caché.
En deepseek-flash en hora punta, la entrada es 1,5 × $0.30 = $0.45. La salida es 0,4 × $1.20 = $0.48. Un día suma $0.45 + $0.48 = $0.93. Fuera de punta, la entrada es 1,5 × $0.15 = $0.225 y la salida es 0,4 × $0.60 = $0.24, así que un día es $0.225 + $0.24 = $0.465.
En deepseek-v4-pro en hora punta, la entrada es 1,5 × $1.32 = $1.98. La salida es 0,4 × $3.96 = $1.584. Un día suma $1.98 + $1.584 = $3.564.
Fíjate en dónde va el dinero. En Flash las respuestas de 400 tokens cuestan un poco más que los prompts de 1.500 tokens, porque la salida es el lado caro. Y Pro es el modelo que eliges después de que una prueba con tus propios tickets muestre que las respuestas de Flash se quedan cortas, no antes: esa prueba vale $3.564 al día en hora punta.
Un bucle de agente: dónde compensa la caché#
Un agente de programación es lo contrario de un chatbot. Cada paso reenvía el mismo prefijo grande: instrucciones, definiciones de herramientas, los archivos que ya ha leído. Supongamos que una ejecución son 100 pasos con 30.000 tokens de entrada y 2.000 tokens de salida cada uno, y el 80% de cada prompt es ese prefijo repetido. Eso son 3M de tokens de entrada (2,4M de aciertos, 0,6M de fallos) y 0,2M de tokens de salida.
En deepseek-flash en hora punta, sin caché alguna: 3 × $0.30 = $0.90 por entrada más 0,2 × $1.20 = $0.24 por salida, $0.90 + $0.24 = $1.14.
Con la tasa de acierto del 80%: 2,4 × $0.006 = $0.0144 por los aciertos, 0,6 × $0.30 = $0.18 por los fallos, y los mismos $0.24 por salida, $0.0144 + $0.18 + $0.24 = $0.4344.
La caché llevó la entrada de $0.90 a $0.1944 e hizo de la salida la línea más grande de la factura. Ese es el patrón con agentes: una vez que el prefijo está en caché, las respuestas cuestan más que la lectura. Mantén el inicio de tu prompt idéntico de paso a paso, y pon lo que cambia al final.
Cambia los números a tu propio bucle:
Calculadora de costos
Un agente de programación: 100 pasos
Tokens de entrada por solicitud: 30.000 · Tokens de salida por solicitud: 2000 · Solicitudes por día: 100
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
La calculadora usa precios en vivo, así que se mueve cuando lo hace la lista de precios. Las cifras oficiales anteriores se mantienen a fecha de 29 de octubre de 2026.
Qué configuración encaja con tu trabajo#
Elige tu caso
Elige el trabajo más cercano
Elige una opción para ver la respuesta
Bot de soporte, tráfico todo el día
El tráfico no espera a fuera de punta. Oficialmente, deepseek-flash en hora punta es el número con el que planificar: $0.30 de entrada y $1.20 de salida por 1M de tokens. Un precio único a cualquier hora, como DeepSeek-V4-Flash en CheapTokens, hace que la factura mensual sea fácil de predecir.
Trabajo por lotes nocturno
Mueve la programación fuera de 01:00–04:00 y 06:00–10:00 UTC y se aplica el precio oficial fuera de punta, la mitad de la punta. Si el trabajo no puede moverse, el precio de punta es el real.
Agente con un prompt repetido grande
Mantén el prefijo del prompt estable para que la tasa de acierto de caché se mantenga alta, y espera que la salida se convierta en la mayor parte de la factura. Un precio plano sin ventanas de punta hace que un bucle como este sea fácil de presupuestar.
Flash no es suficientemente bueno
Prueba deepseek-v4-pro con una muestra de tus propias tareas primero. Su entrada con fallo de caché es $1.32 en hora punta y su salida es $3.96, así que debería ganarse ese precio con tus datos.
Las mismas cargas en CheapTokens#
Para el bot de soporte y el bucle de agente, CheapTokens tiene DeepSeek-V4-Flash: id deepseek-, contexto de 380K, hasta 32.768 tokens de salida por respuesta. Es un precio único a cualquier hora, sin ventanas de punta, un saldo para todos los modelos, y una API compatible con OpenAI y Anthropic en https:/. En total, contando entrada y salida juntas, es más barato que OpenRouter.
Una solicitud del bot de soporte (1.500 de entrada, 400 de salida) cuesta $0.000063. La ejecución de agente de 100 pasos anterior (3M de entrada, 0,2M de salida) cuesta $0.065. La tabla siguiente es el día del bot, 1.000 solicitudes, en todos nuestros modelos con la columna de OpenRouter al lado; compárala con las cifras oficiales anteriores:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
1500 tokens de entrada y 400 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
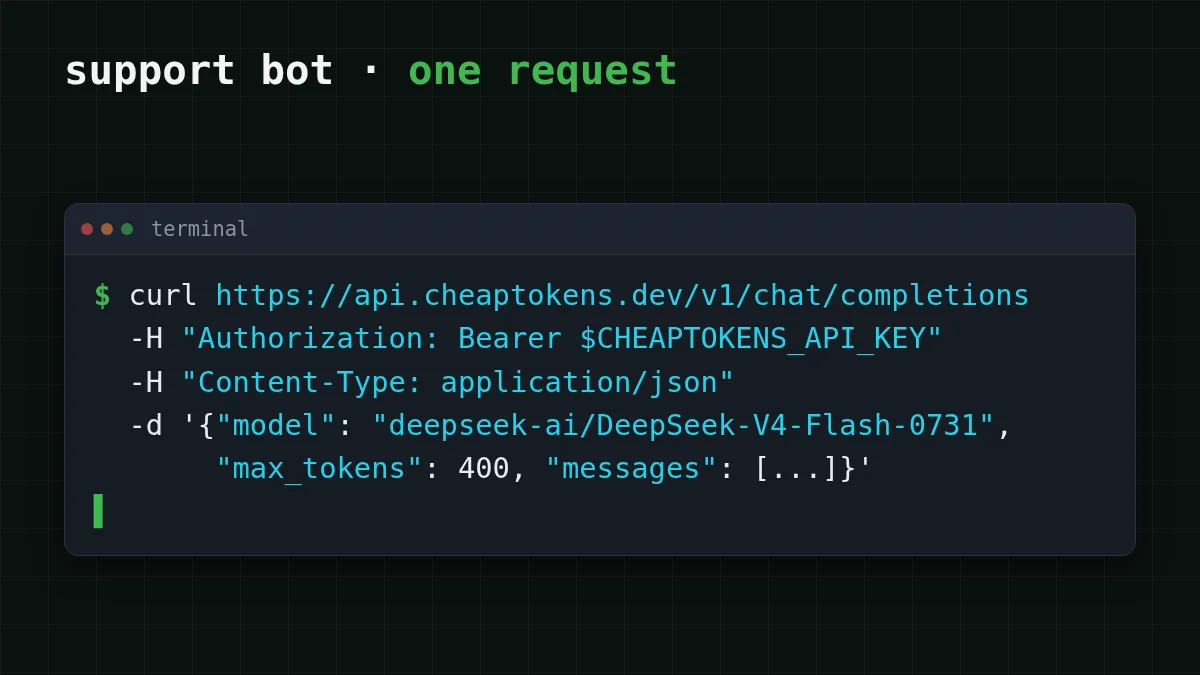
Para enviar tú mismo la solicitud del bot (usa el id exactamente como está escrito; los ids cortos de las etiquetas de precio no se aceptan):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
La respuesta tiene un bloque usage con los recuentos reales de tokens de entrada y salida. Multiplícalos por los precios en vivo, o pégalos en la tabla anterior, y tienes el coste de tu propia solicitud en lugar de una suposición.
Para los detalles de conexión consulta la documentación de CheapTokens, la página de DeepSeek y la tabla de precios en vivo. Si estás sopesando DeepSeek frente a otra familia, MiniMax-M2.7 vs DeepSeek-V4-Flash los pone lado a lado en las mismas tareas.


