Modelos y comparativasComparativa
El modelo de API Gemini más barato en 2026: precios de Flash-Lite comparados
Qué modelo Gemini tiene el precio de pago más bajo, cuáles tienen nivel gratuito, qué se duplica el 1 de dic y el 1 de ene, y cuánto cuestan 1.000 solicitudes frente a los modelos de CheapTokens.
En esta página
Quieres el modelo Gemini más barato, y la lista de precios de Google tiene más filas de las que tienes paciencia. Aquí está la versión corta. En la página de precios de la API de Gemini (actualizada el 27 de octubre de 2026, consultada el 29 de octubre), Gemini 2.5 Flash-Lite (gemini-) tiene el precio de texto de pago más bajo: $0.10 por 1M de tokens de entrada y $0.40 por 1M de tokens de salida. También tiene un nivel gratuito, al igual que Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite y Gemini 2.5 Flash. Y ya hay dos subidas de precio en la página: Gemini 4 Argon se duplica el 1 de diciembre de 2026, y Gemini 3.8 Flash y 3.6 Flash se duplican el 1 de enero de 2027.
A continuación: los precios lado a lado, qué cambia y cuándo, y cuánto cuestan 1.000 solicitudes normales en Gemini frente a los modelos que puedes llamar a través de CheapTokens. Para la mecánica exacta de la facturación, tokens de entrada vs salida es la explicación breve.
Precios de Gemini hoy, por 1M de tokens#
Estos son los precios de texto estándar del nivel de pago de la página de precios de Google, a fecha del 29 de octubre de 2026.
Desplaza la tabla hacia la derecha →
| Modelo | Entrada | Salida | Nivel gratuito |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | sí |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | sí |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | sí |
| Gemini 2.5 Flash | $0.30 | $2.50 | sí |
| Gemini 4 Argon | $2.00 | $10.00 | no |
Hay algunas cosas escondidas en las notas al pie. La entrada de audio cuesta más en los modelos Flash-Lite ($0.30 en 2.5 Flash-Lite, $0.50 en 3.1 Flash-Lite), así que un pipeline de voz no coincidirá con esta tabla. La API Batch aplica un 50% de descuento, pero es asíncrona: envías un trabajo y recoges los resultados más tarde, así que encaja en trabajos nocturnos, no en una ventana de chat. Y la columna de salida se titula Salida (incl. pensamiento), lo que importa más de lo que parece. Más sobre eso en un momento.
Gemini 3.1 Pro Preview está más arriba, a $2.00 / $12.00 para prompts de hasta 200k tokens y $4.00 / $18.00 por encima de eso. Solo él y Gemini 2.5 Pro tienen esa división en 200k.
Qué precios se duplican, y cuándo#
Si haces prototipos en un nivel gratuito, planifica el precio de pago desde el primer día y ten en cuenta estas fechas. Nuestro artículo aparte sobre precios de Gemini 4 Argon cubre ese modelo en detalle.
Línea de tiempo
Cambios de precio de Gemini ya presentes en la página de Google
- 27 oct 2026última actualización de la página de precios; Gemini 2.5 Flash-Lite es el precio de texto de pago más bajo
- 1 dic 2026Gemini 4 Argon pasa de $2.00 / $10.00 a $4.00 / $20.00 por 1M de tokens
- 1 ene 2027Gemini 3.8 Flash y Gemini 3.6 Flash pasan de $0.75 / $3.75 a $1.50 / $7.50 por 1M de tokens
Fíjate en lo que no está en esa lista: los tres modelos Flash-Lite. Sus precios se mantienen como en la tabla. Gemini 3.6 Flash está etiquetado como generación anterior en la página, así que si hoy eliges un nuevo modelo Flash, la subida es una razón más para mirar las filas más baratas.
La página de precios no da fecha de apagado para gemini-. Antes de construir un producto de un año sobre la fila más barata, abre la página de deprecaciones de Google y busca una.
Cuánto cuestan 1.000 solicitudes#
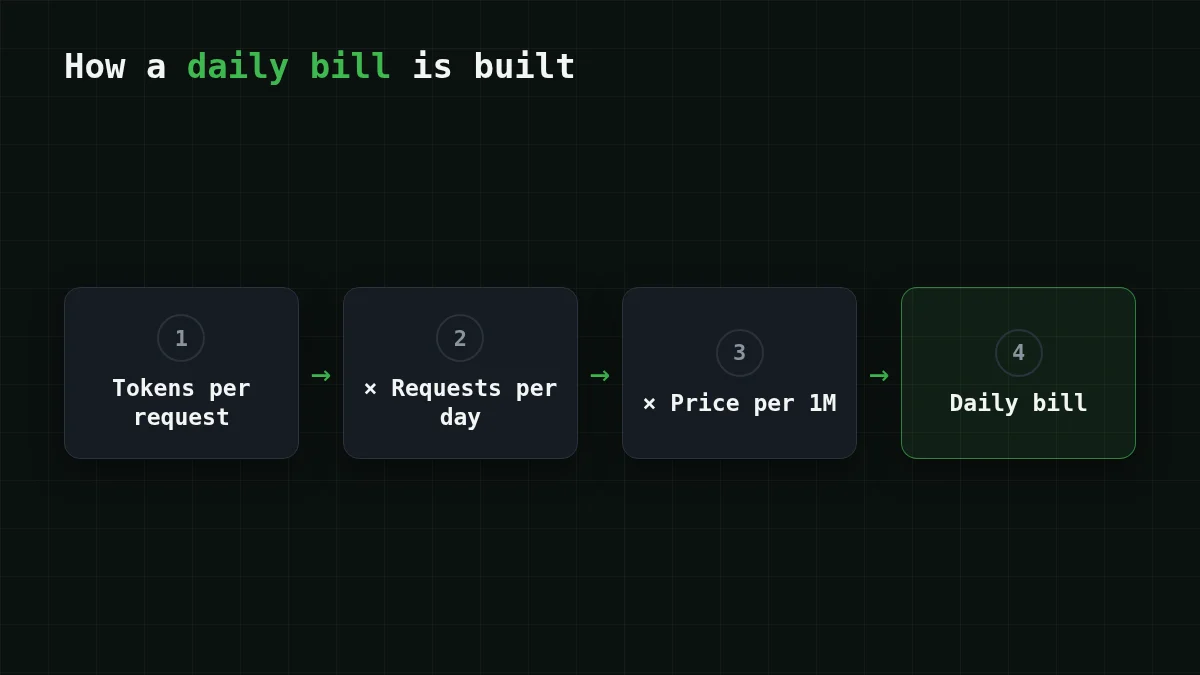
El precio por 1M de tokens es difícil de sentir. Una tarea es más fácil. Digamos que ejecutas un bot de soporte que resume tickets: cada solicitud envía unos 800 tokens de entrada y recibe unos 300 tokens de salida. Mil solicitudes son entonces 0.8M de tokens de entrada y 0.3M de tokens de salida. Con los precios estándar de Gemini:
- Gemini 2.5 Flash-Lite: entrada 0.8 × $0.10 = $0.08, salida 0.3 × $0.40 = $0.12, así que $0.08 + $0.12 = $0.20 en total.
- Gemini 3.1 Flash-Lite: entrada 0.8 × $0.25 = $0.20, salida 0.3 × $1.50 = $0.45, así que $0.20 + $0.45 = $0.65 en total.
- Gemini 3.5 Flash-Lite: entrada 0.8 × $0.30 = $0.24, salida 0.3 × $2.50 = $0.75, así que $0.24 + $0.75 = $0.99 en total.
- Gemini 4 Argon: entrada 0.8 × $2.00 = $1.60, salida 0.3 × $10.00 = $3.00, así que $1.60 + $3.00 = $4.60 ahora, y 0.8 × $4.00 = $3.20 más 0.3 × $20.00 = $6.00 da $9.20 desde el 1 de diciembre.
¿Ves el patrón? El precio de salida es el que hace daño. Las generaciones Flash-Lite difieren poco en entrada ($0.10 a $0.30) pero la salida sube de $0.40 a $2.50, y una carga de trabajo de respuestas cortas lo nota.
Ahora las mismas 1.000 solicitudes a través de CheapTokens. Primero una línea: MiniMax-M2.7 (MiniMaxAI/) ejecuta esta carga de trabajo por $0.085. La tabla en vivo de abajo tiene los tres modelos con el precio de referencia de OpenRouter al lado:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 tokens de entrada y 300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
La tabla se recalcula con los precios actuales cada vez que se carga la página, así que se mantiene correcta cuando se mueven las tarifas. La entrada y la salida se cuentan juntas, y en ese total los tres modelos de CheapTokens quedan por debajo del precio de referencia de OpenRouter. Gemini 2.5 Flash-Lite toma $0.20 por las mismas 1.000 solicitudes; la tabla de arriba muestra los totales de CheapTokens para exactamente esta carga de trabajo, entrada y salida juntas — léelos lado a lado.
La trampa de los tokens de pensamiento#
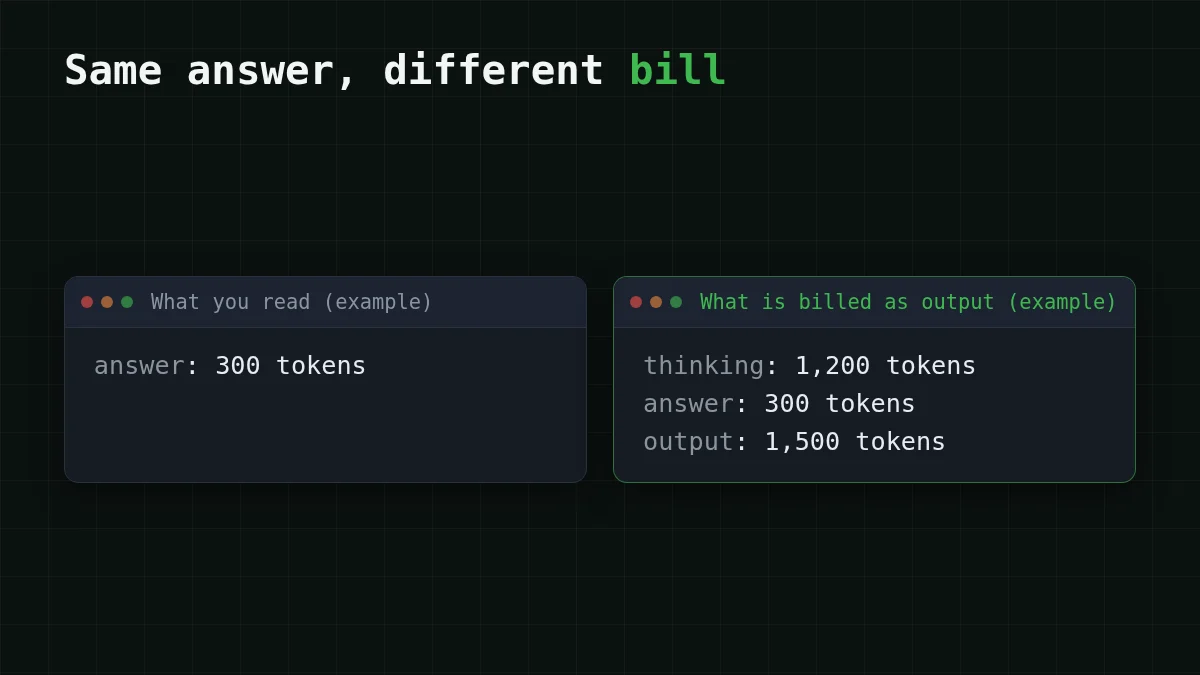
Volvamos a ese encabezado incl. pensamiento. Un modelo que piensa antes de responder escribe tokens extra que nunca ves, y Gemini los factura como salida. Digamos que cada resumen de ticket dispara 1.200 tokens de pensamiento además de la respuesta de 300 tokens. La salida por solicitud es ahora de 1.500 tokens, así que mil solicitudes dan 1.5 × $0.40 = $0.60 de salida en 2.5 Flash-Lite, frente a $0.12. La misma respuesta visible, cinco veces la línea de salida.
Verificación rápida
Tu respuesta de Gemini tiene 300 tokens de longitud, pero la factura muestra 1.500 tokens de salida. ¿Qué es lo más probable que haya pasado?
Mostrar respuesta
Respuesta: El modelo pasó unos 1.200 tokens pensando, y el pensamiento se factura como salida
La columna de salida de Google incluye tokens de pensamiento, así que el razonamiento oculto aparece en el lado de salida de la factura. Revisa los números de uso en algunas respuestas reales antes de estimar un mes.
Cuál elegir#
La fila correcta depende de lo que estés haciendo, no de una única clasificación.
Elige tu caso
¿Qué configuración encaja en tu caso?
Elige una opción para ver la respuesta
Prototipo con muy poco tráfico
Usa el nivel gratuito de Gemini en uno de los modelos que lo tienen. Trátalo como una forma de aprender, y pon el precio de pago del mismo modelo en tu presupuesto antes de lanzar.
Muchas solicitudes interactivas cortas
Gemini 2.5 Flash-Lite es la fila de pago más barata de Gemini. Compara los totales de la tabla de costes de arriba con los $0.20 de Gemini: DeepSeek-V4-Flash te da un precio fijo a cualquier hora del día, un contexto de 380K y hasta 32.768 tokens de salida por respuesta, con un solo saldo para todos los modelos.
Trabajos grandes que pueden esperar
La API Batch de Gemini reduce el precio a la mitad, si puedes vivir con resultados asíncronos. Si prefieres obtener respuestas en la misma solicitud, GLM-5.3-Flash (contexto de 390K, hasta 8.192 tokens de salida) es el modelo pequeño de bajo coste de la tabla.
Agentes de programación y bucles largos
MiniMax-M2.7 es el modelo de CheapTokens para trabajo agéntico y de programación (contexto de 180K, hasta 8.192 tokens de salida). Los bucles de agentes reenvían mucha entrada, así que mide una ejecución real primero; GLM vs DeepSeek vs MiniMax explica cómo elegir entre los tres.
El precio es solo la mitad de una elección. Ejecuta tus propios prompts en los dos o tres candidatos y compara las respuestas antes de cambiar nada.
Prueba la misma solicitud en CheapTokens#
La API es compatible con OpenAI y Anthropic, así que la llamada se parece a cualquier solicitud de chat. Obtén el id del modelo en la documentación — difiere entre proveedores — y lee usage en la respuesta: eso te da los tokens reales por solicitud para la tabla de arriba.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Los precios actuales de cada modelo están en la página de precios, y la página del modelo DeepSeek-V4-Flash tiene los detalles del modelo.


