Model & perbandinganPerbandingan
Model Gemini API termurah pada 2026: perbandingan harga Flash-Lite
Model Gemini mana yang memiliki harga berbayar terendah, mana yang punya tier gratis, apa yang naik dua kali lipat pada 1 Des dan 1 Jan, dan berapa biaya 1.000 permintaan dibandingkan model CheapTokens.
Di halaman ini
Anda ingin model Gemini termurah, dan daftar harga Google punya lebih banyak baris daripada kesabaran Anda. Berikut versi singkatnya. Di halaman harga Gemini API (diperbarui 27 Oktober 2026, dicek 29 Oktober), Gemini 2.5 Flash-Lite (gemini-) memiliki harga teks berbayar terendah: $0,10 per 1 juta token input dan $0,40 per 1 juta token output. Model ini juga punya tier gratis, seperti Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite, dan Gemini 2.5 Flash. Dan dua kenaikan harga sudah tercantum di halaman: Gemini 4 Argon naik dua kali lipat pada 1 Desember 2026, Gemini 3.8 Flash dan 3.6 Flash naik dua kali lipat pada 1 Januari 2027.
Di bawah ini: harga berdampingan, apa yang berubah dan kapan, serta berapa biaya 1.000 permintaan biasa di Gemini versus model yang bisa Anda panggil melalui CheapTokens. Untuk mekanisme penagihan yang tepat, token input vs output adalah penjelasan singkatnya.
Harga Gemini hari ini, per 1 juta token#
Ini adalah harga teks tier berbayar standar dari halaman harga Google, per 29 Oktober 2026.
Gulir tabel ke kanan →
| Model | Input | Output | Tier gratis |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0,10 | $0,40 | ya |
| Gemini 3.1 Flash-Lite | $0,25 | $1,50 | ya |
| Gemini 3.5 Flash-Lite | $0,30 | $2,50 | ya |
| Gemini 2.5 Flash | $0,30 | $2,50 | ya |
| Gemini 4 Argon | $2,00 | $10,00 | tidak |
Beberapa hal tersembunyi di catatan kaki. Input audio lebih mahal pada model Flash-Lite ($0,30 pada 2.5 Flash-Lite, $0,50 pada 3.1 Flash-Lite), jadi pipeline suara tidak akan cocok dengan tabel ini. Batch API memberi diskon 50%, tetapi bersifat asinkron: Anda mengirim job dan mengambil hasilnya nanti, jadi cocok untuk job semalam, bukan jendela chat. Dan kolom output berjudul Output (termasuk thinking), yang lebih penting daripada kelihatannya. Lebih lanjut sebentar lagi.
Gemini 3.1 Pro Preview berada lebih tinggi di $2,00 / $12,00 untuk prompt hingga 200k token dan $4,00 / $18,00 di atasnya. Hanya model ini dan Gemini 2.5 Pro yang memiliki pembagian 200k tersebut.
Harga mana yang naik dua kali lipat, dan kapan#
Jika Anda membuat prototipe di tier gratis, rencanakan harga berbayar sejak hari pertama, dan ingat tanggal-tanggal ini. Artikel terpisah kami tentang harga Gemini 4 Argon membahas model tersebut secara detail.
Garis waktu
Perubahan harga Gemini yang sudah ada di halaman Google
- 27 Okt 2026halaman harga terakhir diperbarui; Gemini 2.5 Flash-Lite adalah harga teks berbayar terendah
- 1 Des 2026Gemini 4 Argon naik dari $2,00 / $10,00 menjadi $4,00 / $20,00 per 1 juta token
- 1 Jan 2027Gemini 3.8 Flash dan Gemini 3.6 Flash naik dari $0,75 / $3,75 menjadi $1,50 / $7,50 per 1 juta token
Perhatikan apa yang tidak ada di daftar itu: tiga model Flash-Lite. Harganya tetap seperti di tabel. Gemini 3.6 Flash diberi label generasi sebelumnya di halaman, jadi jika Anda memilih model Flash baru hari ini, kenaikan itu menjadi satu alasan lagi untuk melihat baris yang lebih murah.
Halaman harga tidak memberikan tanggal penghentian untuk gemini-. Sebelum Anda membangun produk berdurasi setahun di baris termurah, buka halaman deprecation Google dan cari tanggalnya.
Berapa biaya 1.000 permintaan#
Harga per 1 juta token sulit dirasakan. Sebuah tugas lebih mudah. Katakanlah Anda menjalankan bot dukungan yang merangkum tiket: setiap permintaan mengirim sekitar 800 token masuk dan mendapat sekitar 300 token keluar. Seribu permintaan berarti 0,8 juta token input dan 0,3 juta token output. Dengan harga standar Gemini:
- Gemini 2.5 Flash-Lite: input 0,8 × $0,10 = $0,08, output 0,3 × $0,40 = $0,12, jadi $0,08 + $0,12 = $0,20 totalnya.
- Gemini 3.1 Flash-Lite: input 0,8 × $0,25 = $0,20, output 0,3 × $1,50 = $0,45, jadi $0,20 + $0,45 = $0,65 totalnya.
- Gemini 3.5 Flash-Lite: input 0,8 × $0,30 = $0,24, output 0,3 × $2,50 = $0,75, jadi $0,24 + $0,75 = $0,99 totalnya.
- Gemini 4 Argon: input 0,8 × $2,00 = $1,60, output 0,3 × $10,00 = $3,00, jadi $1,60 + $3,00 = $4,60 sekarang, dan 0,8 × $4,00 = $3,20 ditambah 0,3 × $20,00 = $6,00 menjadi $9,20 mulai 1 Desember.
Lihat polanya? Harga output yang menimbulkan kerusakan. Generasi Flash-Lite berbeda sedikit pada input ($0,10 hingga $0,30) tetapi output naik dari $0,40 ke $2,50, dan beban kerja jawaban pendek merasakannya.
Sekarang 1.000 permintaan yang sama melalui CheapTokens. Satu baris dulu: MiniMax-M2.7 (MiniMaxAI/) menjalankan beban kerja ini seharga $0.085. Tabel langsung di bawah ini memiliki ketiga model dengan harga referensi OpenRouter di sampingnya:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 token input dan 300 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Tabel menghitung ulang dari harga terkini setiap kali halaman dimuat, jadi tetap benar saat tarif berubah. Input dan output dihitung bersama, dan dalam total itu ketiga model CheapTokens berada di bawah harga referensi OpenRouter. Gemini 2.5 Flash-Lite memakan $0,20 untuk 1.000 permintaan yang sama; tabel di atas menunjukkan total CheapTokens untuk beban kerja persis ini, input dan output bersama — baca keduanya berdampingan.
Jebakan token thinking#
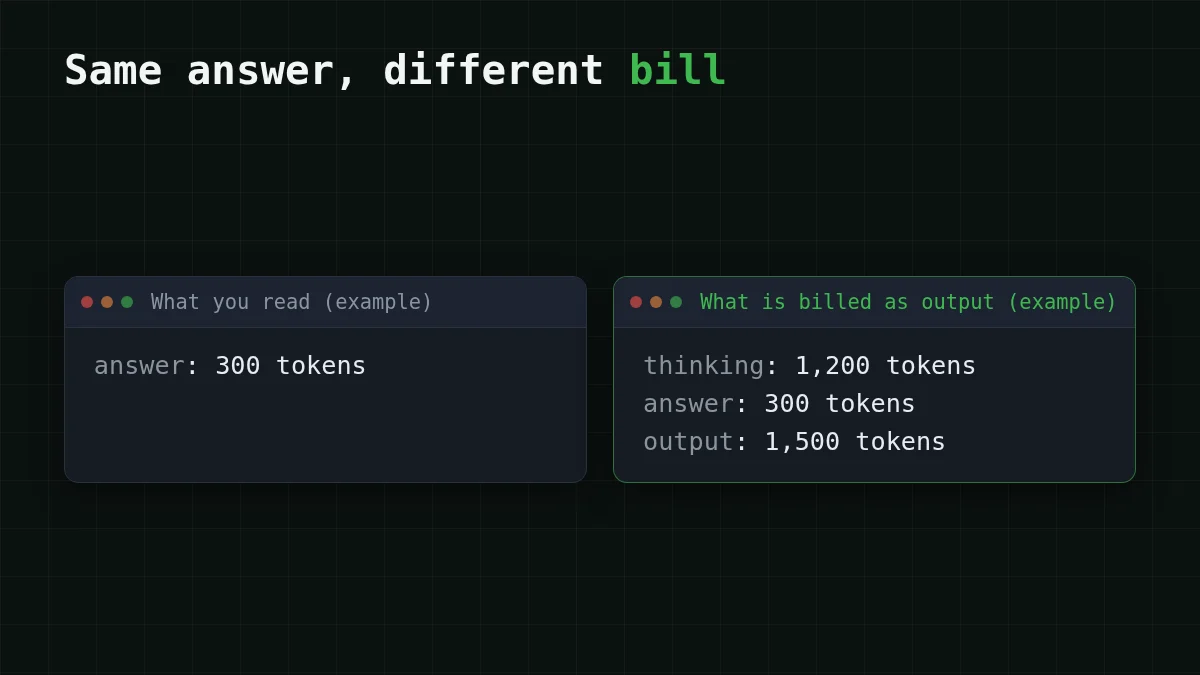
Kembali ke header termasuk thinking itu. Model yang berpikir sebelum menjawab menulis token tambahan yang tidak pernah Anda lihat, dan Gemini menagihnya sebagai output. Katakanlah setiap ringkasan tiket memicu 1.200 token thinking di atas jawaban 300 token. Output per permintaan sekarang 1.500 token, jadi seribu permintaan menghasilkan 1,5 × $0,40 = $0,60 output pada 2.5 Flash-Lite, naik dari $0,12. Jawaban terlihat sama, baris output lima kali lipat.
Cek cepat
Jawaban Gemini Anda panjangnya 300 token, tetapi tagihan menunjukkan 1.500 token output. Apa yang paling mungkin terjadi?
Tampilkan jawaban
Jawaban: Model menghabiskan sekitar 1.200 token untuk berpikir, dan thinking ditagih sebagai output
Kolom output Google mencakup token thinking, jadi penalaran tersembunyi muncul di sisi output tagihan. Periksa angka penggunaan pada beberapa respons nyata sebelum Anda memperkirakan sebulan.
Mana yang harus dipilih#
Baris yang tepat bergantung pada apa yang Anda lakukan, bukan pada satu peringkat.
Pilih kasus Anda
Pengaturan mana yang cocok untuk kasus Anda?
Pilih opsi untuk melihat jawabannya
Prototipe dengan lalu lintas sangat sedikit
Gunakan tier gratis Gemini pada salah satu model yang memilikinya. Perlakukan sebagai cara untuk belajar, dan masukkan harga berbayar model yang sama ke anggaran Anda sebelum merilis.
Banyak permintaan interaktif pendek
Gemini 2.5 Flash-Lite adalah baris Gemini berbayar termurah. Bandingkan total di tabel biaya di atas dengan $0,20 Gemini: DeepSeek-V4-Flash memberi Anda harga tetap kapan pun sepanjang hari, konteks 380K dan hingga 32.768 token output per jawaban, dengan satu saldo di semua model.
Job besar yang bisa menunggu
Batch API Gemini memotong harga setengah, jika Anda bisa menerima hasil asinkron. Jika Anda lebih suka mendapatkan jawaban dalam permintaan yang sama, GLM-5.3-Flash (konteks 390K, hingga 8.192 token output) adalah model kecil berbiaya rendah di tabel.
Agen coding dan loop panjang
MiniMax-M2.7 adalah model CheapTokens untuk pekerjaan agentic dan coding (konteks 180K, hingga 8.192 token output). Loop agen mengirim ulang banyak input, jadi ukur dulu satu proses nyata; GLM vs DeepSeek vs MiniMax membahas cara memilih di antara ketiganya.
Harga hanya setengah dari pilihan. Jalankan prompt Anda sendiri pada dua atau tiga kandidat dan bandingkan jawabannya sebelum Anda mengganti apa pun.
Coba permintaan yang sama di CheapTokens#
API ini kompatibel dengan OpenAI dan Anthropic, jadi panggilannya terlihat seperti permintaan chat biasa. Dapatkan id model dari dokumentasi — berbeda antar penyedia — dan baca usage di balasan: itu memberi Anda token nyata per permintaan untuk tabel di atas.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Harga terkini untuk setiap model ada di halaman harga, dan halaman model DeepSeek-V4-Flash memiliki detail modelnya.


