Моделі та порівнянняПорівняння
Найдешевша модель Gemini API у 2026 році: порівняння цін Flash-Lite
Яка модель Gemini має найнижчу платну ціну, які мають безкоштовний рівень, що подвоюється 1 грудня та 1 січня, і скільки коштують 1000 запитів порівняно з моделями CheapTokens.
На цій сторінці
Ви хочете найдешевшу модель Gemini, а в прайс-листі Google більше рядків, ніж у вас терпіння. Ось коротка версія. На сторінці цін Gemini API (оновлено 27 жовтня 2026 року, перевірено 29 жовтня) Gemini 2.5 Flash-Lite (gemini-) має найнижчу платну ціну за текст: $0.10 за 1 млн вхідних токенів і $0.40 за 1 млн вихідних токенів. Вона також має безкоштовний рівень, як і Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite та Gemini 2.5 Flash. І на сторінці вже є два підвищення цін: Gemini 4 Argon подвоюється 1 грудня 2026 року, Gemini 3.8 Flash і 3.6 Flash подвоюються 1 січня 2027 року.
Нижче: ціни поруч, що змінюється і коли, і скільки коштують 1000 звичайних запитів на Gemini порівняно з моделями, які можна викликати через CheapTokens. Щодо точної механіки білінгу, вхідні vs вихідні токени — це коротке пояснення.
Ціни Gemini сьогодні, за 1 млн токенів#
Це стандартні ціни платного рівня за текст з сторінки цін Google станом на 29 жовтня 2026 року.
Прокрутіть таблицю праворуч →
| Модель | Вхід | Вихід | Безкоштовний рівень |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | так |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | так |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | так |
| Gemini 2.5 Flash | $0.30 | $2.50 | так |
| Gemini 4 Argon | $2.00 | $10.00 | ні |
Кілька речей ховаються у виносках. Аудіовхід коштує дорожче на моделях Flash-Lite ($0.30 на 2.5 Flash-Lite, $0.50 на 3.1 Flash-Lite), тому голосовий конвеєр не відповідатиме цій таблиці. Batch API дає знижку 50%, але він асинхронний: ви надсилаєте завдання і збираєте результати пізніше, тому він підходить для нічних завдань, а не для вікна чату. І стовпець виходу має заголовок Вихід (вкл. мислення), що важливіше, ніж здається. Детальніше про це за хвилину.
Gemini 3.1 Pro Preview розташований вище: $2.00 / $12.00 для запитів до 200 тис. токенів і $4.00 / $18.00 понад це. Лише вона та Gemini 2.5 Pro мають цей поділ на 200 тис.
Які ціни подвоюються і коли#
Якщо ви прототипуєте на безкоштовному рівні, плануйте платну ціну з першого дня і майте на увазі ці дати. Наша окрема стаття про ціни Gemini 4 Argon детально розглядає цю модель.
Хронологія
Зміни цін Gemini, вже на сторінці Google
- 27 жовтня 2026сторінка цін востаннє оновлена; Gemini 2.5 Flash-Lite має найнижчу платну ціну за текст
- 1 грудня 2026Gemini 4 Argon зростає з $2.00 / $10.00 до $4.00 / $20.00 за 1 млн токенів
- 1 січня 2027Gemini 3.8 Flash і Gemini 3.6 Flash зростають з $0.75 / $3.75 до $1.50 / $7.50 за 1 млн токенів
Зверніть увагу, чого немає у цьому списку: трьох моделей Flash-Lite. Їхні ціни залишаються як у таблиці. Gemini 3.6 Flash позначена на сторінці як попереднє покоління, тому якщо ви обираєте нову модель Flash сьогодні, підвищення — ще одна причина звернути увагу на дешевші рядки.
Сторінка цін не вказує дати вимкнення для gemini-. Перш ніж будувати річний продукт на найдешевшому рядку, відкрийте сторінку застарілих версій Google і пошукайте її.
Скільки коштують 1000 запитів#
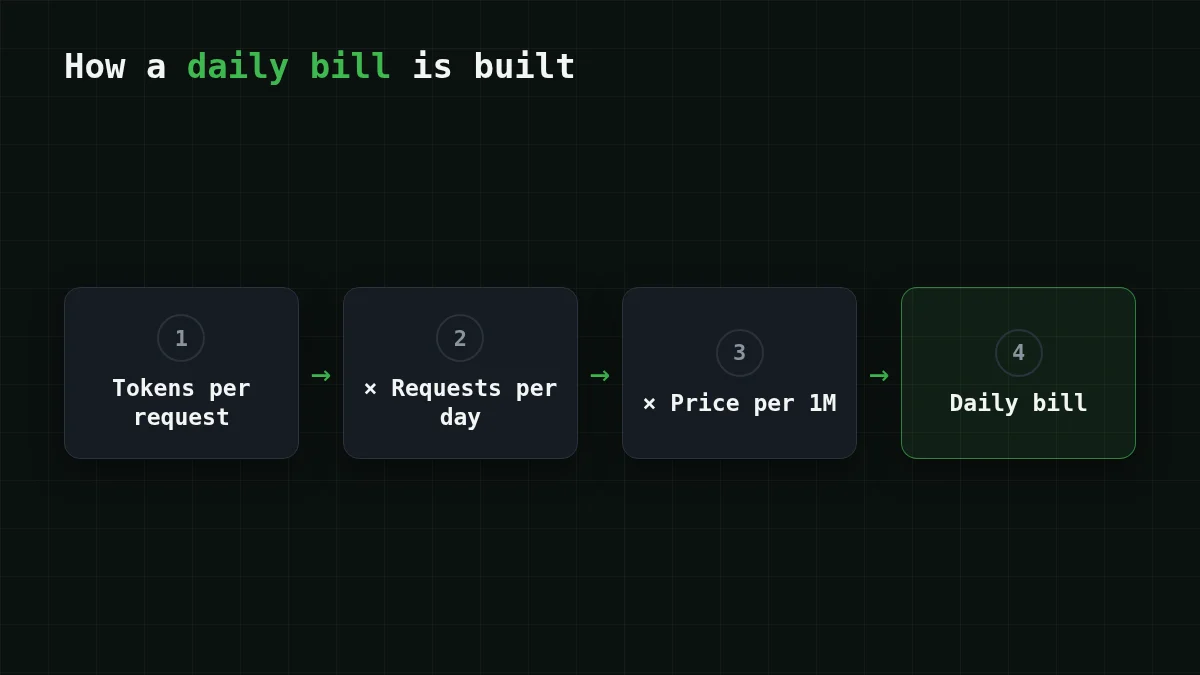
Ціну за 1 млн токенів важко відчути. Завдання — простіше. Скажімо, ви запускаєте бота підтримки, який підсумовує тікети: кожен запит надсилає близько 800 токенів на вході й отримує близько 300 токенів на виході. Тоді тисяча запитів — це 0.8 млн вхідних токенів і 0.3 млн вихідних токенів. За стандартними цінами Gemini:
- Gemini 2.5 Flash-Lite: вхід 0.8 × $0.10 = $0.08, вихід 0.3 × $0.40 = $0.12, отже $0.08 + $0.12 = $0.20 загалом.
- Gemini 3.1 Flash-Lite: вхід 0.8 × $0.25 = $0.20, вихід 0.3 × $1.50 = $0.45, отже $0.20 + $0.45 = $0.65 загалом.
- Gemini 3.5 Flash-Lite: вхід 0.8 × $0.30 = $0.24, вихід 0.3 × $2.50 = $0.75, отже $0.24 + $0.75 = $0.99 загалом.
- Gemini 4 Argon: вхід 0.8 × $2.00 = $1.60, вихід 0.3 × $10.00 = $3.00, отже $1.60 + $3.00 = $4.60 зараз, і 0.8 × $4.00 = $3.20 плюс 0.3 × $20.00 = $6.00 дає $9.20 з 1 грудня.
Бачите закономірність? Ціна виходу завдає шкоди. Покоління Flash-Lite мало відрізняються на вході ($0.10 до $0.30), але вихід зростає з $0.40 до $2.50, і навантаження з короткими відповідями це відчуває.
Тепер ті самі 1000 запитів через CheapTokens. Спочатку одне уточнення: MiniMax-M2.7 (MiniMaxAI/) виконує це навантаження за $0.085. Жива таблиця нижче містить усі три моделі з довідковою ціною OpenRouter поруч:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 вхідних і 300 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Таблиця перераховується з поточних цін щоразу, коли завантажується сторінка, тому вона залишається правильною, коли тарифи змінюються. Вхід і вихід рахуються разом, і в цьому підсумку всі три моделі CheapTokens виходять нижче довідкової ціни OpenRouter. Gemini 2.5 Flash-Lite бере $0.20 за ті самі 1000 запитів; таблиця вище показує підсумки CheapTokens саме для цього навантаження, вхід і вихід разом — читайте їх поруч.
Пастка токенів мислення#
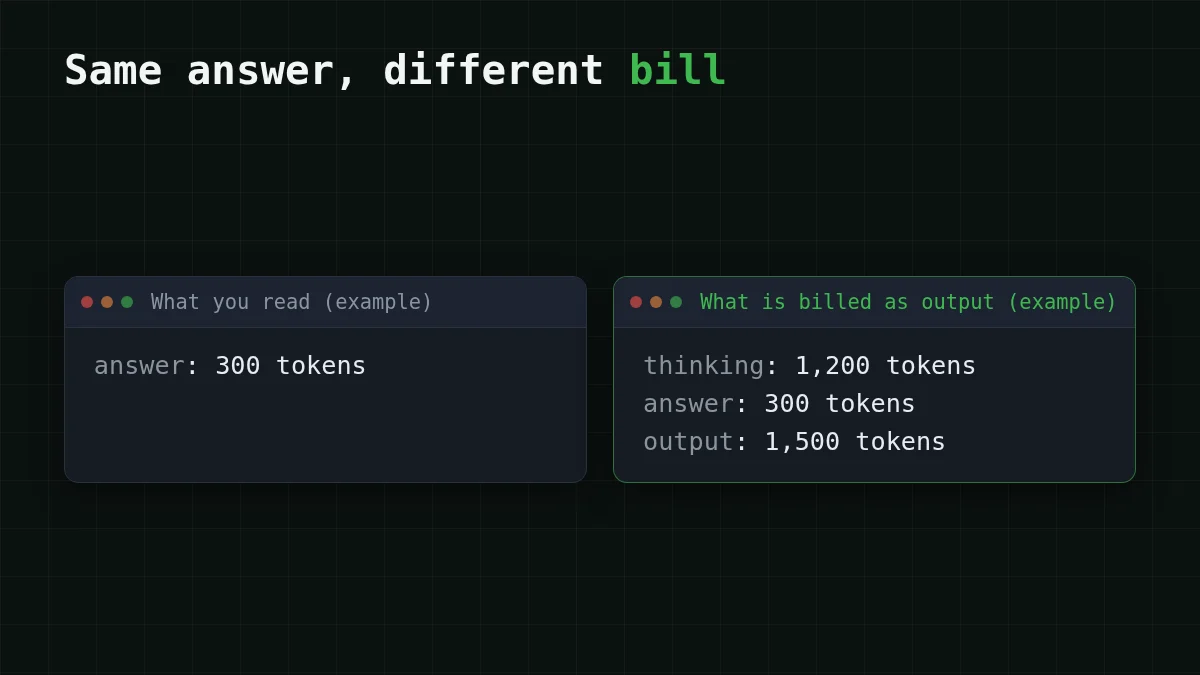
Повернімося до того заголовка вкл. мислення. Модель, яка думає перед відповіддю, записує додаткові токени, яких ви не бачите, і Gemini виставляє їх як вихід. Скажімо, кожне підсумовування тікета викликає 1200 токенів мислення поверх 300-токенної відповіді. Вихід на запит тепер 1500 токенів, тож тисяча запитів дає 1.5 × $0.40 = $0.60 виходу на 2.5 Flash-Lite, замість $0.12. Та сама видима відповідь, у п'ять разів більший рядок виходу.
Швидка перевірка
Ваша відповідь Gemini має 300 токенів, але рахунок показує 1500 вихідних токенів. Що найімовірніше сталося?
Показати відповідь
Відповідь: Модель витратила близько 1200 токенів на мислення, і мислення виставляється як вихід
Стовпець виходу Google включає токени мислення, тому приховане міркування з'являється на стороні виходу рахунку. Перевірте показники використання на кількох реальних відповідях, перш ніж оцінювати місяць.
Яку обрати#
Правильний рядок залежить від того, що ви робите, а не від єдиного рейтингу.
Оберіть свій випадок
Яка конфігурація підходить для вашого випадку?
Виберіть варіант, щоб побачити відповідь
Прототип з дуже малим трафіком
Використовуйте безкоштовний рівень Gemini на одній із моделей, які його мають. Ставтеся до нього як до способу навчання і закладіть платну ціну тієї самої моделі в бюджет, перш ніж випускати продукт.
Багато коротких інтерактивних запитів
Gemini 2.5 Flash-Lite — найдешевший платний рядок Gemini. Порівняйте підсумки в таблиці витрат вище з $0.20 у Gemini: DeepSeek-V4-Flash дає вам фіксовану ціну в будь-який час доби, контекст 380K і до 32 768 вихідних токенів на відповідь, з одним балансом для всіх моделей.
Великі завдання, які можуть зачекати
Batch API Gemini зменшує ціну вдвічі, якщо ви можете жити з асинхронними результатами. Якщо ви надаєте перевагу отриманню відповідей у тому самому запиті, GLM-5.3-Flash (контекст 390K, до 8 192 вихідних токенів) — це недорога мала модель у таблиці.
Агенти для кодування та довгі цикли
MiniMax-M2.7 — це модель CheapTokens для агентної роботи та кодування (контекст 180K, до 8 192 вихідних токенів). Агентні цикли повторно надсилають багато входу, тому спершу виміряйте реальний запуск; GLM vs DeepSeek vs MiniMax розповідає, як обирати між трьома.
Ціна — це лише половина вибору. Запустіть власні запити на двох-трьох кандидатах і порівняйте відповіді, перш ніж щось змінювати.
Спробуйте той самий запит на CheapTokens#
API сумісний з OpenAI та Anthropic, тому виклик виглядає як будь-який чат-запит. Отримайте ідентифікатор моделі з документації — він відрізняється між провайдерами — і прочитайте usage у відповіді: це дасть вам реальні токени на запит для таблиці вище.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Поточні ціни для кожної моделі є на сторінці цін, а сторінка моделі DeepSeek-V4-Flash містить деталі моделі.


