โมเดลและการเปรียบเทียบการเปรียบเทียบ
โมเดล Gemini API ที่ถูกที่สุดในปี 2026: เปรียบเทียบราคา Flash-Lite
โมเดล Gemini ใดมีราคาเสียเงินต่ำที่สุด โมเดลใดมีระดับฟรี อะไรขึ้นเป็นสองเท่าในวันที่ 1 ธ.ค. และ 1 ม.ค. และ 1,000 คำขอมีค่าใช้จ่ายเท่าใดเทียบกับโมเดล CheapTokens
ในหน้านี้
คุณต้องการโมเดล Gemini ที่ถูกที่สุด และหน้าราคาของ Google ก็มีแถวมากกว่าความอดทนของคุณ นี่คือเวอร์ชันสั้น บนหน้าราคา Gemini API (อัปเดต 27 ตุลาคม 2026 ตรวจสอบ 29 ตุลาคม) Gemini 2.5 Flash-Lite (gemini-) มีราคาข้อความแบบเสียเงินต่ำที่สุด: $0.10 ต่อ 1M โทเค็นอินพุต และ $0.40 ต่อ 1M โทเค็นเอาต์พุต นอกจากนี้ยังมีระดับฟรีเหมือนกับ Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite และ Gemini 2.5 Flash และมีการขึ้นราคาสองครั้งที่อยู่บนหน้าแล้ว: Gemini 4 Argon จะขึ้นเป็นสองเท่าในวันที่ 1 ธันวาคม 2026, Gemini 3.8 Flash และ 3.6 Flash จะขึ้นเป็นสองเท่าในวันที่ 1 มกราคม 2027
ด้านล่าง: ราคาเทียบกัน สิ่งที่เปลี่ยนแปลงและเมื่อใด และค่าใช้จ่ายของ 1,000 คำขอทั่วไปบน Gemini เทียบกับโมเดลที่คุณเรียกใช้ผ่าน CheapTokens สำหรับกลไกการเรียกเก็บเงินที่แน่นอน input vs output tokens คือคำอธิบายสั้น ๆ
ราคา Gemini วันนี้ ต่อ 1M โทเค็น#
นี่คือราคาข้อความมาตรฐานระดับเสียเงินจากหน้าราคาของ Google ณ วันที่ 29 ตุลาคม 2026
เลื่อนตารางไปทางขวา →
| โมเดล | อินพุต | เอาต์พุต | ระดับฟรี |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | ใช่ |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | ใช่ |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | ใช่ |
| Gemini 2.5 Flash | $0.30 | $2.50 | ใช่ |
| Gemini 4 Argon | $2.00 | $10.00 | ไม่ |
มีบางอย่างซ่อนอยู่ในเชิงอรรถ อินพุตเสียงมีราคาสูงกว่าในโมเดล Flash-Lite ($0.30 บน 2.5 Flash-Lite, $0.50 บน 3.1 Flash-Lite) ดังนั้นไปป์ไลน์เสียงจะไม่ตรงกับตารางนี้ Batch API ลด 50% แต่มันเป็นแบบอะซิงโครนัส: คุณส่งงานและเก็บผลลัพธ์ภายหลัง จึงเหมาะกับงานข้ามคืน ไม่ใช่หน้าต่างแชท และคอลัมน์เอาต์พุตมีหัวข้อ Output (incl. thinking) ซึ่งสำคัญกว่าที่ดู เพิ่มเติมในอีกสักครู่
Gemini 3.1 Pro Preview อยู่สูงกว่าที่ $2.00 / $12.00 สำหรับพรอมป์ต์ไม่เกิน 200k โทเค็น และ $4.00 / $18.00 เมื่อเกินกว่านั้น มีเพียงมันและ Gemini 2.5 Pro ที่มีการแบ่งที่ 200k
ราคาใดขึ้นเป็นสองเท่า และเมื่อใด#
หากคุณสร้างต้นแบบบนระดับฟรี ให้วางแผนสำหรับราคาเสียเงินตั้งแต่วันแรก และจดจำวันที่เหล่านี้ไว้ บทความแยกของเราเกี่ยวกับราคา Gemini 4 Argonครอบคลุมโมเดลนั้นโดยละเอียด
ไทม์ไลน์
การเปลี่ยนแปลงราคา Gemini ที่อยู่บนหน้า Google แล้ว
- 27 ต.ค. 2026หน้าราคาอัปเดตล่าสุด; Gemini 2.5 Flash-Lite เป็นราคาข้อความแบบเสียเงินต่ำที่สุด
- 1 ธ.ค. 2026Gemini 4 Argon ไปจาก $2.00 / $10.00 เป็น $4.00 / $20.00 ต่อ 1M โทเค็น
- 1 ม.ค. 2027Gemini 3.8 Flash และ Gemini 3.6 Flash ไปจาก $0.75 / $3.75 เป็น $1.50 / $7.50 ต่อ 1M โทเค็น
สังเกตว่าสิ่งที่ไม่อยู่ในรายการนั้น: โมเดล Flash-Lite ทั้งสาม ราคาของพวกมันยังคงเหมือนในตาราง Gemini 3.6 Flash ถูกระบุว่าเป็นรุ่นก่อนหน้าบนหน้า ดังนั้นหากคุณกำลังเลือกโมเดล Flash ใหม่วันนี้ การขึ้นราคาเป็นอีกเหตุผลหนึ่งให้ดูแถวที่ถูกกว่า
หน้าราคาไม่ได้ระบุวันที่ปิดให้บริการสำหรับ gemini- ก่อนที่คุณจะสร้างผลิตภัณฑ์ระยะเวลาหนึ่งปีบนแถวที่ถูกที่สุด ให้เปิดหน้าปลดระวางของ Google และมองหาวันที่นั้น
ค่าใช้จ่ายของ 1,000 คำขอ#
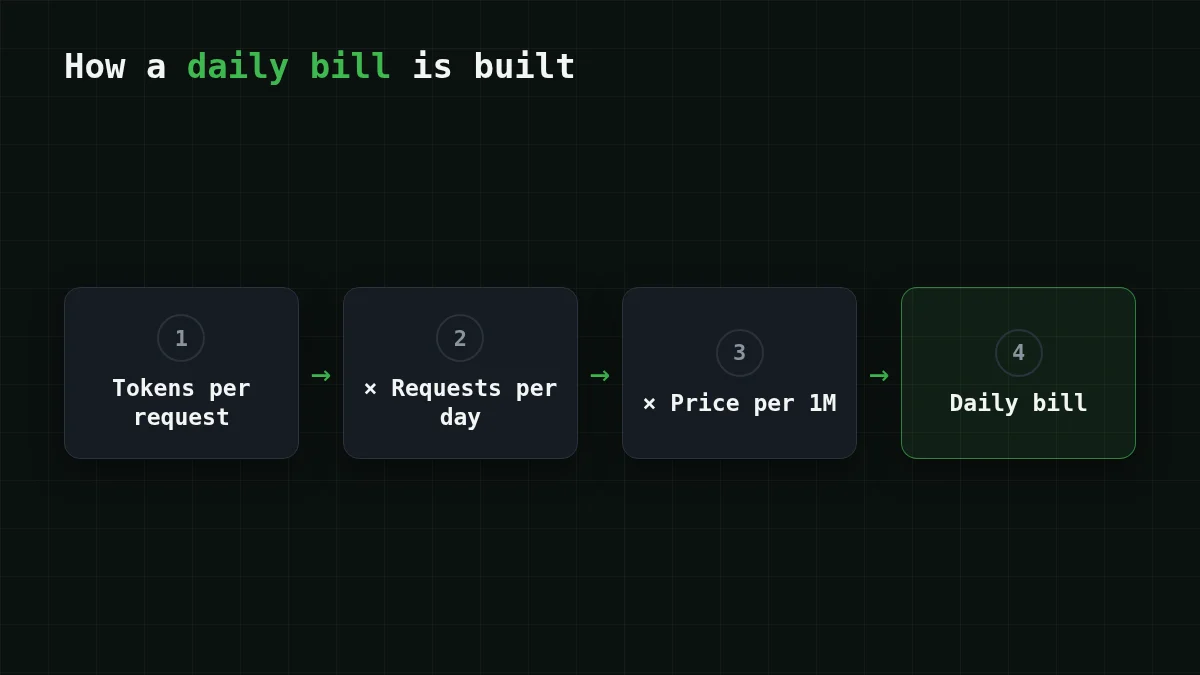
ราคาต่อ 1M โทเค็นนั้นรู้สึกได้ยาก งานหนึ่งง่ายกว่า สมมติว่าคุณรันบอทสนับสนุนที่สรุปตั๋ว: แต่ละคำขอส่งประมาณ 800 โทเค็นเข้าและได้ประมาณ 300 โทเค็นออก หนึ่งพันคำขอจึงเป็น 0.8M โทเค็นอินพุตและ 0.3M โทเค็นเอาต์พุต บนราคามาตรฐานของ Gemini:
- Gemini 2.5 Flash-Lite: อินพุต 0.8 × $0.10 = $0.08, เอาต์พุต 0.3 × $0.40 = $0.12 ดังนั้น $0.08 + $0.12 = $0.20 ทั้งหมด
- Gemini 3.1 Flash-Lite: อินพุต 0.8 × $0.25 = $0.20, เอาต์พุต 0.3 × $1.50 = $0.45 ดังนั้น $0.20 + $0.45 = $0.65 ทั้งหมด
- Gemini 3.5 Flash-Lite: อินพุต 0.8 × $0.30 = $0.24, เอาต์พุต 0.3 × $2.50 = $0.75 ดังนั้น $0.24 + $0.75 = $0.99 ทั้งหมด
- Gemini 4 Argon: อินพุต 0.8 × $2.00 = $1.60, เอาต์พุต 0.3 × $10.00 = $3.00 ดังนั้น $1.60 + $3.00 = $4.60 ตอนนี้ และ 0.8 × $4.00 = $3.20 บวก 0.3 × $20.00 = $6.00 รวมเป็น $9.20 ตั้งแต่วันที่ 1 ธันวาคม
เห็นรูปแบบไหม? ราคาเอาต์พุตสร้างความเสียหาย เจเนอเรชัน Flash-Lite ต่างกันเล็กน้อยในอินพุต ($0.10 ถึง $0.30) แต่เอาต์พุตไต่จาก $0.40 ถึง $2.50 และงานที่ตอบสั้นจะรู้สึกได้
ตอนนี้ 1,000 คำขอเดียวกันผ่าน CheapTokens ก่อนอื่นหนึ่งบรรทัด: MiniMax-M2.7 (MiniMaxAI/) รันงานนี้ในราคา $0.085 ตารางสดด้านล่างมีทั้งสามโมเดลพร้อมราคาอ้างอิงของ OpenRouter อยู่ข้าง ๆ:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 โทเค็นอินพุตและ 300 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ตารางคำนวณใหม่จากราคาปัจจุบันทุกครั้งที่หน้าโหลด จึงยังถูกต้องเมื่ออัตราเปลี่ยนแปลง อินพุตและเอาต์พุตนับรวมกัน และในผลรวมนั้นโมเดล CheapTokens ทั้งสามต่ำกว่าราคาอ้างอิงของ OpenRouter Gemini 2.5 Flash-Lite ใช้ $0.20 สำหรับ 1,000 คำขอเดียวกัน; ตารางด้านบนแสดงผลรวมของ CheapTokens สำหรับงานนี้พอดี อินพุตและเอาต์พุตรวมกัน — อ่านทั้งสองข้างเคียงกัน
กับดักโทเค็นการคิด#
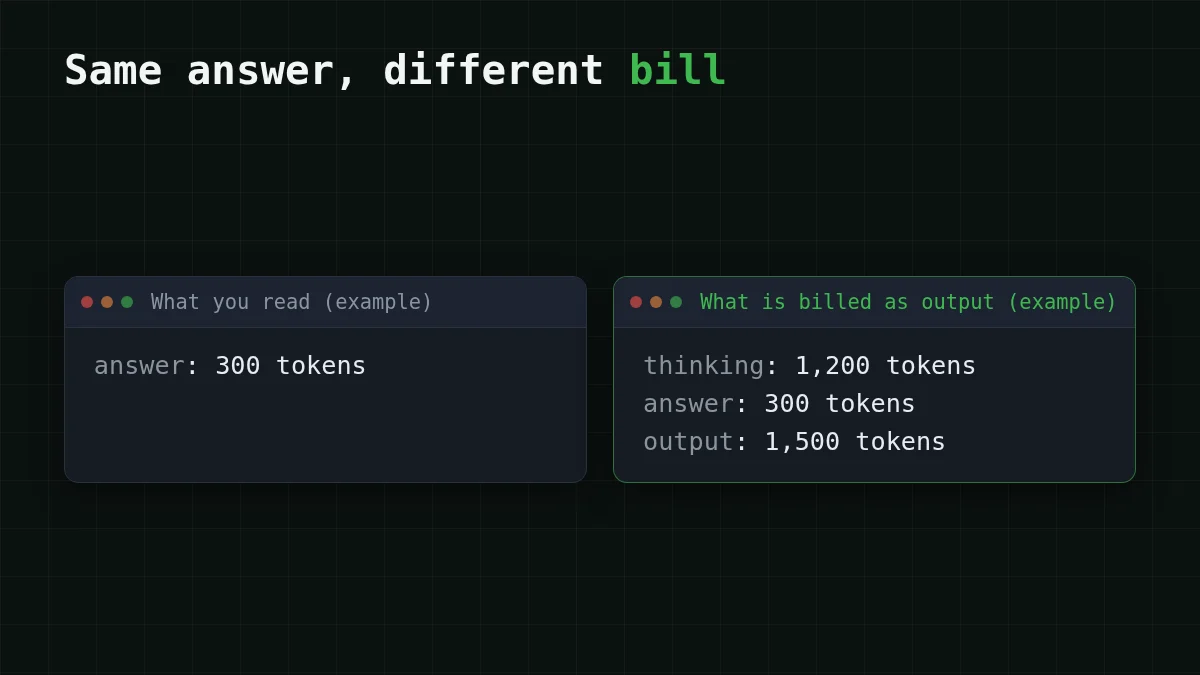
กลับไปที่หัวข้อ incl. thinking โมเดลที่คิดก่อนตอบจะเขียนโทเค็นเพิ่มเติมที่คุณไม่เห็น และ Gemini คิดเงินเป็นเอาต์พุต สมมติว่าแต่ละการสรุปตั๋วกระตุ้น 1,200 โทเค็นการคิดเพิ่มจากคำตอบ 300 โทเค็น เอาต์พุตต่อคำขอตอนนี้คือ 1,500 โทเค็น ดังนั้นหนึ่งพันคำขอให้ 1.5 × $0.40 = $0.60 ของเอาต์พุตบน 2.5 Flash-Lite เพิ่มจาก $0.12 คำตอบที่มองเห็นเหมือนกัน แต่บรรทัดเอาต์พุตเพิ่มห้าเท่า
เช็กด่วน
คำตอบ Gemini ของคุณยาว 300 โทเค็น แต่บิลแสดง 1,500 โทเค็นเอาต์พุต อะไรน่าจะเกิดขึ้น?
แสดงคำตอบ
คำตอบ: โมเดลใช้ประมาณ 1,200 โทเค็นในการคิด และการคิดถูกคิดเงินเป็นเอาต์พุต
คอลัมน์เอาต์พุตของ Google รวมโทเค็นการคิด ดังนั้นการให้เหตุผลที่ซ่อนอยู่จะปรากฏบนฝั่งเอาต์พุตของบิล ตรวจสอบตัวเลขการใช้งานบนคำตอบจริงสองสามรายการก่อนที่คุณจะประมาณการรายเดือน
เลือกอันไหน#
แถวที่ถูกต้องขึ้นอยู่กับสิ่งที่คุณทำ ไม่ใช่การจัดอันดับเดียว
เลือกกรณีของคุณ
การตั้งค่าใดเหมาะกับกรณีของคุณ?
เลือกตัวเลือกเพื่อดูคำตอบ
ต้นแบบที่มีทราฟฟิกน้อยมาก
ใช้ระดับฟรีของ Gemini บนหนึ่งในโมเดลที่มี มองมันเป็นวิธีเรียนรู้ และใส่ราคาเสียเงินของโมเดลเดียวกันในงบประมาณก่อนที่คุณจะเปิดตัว
คำขอโต้ตอบสั้น ๆ จำนวนมาก
Gemini 2.5 Flash-Lite เป็นแถว Gemini แบบเสียเงินที่ถูกที่สุด เปรียบเทียบผลรวมในตารางค่าใช้จ่ายด้านบนกับ $0.20 ของ Gemini: DeepSeek-V4-Flash ให้ราคาคงที่ทุกเวลาของวัน คอนเท็กซ์ 380K และเอาต์พุตสูงสุด 32,768 โทเค็นต่อคำตอบ พร้อมยอดคงเหลือเดียวในทุกโมเดล
งานใหญ่ที่รอได้
Batch API ของ Gemini ลดราคาครึ่งหนึ่ง หากคุณอยู่กับผลลัพธ์แบบอะซิงโครนัสได้ หากคุณอยากได้คำตอบในคำขอเดียวกัน GLM-5.3-Flash (คอนเท็กซ์ 390K, เอาต์พุตสูงสุด 8,192 โทเค็น) เป็นโมเดลเล็กต้นทุนต่ำในตาราง
เอเจนต์เขียนโค้ดและลูปยาว
MiniMax-M2.7 เป็นโมเดล CheapTokens สำหรับงานเอเจนต์และการเขียนโค้ด (คอนเท็กซ์ 180K, เอาต์พุตสูงสุด 8,192 โทเค็น) ลูปเอเจนต์ส่งอินพุตซ้ำมาก ดังนั้นวัดการรันจริงก่อน; GLM vs DeepSeek vs MiniMax อธิบายวิธีเลือกระหว่างทั้งสาม
ราคาเป็นเพียงครึ่งหนึ่งของการเลือก รันพรอมป์ต์ของคุณเองบนสองหรือสามตัวเลือกและเปรียบเทียบคำตอบก่อนที่คุณจะเปลี่ยนอะไร
ลองคำขอเดียวกันบน CheapTokens#
API เข้ากันได้กับ OpenAI และ Anthropic ดังนั้นการเรียกจึงดูเหมือนคำขอแชททั่วไป รับ id โมเดลจากเอกสาร — มันแตกต่างกันระหว่างผู้ให้บริการ — และอ่าน usage ในคำตอบ: นั่นให้โทเค็นจริงต่อคำขอสำหรับตารางด้านบน
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'ราคาปัจจุบันของทุกโมเดลอยู่บนหน้าราคา และหน้าโมเดล DeepSeek-V4-Flash มีรายละเอียดโมเดล


