Mga modelo at paghahambingPaghahambing
Pinakamurang Gemini API model sa 2026: inihambing ang mga presyo ng Flash-Lite
Aling Gemini model ang may pinakamababang bayad na presyo, alin ang may free tier, ano ang dodoble sa 1 Dis at 1 Ene, at magkano ang 1,000 request kumpara sa mga model ng CheapTokens.
Sa pahinang ito
Gusto mo ng pinakamurang Gemini model, at ang listahan ng presyo ng Google ay may mas maraming row kaysa sa pasensya mo. Narito ang maikling bersyon. Sa pahina ng presyo ng Gemini API (na-update noong 27 Oktubre 2026, sinuri noong 29 Oktubre), ang Gemini 2.5 Flash-Lite (gemini-) ang may pinakamababang bayad na presyo para sa text: $0.10 kada 1M input tokens at $0.40 kada 1M output tokens. Mayroon din itong free tier, tulad ng Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite at Gemini 2.5 Flash. At may dalawang pagtaas ng presyo na nasa pahina na: ang Gemini 4 Argon ay dodoble sa 1 Disyembre 2026, ang Gemini 3.8 Flash at 3.6 Flash ay dodoble sa 1 Enero 2027.
Sa ibaba: ang mga presyo nang magkatabi, ano ang magbabago at kailan, at magkano ang 1,000 ordinaryong request sa Gemini kumpara sa mga model na maaari mong tawagan sa pamamagitan ng CheapTokens. Para sa eksaktong mekanika ng billing, ang input vs output tokens ang maikling paliwanag.
Mga presyo ng Gemini ngayon, kada 1M tokens#
Ito ang mga standard na bayad na presyo para sa text mula sa pahina ng presyo ng Google, noong 29 Oktubre 2026.
I-scroll ang table pakanan →
| Model | Input | Output | Free tier |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | oo |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | oo |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | oo |
| Gemini 2.5 Flash | $0.30 | $2.50 | oo |
| Gemini 4 Argon | $2.00 | $10.00 | wala |
May ilang bagay na nakatago sa mga footnote. Mas mahal ang audio input sa mga Flash-Lite model ($0.30 sa 2.5 Flash-Lite, $0.50 sa 3.1 Flash-Lite), kaya ang isang voice pipeline ay hindi tutugma sa table na ito. Ang Batch API ay may 50% diskwento, ngunit ito ay asynchronous: magsusumite ka ng job at kukunin ang mga resulta mamaya, kaya bagay ito sa mga overnight job, hindi sa chat window. At ang output column ay may pamagat na Output (incl. thinking), na mas mahalaga kaysa sa itsura nito. Higit pa riyan sa ilang sandali.
Ang Gemini 3.1 Pro Preview ay mas mataas sa $2.00 / $12.00 para sa mga prompt na hanggang 200k tokens at $4.00 / $18.00 sa itaas niyon. Tanging ito at ang Gemini 2.5 Pro ang may ganoong 200k split.
Aling mga presyo ang dodoble, at kailan#
Kung nagpo-prototype ka sa free tier, planuhin ang bayad na presyo mula sa unang araw, at tandaan ang mga petsang ito. Ang aming hiwalay na artikulo tungkol sa presyo ng Gemini 4 Argon ay sumasaklaw sa model na iyon nang detalyado.
Timeline
Mga pagbabago sa presyo ng Gemini na nasa pahina na ng Google
- 27 Okt 2026huling na-update ang pahina ng presyo; ang Gemini 2.5 Flash-Lite ang pinakamababang bayad na presyo para sa text
- 1 Dis 2026ang Gemini 4 Argon ay mula $2.00 / $10.00 papuntang $4.00 / $20.00 kada 1M tokens
- 1 Ene 2027ang Gemini 3.8 Flash at Gemini 3.6 Flash ay mula $0.75 / $3.75 papuntang $1.50 / $7.50 kada 1M tokens
Pansinin kung ano ang wala sa listahang iyon: ang tatlong Flash-Lite model. Ang kanilang mga presyo ay nananatiling tulad ng sa table. Ang Gemini 3.6 Flash ay may label na previous generation sa pahina, kaya kung pumipili ka ng bagong Flash model ngayon, ang pagtaas ay isa pang dahilan para tingnan ang mas murang mga row.
Walang ibinibigay na petsa ng shutdown ang pahina ng presyo para sa gemini-. Bago ka magtayo ng isang taong proyekto sa pinakamurang row, buksan ang pahina ng deprecations ng Google at maghanap ng isa.
Magkano ang 1,000 request#
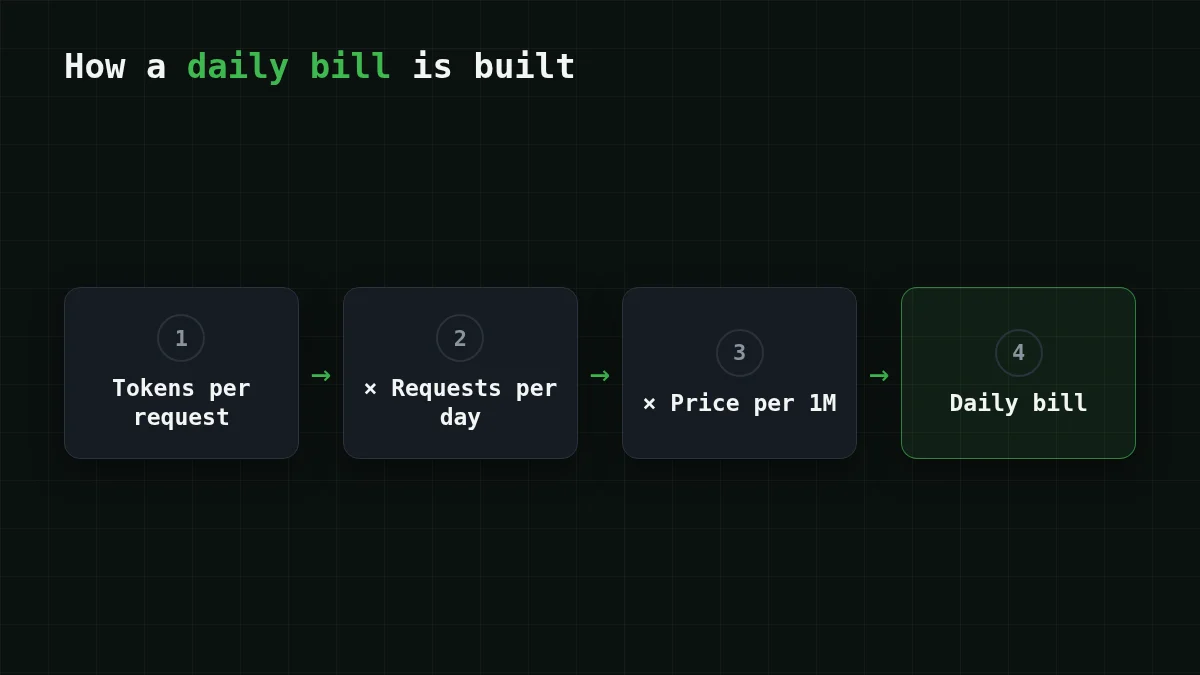
Mahirap maramdaman ang presyo kada 1M tokens. Mas madali ang isang gawain. Sabihin nating may support bot ka na nagbubuod ng mga ticket: bawat request ay nagpapadala ng mga 800 tokens papasok at nakakakuha ng mga 300 tokens palabas. Ang isang libong request ay 0.8M input tokens at 0.3M output tokens. Sa standard na presyo ng Gemini:
- Gemini 2.5 Flash-Lite: input 0.8 × $0.10 = $0.08, output 0.3 × $0.40 = $0.12, kaya $0.08 + $0.12 = $0.20 sa kabuuan.
- Gemini 3.1 Flash-Lite: input 0.8 × $0.25 = $0.20, output 0.3 × $1.50 = $0.45, kaya $0.20 + $0.45 = $0.65 sa kabuuan.
- Gemini 3.5 Flash-Lite: input 0.8 × $0.30 = $0.24, output 0.3 × $2.50 = $0.75, kaya $0.24 + $0.75 = $0.99 sa kabuuan.
- Gemini 4 Argon: input 0.8 × $2.00 = $1.60, output 0.3 × $10.00 = $3.00, kaya $1.60 + $3.00 = $4.60 ngayon, at 0.8 × $4.00 = $3.20 dagdag ang 0.3 × $20.00 = $6.00 ay $9.20 mula 1 Disyembre.
Nakikita mo ang pattern? Ang presyo ng output ang gumagawa ng pinsala. Kaunti lang ang pagkakaiba ng mga henerasyon ng Flash-Lite sa input ($0.10 hanggang $0.30) ngunit ang output ay umaakyat mula $0.40 hanggang $2.50, at ramdam ito ng isang workload na may maiikling sagot.
Ngayon ang parehong 1,000 request sa pamamagitan ng CheapTokens. Isang linya muna: ang MiniMax-M2.7 (MiniMaxAI/) ay nagpapatakbo ng workload na ito sa $0.085. Ang live na table sa ibaba ay may lahat ng tatlong model kasama ang reference na presyo ng OpenRouter sa tabi nila:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 input at 300 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Ang table ay muling kinakalkula mula sa kasalukuyang mga presyo tuwing naglo-load ang pahina, kaya nananatili itong tama kapag gumalaw ang mga taripa. Ang input at output ay binibilang nang magkasama, at sa kabuuang iyon ang lahat ng tatlong model ng CheapTokens ay mas mababa sa reference na presyo ng OpenRouter. Ang Gemini 2.5 Flash-Lite ay kumukuha ng $0.20 para sa parehong 1,000 request; ang table sa itaas ay nagpapakita ng mga total ng CheapTokens para sa eksaktong workload na ito, input at output nang magkasama — basahin ang dalawa nang magkatabi.
Ang bitag ng thinking-token#
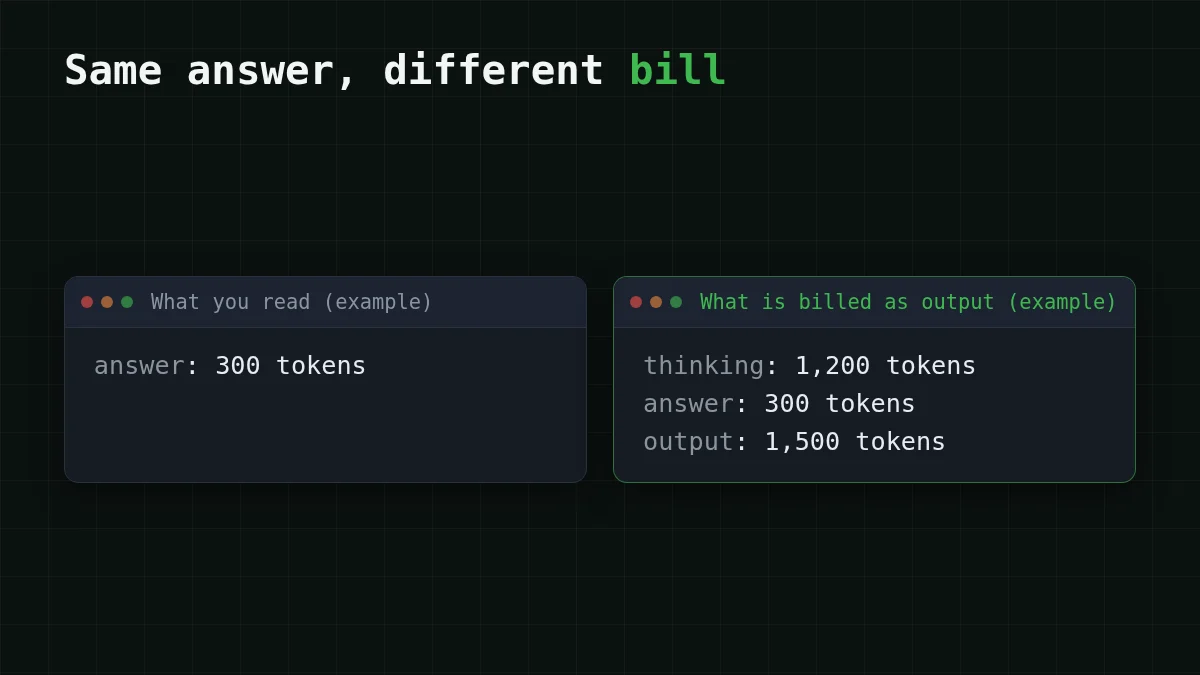
Bumalik tayo sa header na incl. thinking. Ang isang model na nag-iisip bago sumagot ay nagsusulat ng dagdag na tokens na hindi mo nakikita, at sinisingil ito ng Gemini bilang output. Sabihin nating ang bawat buod ng ticket ay nag-trigger ng 1,200 thinking tokens sa ibabaw ng 300-token na sagot. Ang output kada request ay 1,500 tokens na, kaya ang isang libong request ay nagbibigay ng 1.5 × $0.40 = $0.60 na output sa 2.5 Flash-Lite, mula sa $0.12. Pareho ang nakikitang sagot, limang beses ang output line.
Mabilisang pagsusuri
Ang sagot ng Gemini mo ay 300 tokens ang haba, ngunit ang bill ay nagpapakita ng 1,500 output tokens. Ano ang malamang na nangyari?
Ipakita ang sagot
Sagot: Ang model ay gumugol ng mga 1,200 tokens sa pag-iisip, at ang pag-iisip ay sinisingil bilang output
Kasama sa output column ng Google ang thinking tokens, kaya ang nakatagong pag-iisip ay lumalabas sa output side ng bill. Suriin ang mga numero ng usage sa ilang tunay na tugon bago ka mag-estimate ng isang buwan.
Alin ang pipiliin#
Ang tamang row ay depende sa ginagawa mo, hindi sa isang ranking.
Piliin ang iyong kaso
Aling setup ang bagay sa iyong kaso?
Pumili ng opsyon upang makita ang sagot
Prototype na may napakakaunting traffic
Gamitin ang free tier ng Gemini sa isa sa mga model na mayroon nito. Ituring ito bilang paraan para matuto, at ilagay ang bayad na presyo ng parehong model sa iyong budget bago ka mag-ship.
Maraming maiikling interactive na request
Ang Gemini 2.5 Flash-Lite ang pinakamurang bayad na row ng Gemini. Ihambing ang mga total sa cost table sa itaas sa $0.20 ng Gemini: ang DeepSeek-V4-Flash ay nagbibigay sa iyo ng fixed na presyo sa anumang oras ng araw, 380K context at hanggang 32,768 output tokens kada sagot, na may isang balanse sa lahat ng model.
Malalaking job na makapaghihintay
Hinahati ng Batch API ng Gemini ang presyo, kung kaya mong tiisin ang asynchronous na resulta. Kung mas gusto mong makakuha ng mga sagot sa parehong request, ang GLM-5.3-Flash (390K context, hanggang 8,192 output tokens) ang low-cost na maliit na model sa table.
Coding agents at mahabang loop
Ang MiniMax-M2.7 ang model ng CheapTokens para sa agentic at coding na gawain (180K context, hanggang 8,192 output tokens). Ang mga agent loop ay nagpapadala muli ng maraming input, kaya sukatin muna ang isang tunay na run; ang GLM vs DeepSeek vs MiniMax ay naglalakad sa kung paano pumili sa tatlo.
Ang presyo ay kalahati lang ng isang pagpili. Patakbuhin ang sarili mong mga prompt sa dalawa o tatlong kandidato at ihambing ang mga sagot bago ka magpalit ng anuman.
Subukan ang parehong request sa CheapTokens#
Ang API ay OpenAI- at Anthropic-compatible, kaya ang tawag ay mukhang anumang chat request. Kunin ang model id mula sa docs — iba ito sa bawat provider — at basahin ang usage sa reply: iyon ang nagbibigay sa iyo ng tunay na tokens kada request para sa table sa itaas.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Ang kasalukuyang mga presyo para sa bawat model ay nasa pahina ng presyo, at ang pahina ng model na DeepSeek-V4-Flash ay may mga detalye ng model.


