मॉडल और तुलनातुलना
2026 में सबसे सस्ता Gemini API मॉडल: Flash-Lite कीमतों की तुलना
किस Gemini मॉडल का सशुल्क मूल्य सबसे कम है, किनमें निःशुल्क स्तर है, 1 दिसंबर और 1 जनवरी को क्या दोगुना होता है, और CheapTokens मॉडलों के बगल में 1,000 अनुरोधों की लागत क्या है।
इस पृष्ठ पर
आप सबसे सस्ता Gemini मॉडल चाहते हैं, और Google की मूल्य सूची में पंक्तियाँ आपके धैर्य से अधिक हैं। यहाँ संक्षिप्त संस्करण है। Gemini API मूल्य निर्धारण पृष्ठ पर (27 अक्टूबर 2026 को अद्यतन, 29 अक्टूबर को जाँचा गया), Gemini 2.5 Flash-Lite (gemini-) का सबसे कम सशुल्क टेक्स्ट मूल्य है: $0.10 प्रति 1M इनपुट टोकन और $0.40 प्रति 1M आउटपुट टोकन। इसमें Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite और Gemini 2.5 Flash की तरह एक निःशुल्क स्तर भी है। और पृष्ठ पर पहले से ही दो मूल्य वृद्धियाँ हैं: Gemini 4 Argon 1 दिसंबर 2026 को दोगुना हो जाता है, Gemini 3.8 Flash और 3.6 Flash 1 जनवरी 2027 को दोगुने हो जाते हैं।
नीचे: कीमतें अगल-बगल, क्या बदलता है और कब, और CheapTokens के माध्यम से कॉल किए जा सकने वाले मॉडलों की तुलना में Gemini पर 1,000 सामान्य अनुरोधों की लागत। बिलिंग के सटीक तंत्र के लिए, इनपुट बनाम आउटपुट टोकन संक्षिप्त व्याख्या है।
आज Gemini की कीमतें, प्रति 1M टोकन#
ये Google के मूल्य निर्धारण पृष्ठ से 29 अक्टूबर 2026 तक के मानक सशुल्क-स्तरीय टेक्स्ट मूल्य हैं।
तालिका को दाईं ओर स्क्रॉल करें →
| मॉडल | इनपुट | आउटपुट | निःशुल्क स्तर |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | हाँ |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | हाँ |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | हाँ |
| Gemini 2.5 Flash | $0.30 | $2.50 | हाँ |
| Gemini 4 Argon | $2.00 | $10.00 | नहीं |
फ़ुटनोट में कुछ बातें छिपी हैं। Flash-Lite मॉडलों पर ऑडियो इनपुट अधिक महंगा है (2.5 Flash-Lite पर $0.30, 3.1 Flash-Lite पर $0.50), इसलिए वॉइस पाइपलाइन इस तालिका से मेल नहीं खाएगी। Batch API 50% छूट देता है, लेकिन यह अतुल्यकालिक है: आप एक जॉब सबमिट करते हैं और परिणाम बाद में एकत्र करते हैं, इसलिए यह रात भर के जॉब के लिए उपयुक्त है, चैट विंडो के लिए नहीं। और आउटपुट कॉलम का शीर्षक Output (incl. thinking) है, जो दिखने से अधिक मायने रखता है। इस पर एक मिनट में और बात।
Gemini 3.1 Pro Preview 200k टोकन तक के प्रॉम्प्ट के लिए $2.00 / $12.00 और उससे अधिक पर $4.00 / $18.00 पर उच्चतर है। केवल इसमें और Gemini 2.5 Pro में ही वह 200k विभाजन है।
कौन सी कीमतें दोगुनी होती हैं, और कब#
यदि आप निःशुल्क स्तर पर प्रोटोटाइप बनाते हैं, तो पहले दिन से सशुल्क मूल्य की योजना बनाएं, और इन तारीखों को ध्यान में रखें। Gemini 4 Argon मूल्य निर्धारण पर हमारा अलग लेख उस मॉडल को विस्तार से कवर करता है।
समयरेखा
Google के पृष्ठ पर पहले से मौजूद Gemini मूल्य परिवर्तन
- 27 अक्टूबर 2026मूल्य निर्धारण पृष्ठ अंतिम बार अद्यतन; Gemini 2.5 Flash-Lite सबसे कम सशुल्क टेक्स्ट मूल्य है
- 1 दिसंबर 2026Gemini 4 Argon $2.00 / $10.00 से $4.00 / $20.00 प्रति 1M टोकन हो जाता है
- 1 जनवरी 2027Gemini 3.8 Flash और Gemini 3.6 Flash $0.75 / $3.75 से $1.50 / $7.50 प्रति 1M टोकन हो जाते हैं
ध्यान दें कि उस सूची में क्या नहीं है: तीन Flash-Lite मॉडल। उनकी कीमतें तालिका के अनुसार ही रहती हैं। Gemini 3.6 Flash को पृष्ठ पर पिछली पीढ़ी के रूप में लेबल किया गया है, इसलिए यदि आप आज कोई नया Flash मॉडल चुन रहे हैं, तो यह वृद्धि सस्ती पंक्तियों को देखने का एक और कारण है।
मूल्य निर्धारण पृष्ठ gemini- के लिए कोई बंद होने की तारीख नहीं देता। सबसे सस्ती पंक्ति पर एक साल का उत्पाद बनाने से पहले, Google का deprecations पृष्ठ खोलें और उसे देखें।
1,000 अनुरोधों की लागत#
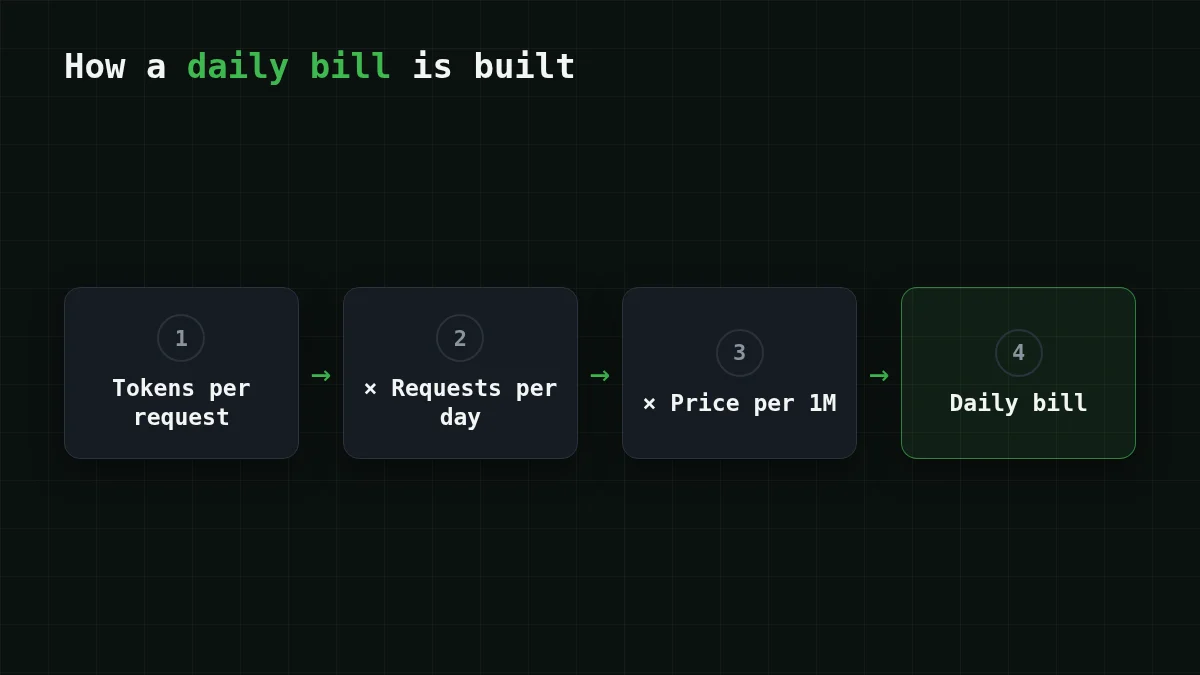
प्रति 1M टोकन कीमत को महसूस करना कठिन है। एक कार्य आसान है। मान लें कि आप एक सपोर्ट बॉट चलाते हैं जो टिकटों का सारांश बनाता है: प्रत्येक अनुरोध लगभग 800 टोकन इनपुट भेजता है और लगभग 300 टोकन आउटपुट प्राप्त करता है। तो एक हजार अनुरोध 0.8M इनपुट टोकन और 0.3M आउटपुट टोकन हैं। Gemini की मानक कीमतों पर:
- Gemini 2.5 Flash-Lite: इनपुट 0.8 × $0.10 = $0.08, आउटपुट 0.3 × $0.40 = $0.12, तो कुल $0.08 + $0.12 = $0.20।
- Gemini 3.1 Flash-Lite: इनपुट 0.8 × $0.25 = $0.20, आउटपुट 0.3 × $1.50 = $0.45, तो कुल $0.20 + $0.45 = $0.65।
- Gemini 3.5 Flash-Lite: इनपुट 0.8 × $0.30 = $0.24, आउटपुट 0.3 × $2.50 = $0.75, तो कुल $0.24 + $0.75 = $0.99।
- Gemini 4 Argon: इनपुट 0.8 × $2.00 = $1.60, आउटपुट 0.3 × $10.00 = $3.00, तो अभी $1.60 + $3.00 = $4.60, और 1 दिसंबर से 0.8 × $4.00 = $3.20 प्लस 0.3 × $20.00 = $6.00 मिलाकर $9.20।
पैटर्न देखें? आउटपुट मूल्य नुकसान करता है। Flash-Lite पीढ़ियाँ इनपुट पर थोड़ा भिन्न होती हैं ($0.10 से $0.30) लेकिन आउटपुट $0.40 से $2.50 तक बढ़ता है, और एक छोटे-उत्तर वाला कार्यभार इसे महसूस करता है।
अब वही 1,000 अनुरोध CheapTokens के माध्यम से। पहले एक पंक्ति: MiniMax-M2.7 (MiniMaxAI/) इस कार्यभार को $0.085 में चलाता है। नीचे दी गई लाइव तालिका में तीनों मॉडल हैं और उनके बगल में OpenRouter का संदर्भ मूल्य है:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
प्रति अनुरोध 800 इनपुट और 300 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
तालिका हर बार पृष्ठ लोड होने पर वर्तमान कीमतों से पुनर्गणना करती है, इसलिए जब टैरिफ बदलते हैं तो यह सही रहती है। इनपुट और आउटपुट को एक साथ गिना जाता है, और उस कुल में सभी तीन CheapTokens मॉडल OpenRouter के संदर्भ मूल्य से कम आते हैं। Gemini 2.5 Flash-Lite उन्हीं 1,000 अनुरोधों के लिए $0.20 लेता है; ऊपर की तालिका ठीक इसी कार्यभार के लिए CheapTokens कुल दिखाती है, इनपुट और आउटपुट एक साथ — दोनों को अगल-बगल पढ़ें।
थिंकिंग-टोकन जाल#
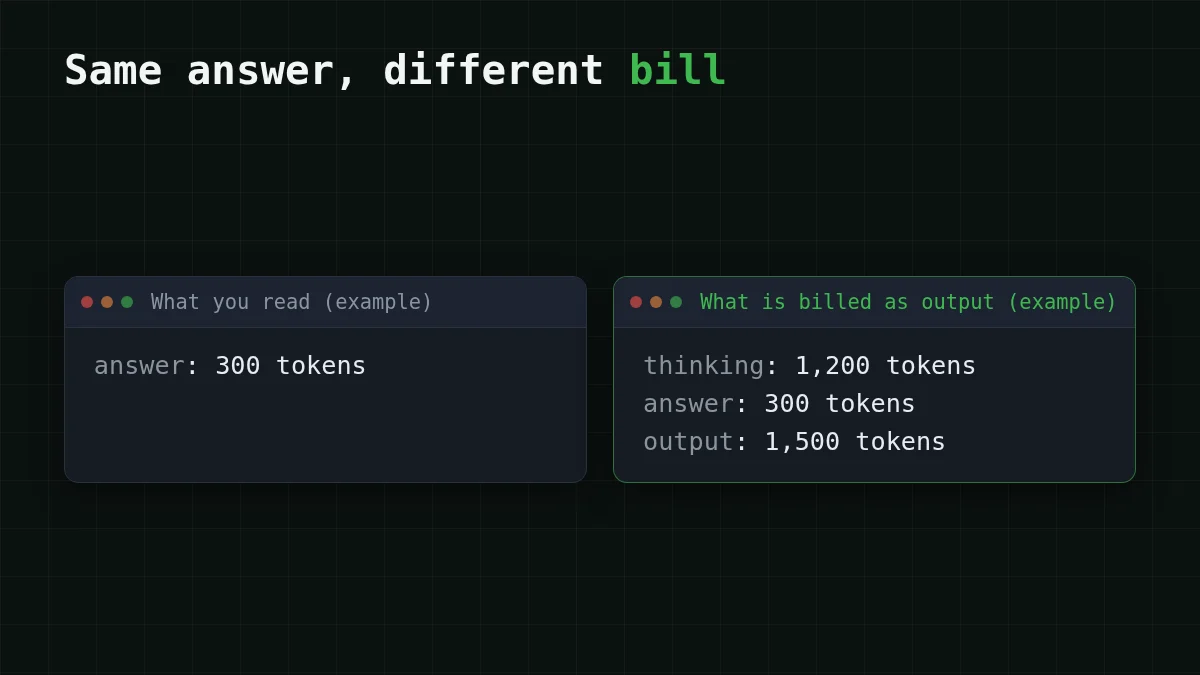
उस incl. thinking हेडर पर वापस। जो मॉडल उत्तर देने से पहले सोचता है, वह अतिरिक्त टोकन लिखता है जो आप कभी नहीं देखते, और Gemini उन्हें आउटपुट के रूप में बिल करता है। मान लें कि प्रत्येक टिकट सारांश 300-टोकन उत्तर के अतिरिक्त 1,200 थिंकिंग टोकन ट्रिगर करता है। अब प्रति अनुरोध आउटपुट 1,500 टोकन है, इसलिए एक हजार अनुरोध 2.5 Flash-Lite पर 1.5 × $0.40 = $0.60 आउटपुट देते हैं, जो $0.12 से बढ़कर है। वही दृश्यमान उत्तर, आउटपुट लाइन पाँच गुना।
त्वरित जाँच
आपका Gemini उत्तर 300 टोकन लंबा है, लेकिन बिल 1,500 आउटपुट टोकन दिखाता है। सबसे संभावित क्या हुआ?
उत्तर दिखाएँ
उत्तर: मॉडल ने लगभग 1,200 टोकन सोचने में खर्च किए, और थिंकिंग को आउटपुट के रूप में बिल किया जाता है
Google के आउटपुट कॉलम में थिंकिंग टोकन शामिल हैं, इसलिए छिपी हुई तर्क बिल के आउटपुट पक्ष पर दिखाई देती है। महीने का अनुमान लगाने से पहले कुछ वास्तविक प्रतिक्रियाओं पर उपयोग संख्याएँ जाँचें।
किसे चुनें#
सही पंक्ति इस पर निर्भर करती है कि आप क्या कर रहे हैं, किसी एक रैंकिंग पर नहीं।
अपना मामला चुनें
कौन सा सेटअप आपके मामले में फिट बैठता है?
उत्तर देखने के लिए एक विकल्प चुनें
बहुत कम ट्रैफ़िक के साथ प्रोटोटाइप
उन मॉडलों में से एक पर Gemini का निःशुल्क स्तर उपयोग करें जिनमें यह है। इसे सीखने के तरीके के रूप में मानें, और शिप करने से पहले उसी मॉडल का सशुल्क मूल्य अपने बजट में डालें।
कई छोटे इंटरैक्टिव अनुरोध
Gemini 2.5 Flash-Lite सबसे सस्ती सशुल्क Gemini पंक्ति है। ऊपर दी गई लागत तालिका में कुल की तुलना Gemini के $0.20 से करें: DeepSeek-V4-Flash आपको दिन के किसी भी समय एक निश्चित मूल्य, 380K संदर्भ और प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन देता है, सभी मॉडलों में एक ही बैलेंस के साथ।
बड़े जॉब जो प्रतीक्षा कर सकते हैं
Gemini का Batch API कीमत आधी कर देता है, यदि आप अतुल्यकालिक परिणामों के साथ रह सकते हैं। यदि आप उसी अनुरोध में उत्तर प्राप्त करना पसंद करते हैं, तो GLM-5.3-Flash (390K संदर्भ, अधिकतम 8,192 आउटपुट टोकन) तालिका में कम लागत वाला छोटा मॉडल है।
कोडिंग एजेंट और लंबे लूप
MiniMax-M2.7 एजेंटिक और कोडिंग कार्य के लिए CheapTokens मॉडल है (180K संदर्भ, अधिकतम 8,192 आउटपुट टोकन)। एजेंट लूप बहुत सारा इनपुट फिर से भेजते हैं, इसलिए पहले एक वास्तविक रन मापें; GLM बनाम DeepSeek बनाम MiniMax तीनों के बीच चयन करने का तरीका बताता है।
कीमत चयन का केवल आधा हिस्सा है। दो या तीन उम्मीदवारों पर अपने स्वयं के प्रॉम्प्ट चलाएं और कुछ भी स्विच करने से पहले उत्तरों की तुलना करें।
CheapTokens पर वही अनुरोध आज़माएं#
API OpenAI- और Anthropic-संगत है, इसलिए कॉल किसी भी चैट अनुरोध जैसा दिखता है। मॉडल आईडी docs से प्राप्त करें — यह प्रदाताओं के बीच भिन्न होता है — और उत्तर में usage पढ़ें: यह आपको ऊपर की तालिका के लिए प्रति अनुरोध वास्तविक टोकन देता है।
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
हर मॉडल के वर्तमान मूल्य मूल्य निर्धारण पृष्ठ पर हैं, और DeepSeek-V4-Flash मॉडल पृष्ठ पर मॉडल विवरण हैं।


