Modelli e confrontiConfronto
Il modello API Gemini più economico nel 2026: prezzi Flash-Lite a confronto
Quale modello Gemini ha il prezzo a pagamento più basso, quali hanno un piano gratuito, cosa raddoppia il 1° dicembre e il 1° gennaio, e quanto costano 1.000 richieste rispetto ai modelli CheapTokens.
In questa pagina
Vuoi il modello Gemini più economico e il listino prezzi di Google ha più righe di quante tu abbia pazienza. Ecco la versione breve. Nella pagina dei prezzi dell'API Gemini (aggiornata il 27 ottobre 2026, verificata il 29 ottobre), Gemini 2.5 Flash-Lite (gemini-) ha il prezzo più basso per il testo a pagamento: $0,10 per 1M token di input e $0,40 per 1M token di output. Ha anche un piano gratuito, come Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite e Gemini 2.5 Flash. E due aumenti di prezzo sono già sulla pagina: Gemini 4 Argon raddoppia il 1° dicembre 2026, Gemini 3.8 Flash e 3.6 Flash raddoppiano il 1° gennaio 2027.
Qui sotto: i prezzi affiancati, cosa cambia e quando, e quanto costano 1.000 richieste ordinarie su Gemini rispetto ai modelli che puoi chiamare tramite CheapTokens. Per i meccanismi esatti della fatturazione, input vs output tokens è la spiegazione breve.
I prezzi Gemini oggi, per 1M token#
Questi sono i prezzi standard del livello a pagamento per il testo dalla pagina dei prezzi di Google, al 29 ottobre 2026.
Scorri la tabella verso destra →
| Modello | Input | Output | Piano gratuito |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0,10 | $0,40 | sì |
| Gemini 3.1 Flash-Lite | $0,25 | $1,50 | sì |
| Gemini 3.5 Flash-Lite | $0,30 | $2,50 | sì |
| Gemini 2.5 Flash | $0,30 | $2,50 | sì |
| Gemini 4 Argon | $2,00 | $10,00 | no |
Alcune cose si nascondono nelle note a piè di pagina. L'input audio costa di più sui modelli Flash-Lite ($0,30 su 2.5 Flash-Lite, $0,50 su 3.1 Flash-Lite), quindi una pipeline vocale non corrisponderà a questa tabella. La Batch API applica uno sconto del 50%, ma è asincrona: invii un job e raccogli i risultati più tardi, quindi si adatta a lavori notturni, non a una finestra di chat. E la colonna output è intitolata Output (incl. thinking), il che conta più di quanto sembri. Ne parliamo tra un minuto.
Gemini 3.1 Pro Preview si colloca più in alto a $2,00 / $12,00 per prompt fino a 200k token e $4,00 / $18,00 oltre quella soglia. Solo lui e Gemini 2.5 Pro hanno quella suddivisione a 200k.
Quali prezzi raddoppiano, e quando#
Se fai prototipi su un piano gratuito, pianifica il prezzo a pagamento fin dal primo giorno e tieni a mente queste date. Il nostro articolo separato su Gemini 4 Argon pricing copre quel modello in dettaglio.
Cronologia
Modifiche ai prezzi Gemini già presenti sulla pagina di Google
- 27 ott 2026pagina dei prezzi aggiornata l'ultima volta; Gemini 2.5 Flash-Lite è il prezzo più basso per il testo a pagamento
- 1 dic 2026Gemini 4 Argon passa da $2,00 / $10,00 a $4,00 / $20,00 per 1M token
- 1 gen 2027Gemini 3.8 Flash e Gemini 3.6 Flash passano da $0,75 / $3,75 a $1,50 / $7,50 per 1M token
Nota cosa non è in quella lista: i tre modelli Flash-Lite. I loro prezzi restano come nella tabella. Gemini 3.6 Flash è etichettato come generazione precedente sulla pagina, quindi se oggi scegli un nuovo modello Flash, l'aumento è un motivo in più per guardare alle righe più economiche.
La pagina dei prezzi non indica una data di dismissione per gemini-. Prima di costruire un prodotto di un anno sulla riga più economica, apri la pagina delle deprecazioni di Google e cercane una.
Quanto costano 1.000 richieste#
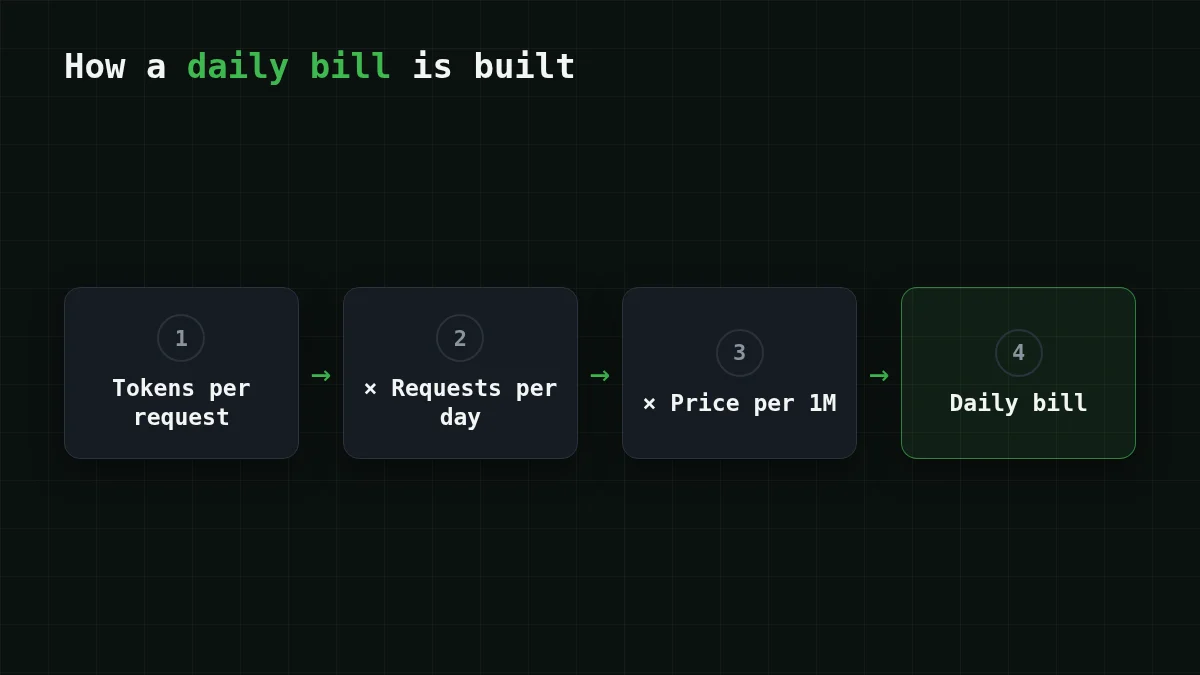
Il prezzo per 1M token è difficile da percepire. Un compito è più facile. Supponiamo che tu gestisca un bot di supporto che riassume i ticket: ogni richiesta invia circa 800 token in input e riceve circa 300 token in output. Mille richieste sono quindi 0,8M token di input e 0,3M token di output. Ai prezzi standard di Gemini:
- Gemini 2.5 Flash-Lite: input 0,8 × $0,10 = $0,08, output 0,3 × $0,40 = $0,12, quindi $0,08 + $0,12 = $0,20 in totale.
- Gemini 3.1 Flash-Lite: input 0,8 × $0,25 = $0,20, output 0,3 × $1,50 = $0,45, quindi $0,20 + $0,45 = $0,65 in totale.
- Gemini 3.5 Flash-Lite: input 0,8 × $0,30 = $0,24, output 0,3 × $2,50 = $0,75, quindi $0,24 + $0,75 = $0,99 in totale.
- Gemini 4 Argon: input 0,8 × $2,00 = $1,60, output 0,3 × $10,00 = $3,00, quindi $1,60 + $3,00 = $4,60 ora, e 0,8 × $4,00 = $3,20 più 0,3 × $20,00 = $6,00 fanno $9,20 dal 1° dicembre.
Vedi lo schema? È il prezzo dell'output a fare danni. Le generazioni Flash-Lite differiscono poco sull'input ($0,10 a $0,30) ma l'output sale da $0,40 a $2,50, e un carico di lavoro con risposte brevi lo sente.
Ora le stesse 1.000 richieste tramite CheapTokens. Prima una riga: MiniMax-M2.7 (MiniMaxAI/) esegue questo carico di lavoro per $0.085. La tabella live qui sotto ha tutti e tre i modelli con il prezzo di riferimento di OpenRouter accanto:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 token di input e 300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
La tabella si ricalcola dai prezzi correnti ogni volta che la pagina viene caricata, quindi resta corretta quando le tariffe cambiano. Input e output sono conteggiati insieme, e in quel totale tutti e tre i modelli CheapTokens sono sotto il prezzo di riferimento di OpenRouter. Gemini 2.5 Flash-Lite prende $0,20 per le stesse 1.000 richieste; la tabella sopra mostra i totali CheapTokens per esattamente questo carico di lavoro, input e output insieme — leggi i due affiancati.
La trappola dei token di thinking#
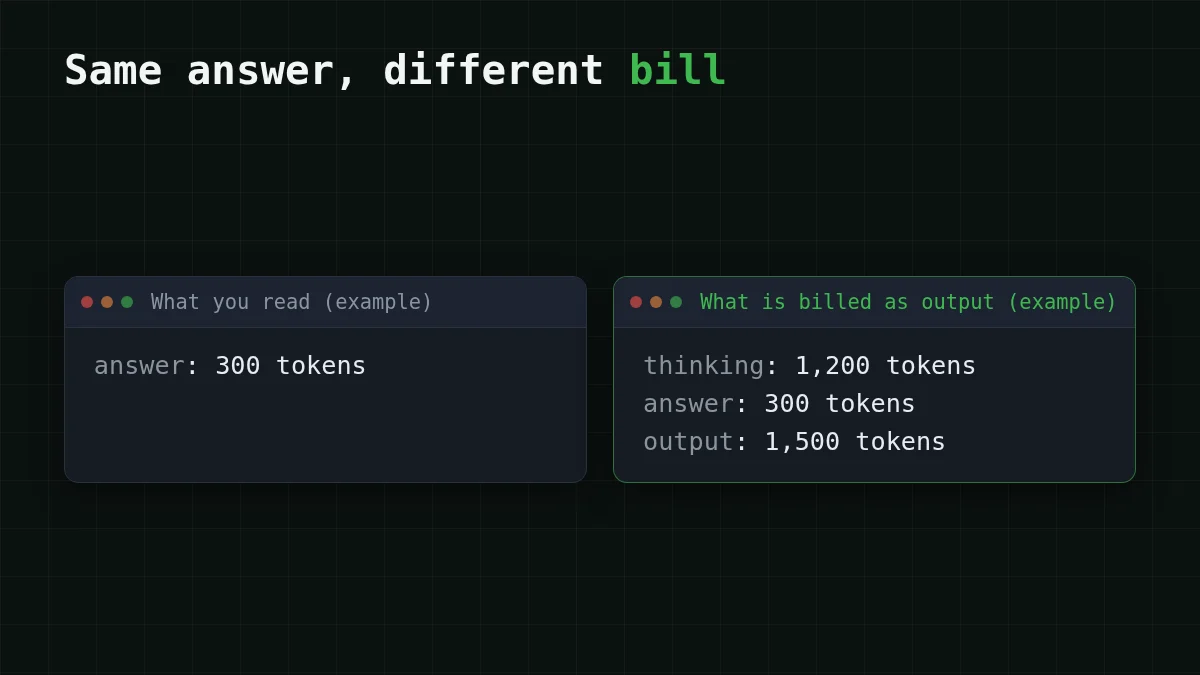
Torniamo a quell'intestazione incl. thinking. Un modello che pensa prima di rispondere scrive token extra che non vedi mai, e Gemini li fattura come output. Supponiamo che ogni riassunto di ticket attivi 1.200 token di thinking oltre alla risposta di 300 token. L'output per richiesta è ora di 1.500 token, quindi mille richieste danno 1,5 × $0,40 = $0,60 di output su 2.5 Flash-Lite, rispetto a $0,12. Stessa risposta visibile, cinque volte la riga output.
Verifica rapida
La tua risposta Gemini è lunga 300 token, ma la fattura mostra 1.500 token di output. Cosa è successo molto probabilmente?
Mostra risposta
Risposta: Il modello ha speso circa 1.200 token pensando, e il thinking è fatturato come output
La colonna output di Google include i token di thinking, quindi il ragionamento nascosto compare sul lato output della fattura. Controlla i numeri di utilizzo su alcune risposte reali prima di stimare un mese.
Quale scegliere#
La riga giusta dipende da cosa stai facendo, non da una singola classifica.
Scegli il tuo caso
Quale configurazione si adatta al tuo caso?
Scegli un'opzione per vedere la risposta
Prototipo con pochissimo traffico
Usa il piano gratuito di Gemini su uno dei modelli che lo hanno. Trattalo come un modo per imparare, e metti nel budget il prezzo a pagamento dello stesso modello prima di andare in produzione.
Molte richieste interattive brevi
Gemini 2.5 Flash-Lite è la riga Gemini a pagamento più economica. Confronta i totali nella tabella dei costi sopra con i $0,20 di Gemini: DeepSeek-V4-Flash ti dà un prezzo fisso a qualsiasi ora del giorno, una finestra di contesto di 380K e fino a 32.768 token di output per risposta, con un unico saldo per tutti i modelli.
Lavori grandi che possono aspettare
La Batch API di Gemini dimezza il prezzo, se puoi convivere con risultati asincroni. Se preferisci ottenere risposte nella stessa richiesta, GLM-5.3-Flash (contesto 390K, fino a 8.192 token di output) è il modello piccolo a basso costo nella tabella.
Agenti di coding e loop lunghi
MiniMax-M2.7 è il modello CheapTokens per lavoro agentico e di coding (contesto 180K, fino a 8.192 token di output). I loop degli agenti reinviano molto input, quindi misura prima un'esecuzione reale; GLM vs DeepSeek vs MiniMax spiega come scegliere tra i tre.
Il prezzo è solo metà della scelta. Esegui i tuoi prompt sui due o tre candidati e confronta le risposte prima di cambiare qualsiasi cosa.
Prova la stessa richiesta su CheapTokens#
L'API è compatibile con OpenAI e Anthropic, quindi la chiamata assomiglia a qualsiasi richiesta di chat. Ottieni l'id del modello dalla documentazione — cambia tra i provider — e leggi usage nella risposta: questo ti dà i token reali per richiesta per la tabella sopra.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
I prezzi correnti per ogni modello sono sulla pagina dei prezzi, e la pagina del modello DeepSeek-V4-Flash ha i dettagli del modello.


