Modele i porównaniaPorównanie
Najtańszy model Gemini API w 2026: porównanie cen Flash-Lite
Który model Gemini ma najniższą płatną cenę, które mają darmowy plan, co się podwaja 1 grudnia i 1 stycznia oraz ile kosztuje 1 000 zapytań obok modeli CheapTokens.
Na tej stronie
Chcesz najtańszy model Gemini, a cennik Google ma więcej wierszy, niż masz cierpliwości. Oto krótka wersja. Na stronie cennika Gemini API (aktualizacja 27 października 2026, sprawdzona 29 października) Gemini 2.5 Flash-Lite (gemini-) ma najniższą płatną cenę tekstu: $0.10 za 1M tokenów wejściowych i $0.40 za 1M tokenów wyjściowych. Ma też darmowy plan, podobnie jak Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite i Gemini 2.5 Flash. A na stronie są już dwie podwyżki: Gemini 4 Argon podwaja się 1 grudnia 2026, Gemini 3.8 Flash i 3.6 Flash podwajają się 1 stycznia 2027.
Poniżej: ceny obok siebie, co się zmienia i kiedy, oraz ile kosztuje 1 000 zwykłych zapytań w Gemini w porównaniu z modelami, które możesz wywołać przez CheapTokens. Dokładne zasady rozliczania opisuje krótko input vs output tokens.
Ceny Gemini dziś, za 1M tokenów#
To standardowe ceny tekstu w płatnym planie ze strony cennika Google, na dzień 29 października 2026.
Przewiń tabelę w prawo →
| Model | Wejście | Wyjście | Darmowy plan |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | tak |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | tak |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | tak |
| Gemini 2.5 Flash | $0.30 | $2.50 | tak |
| Gemini 4 Argon | $2.00 | $10.00 | nie |
W przypisach kryje się kilka rzeczy. Wejście audio kosztuje więcej w modelach Flash-Lite ($0.30 w 2.5 Flash-Lite, $0.50 w 3.1 Flash-Lite), więc pipeline głosowy nie będzie zgodny z tą tabelą. Batch API daje 50% zniżki, ale jest asynchroniczne: wysyłasz zadanie i odbierasz wyniki później, więc nadaje się do zadań nocnych, a nie do okna czatu. A kolumna wyjścia ma nagłówek Output (incl. thinking), co ma większe znaczenie, niż wygląda. Więcej o tym za chwilę.
Gemini 3.1 Pro Preview jest wyżej: $2.00 / $12.00 dla promptów do 200k tokenów i $4.00 / $18.00 powyżej. Tylko on i Gemini 2.5 Pro mają ten podział na 200k.
Które ceny się podwajają i kiedy#
Jeśli prototypujesz na darmowym planie, planuj płatną cenę od pierwszego dnia i miej te daty na uwadze. Nasz osobny tekst o cenniku Gemini 4 Argon omawia ten model szczegółowo.
Os czasu
Zmiany cen Gemini już na stronie Google
- 27 paź 2026strona cennika ostatnio aktualizowana; Gemini 2.5 Flash-Lite ma najniższą płatną cenę tekstu
- 1 gru 2026Gemini 4 Argon przechodzi z $2.00 / $10.00 na $4.00 / $20.00 za 1M tokenów
- 1 sty 2027Gemini 3.8 Flash i Gemini 3.6 Flash przechodzą z $0.75 / $3.75 na $1.50 / $7.50 za 1M tokenów
Zauważ, czego nie ma na tej liście: trzech modeli Flash-Lite. Ich ceny pozostają jak w tabeli. Gemini 3.6 Flash jest na stronie oznaczony jako poprzednia generacja, więc jeśli dziś wybierasz nowy model Flash, podwyżka to kolejny powód, by spojrzeć na tańsze wiersze.
Strona cennika nie podaje daty wyłączenia gemini-. Zanim zbudujesz roczny produkt na najtańszym wierszu, otwórz stronę deprecacji Google i sprawdź, czy taka data istnieje.
Ile kosztuje 1 000 zapytań#
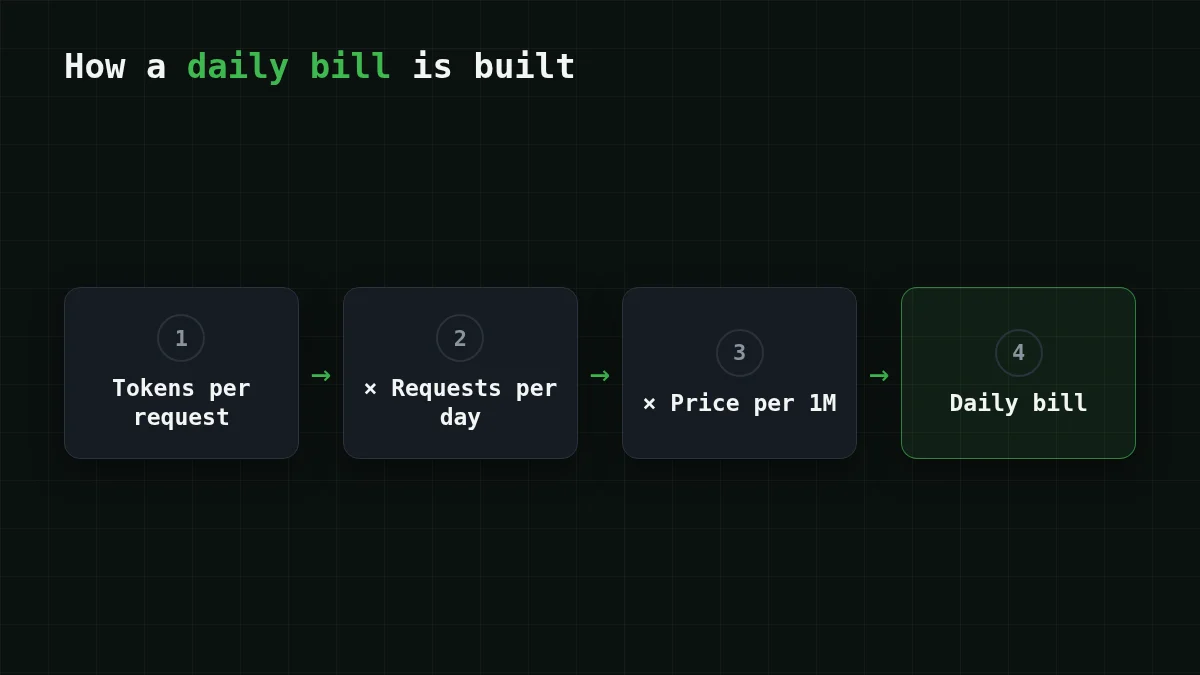
Cenę za 1M tokenów trudno wyczuć. Zadanie jest łatwiejsze. Załóżmy, że prowadzisz bota wsparcia, który streszcza zgłoszenia: każde zapytanie wysyła około 800 tokenów wejścia i dostaje około 300 tokenów wyjścia. Tysiąc zapytań to wtedy 0.8M tokenów wejściowych i 0.3M tokenów wyjściowych. Przy standardowych cenach Gemini:
- Gemini 2.5 Flash-Lite: wejście 0.8 × $0.10 = $0.08, wyjście 0.3 × $0.40 = $0.12, czyli razem $0.08 + $0.12 = $0.20.
- Gemini 3.1 Flash-Lite: wejście 0.8 × $0.25 = $0.20, wyjście 0.3 × $1.50 = $0.45, czyli razem $0.20 + $0.45 = $0.65.
- Gemini 3.5 Flash-Lite: wejście 0.8 × $0.30 = $0.24, wyjście 0.3 × $2.50 = $0.75, czyli razem $0.24 + $0.75 = $0.99.
- Gemini 4 Argon: wejście 0.8 × $2.00 = $1.60, wyjście 0.3 × $10.00 = $3.00, czyli teraz $1.60 + $3.00 = $4.60, a od 1 grudnia 0.8 × $4.00 = $3.20 plus 0.3 × $20.00 = $6.00 daje $9.20.
Widzisz schemat? Szkodzi cena wyjścia. Generacje Flash-Lite niewiele się różnią na wejściu ($0.10 do $0.30), ale wyjście rośnie z $0.40 do $2.50, a obciążenie z krótkimi odpowiedziami to odczuwa.
Teraz te same 1 000 zapytań przez CheapTokens. Najpierw jedna linijka: MiniMax-M2.7 (MiniMaxAI/) obsługuje to obciążenie za $0.085. Poniższa tabela na żywo zawiera wszystkie trzy modele z ceną referencyjną OpenRouter obok:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 tokenów wejściowych i 300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Tabela przelicza się z bieżących cen przy każdym załadowaniu strony, więc pozostaje poprawna, gdy taryfy się zmieniają. Wejście i wyjście są liczone razem, a w tej sumie wszystkie trzy modele CheapTokens mieszczą się poniżej ceny referencyjnej OpenRouter. Gemini 2.5 Flash-Lite bierze $0.20 za te same 1 000 zapytań; powyższa tabela pokazuje sumy CheapTokens dokładnie dla tego obciążenia, wejście i wyjście razem — czytaj je obok siebie.
Pułapka tokenów myślenia#
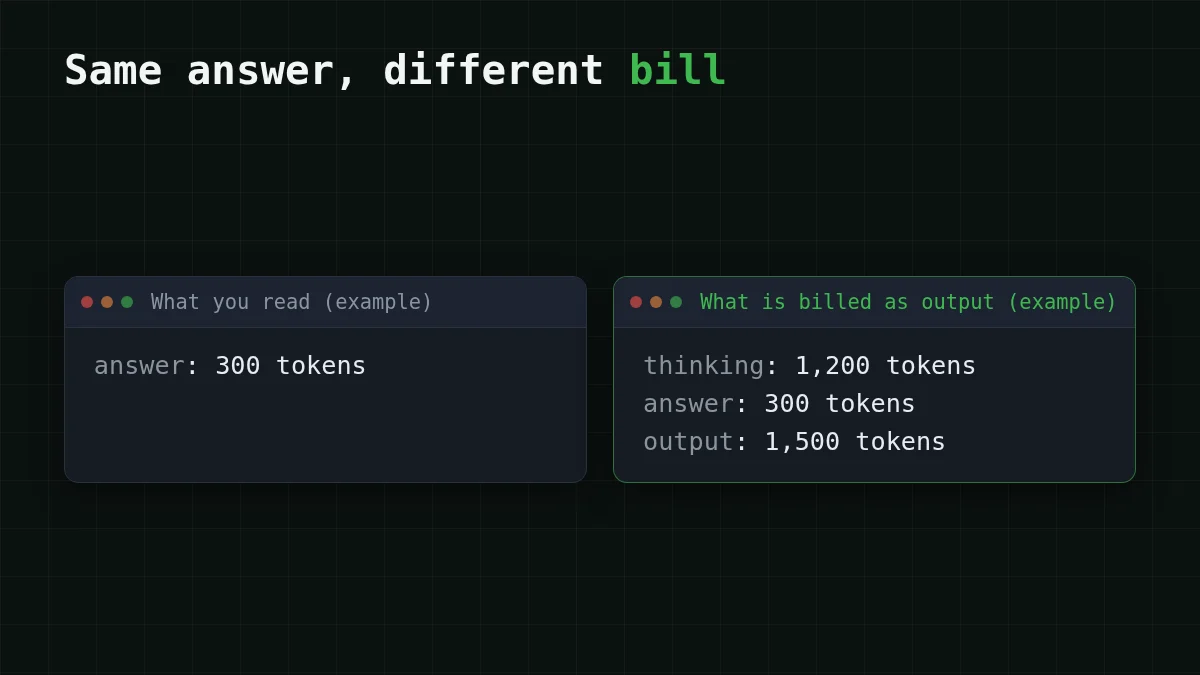
Wróćmy do nagłówka incl. thinking. Model, który myśli przed odpowiedzią, zapisuje dodatkowe tokeny, których nie widzisz, a Gemini rozlicza je jako wyjście. Załóżmy, że każde streszczenie zgłoszenia wywołuje 1 200 tokenów myślenia oprócz 300-tokenowej odpowiedzi. Wyjście na zapytanie to teraz 1 500 tokenów, więc tysiąc zapytań daje 1.5 × $0.40 = $0.60 wyjścia w 2.5 Flash-Lite, zamiast $0.12. Ta sama widoczna odpowiedź, pięć razy większa pozycja wyjścia.
Szybkie sprawdzenie
Twoja odpowiedź Gemini ma 300 tokenów, ale rachunek pokazuje 1 500 tokenów wyjścia. Co najprawdopodobniej się stało?
Pokaż odpowiedź
Odpowiedź: Model zużył około 1 200 tokenów na myślenie, a myślenie jest rozliczane jako wyjście
Kolumna wyjścia Google obejmuje tokeny myślenia, więc ukryte rozumowanie pojawia się po stronie wyjścia na rachunku. Sprawdź liczby zużycia na kilku prawdziwych odpowiedziach, zanim oszacujesz miesiąc.
Który wybrać#
Właściwy wiersz zależy od tego, co robisz, a nie od jednego rankingu.
Wybierz swój przypadek
Która konfiguracja pasuje do twojego przypadku?
Wybierz opcję, aby zobaczyć odpowiedź
Prototyp przy bardzo małym ruchu
Użyj darmowego planu Gemini w jednym z modeli, który go ma. Traktuj go jako sposób nauki i wpisz płatną cenę tego samego modelu do budżetu, zanim wypuścisz produkt.
Wiele krótkich interaktywnych zapytań
Gemini 2.5 Flash-Lite to najtańszy płatny wiersz Gemini. Porównaj sumy z tabeli kosztów powyżej z $0.20 w Gemini: DeepSeek-V4-Flash daje stałą cenę o każdej porze dnia, kontekst 380K i do 32 768 tokenów wyjścia na odpowiedź, z jednym saldem dla wszystkich modeli.
Duże zadania, które mogą poczekać
Batch API Gemini obniża cenę o połowę, jeśli możesz żyć z asynchronicznymi wynikami. Jeśli wolisz odpowiedzi w tym samym zapytaniu, GLM-5.3-Flash (kontekst 390K, do 8 192 tokenów wyjścia) to tani mały model w tabeli.
Agenci kodujący i długie pętle
MiniMax-M2.7 to model CheapTokens do pracy agentowej i kodowania (kontekst 180K, do 8 192 tokenów wyjścia). Pętle agentów wysyłają dużo wejścia, więc najpierw zmierz prawdziwe uruchomienie; GLM vs DeepSeek vs MiniMax opisuje, jak wybierać między tymi trzema.
Cena to tylko połowa wyboru. Uruchom własne prompty na dwóch lub trzech kandydatach i porównaj odpowiedzi, zanim cokolwiek przełączysz.
Wypróbuj to samo zapytanie w CheapTokens#
API jest zgodne z OpenAI i Anthropic, więc wywołanie wygląda jak każde zapytanie czatu. Pobierz id modelu z dokumentacji — różni się między dostawcami — i odczytaj usage w odpowiedzi: to daje rzeczywiste tokeny na zapytanie do powyższej tabeli.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Bieżące ceny każdego modelu są na stronie cennika, a strona modelu DeepSeek-V4-Flash zawiera szczegóły modelu.


