모델 & 비교비교
2026년 가장 저렴한 Gemini API 모델: Flash-Lite 가격 비교
어떤 Gemini 모델이 가장 낮은 유료 가격인지, 어떤 모델에 무료 티어가 있는지, 12월 1일과 1월 1일에 무엇이 두 배가 되는지, 그리고 요청 1,000건이 CheapTokens 모델과 비교해 얼마인지.
이 페이지의 내용
가장 저렴한 Gemini 모델을 원하지만 Google의 가격표는 인내심보다 행이 많습니다. 짧은 버전을 알려드립니다. Gemini API 가격 페이지(2026년 10월 27일 업데이트, 10월 29일 확인)에서 Gemini 2.5 Flash-Lite(gemini-)가 유료 텍스트 가격이 가장 낮습니다: 입력 1M 토큰당 $0.10, 출력 1M 토큰당 $0.40입니다. Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite, Gemini 2.5 Flash처럼 무료 티어도 있습니다. 그리고 이미 페이지에 두 건의 가격 인상이 올라 있습니다: Gemini 4 Argon은 2026년 12월 1일에 두 배, Gemini 3.8 Flash와 3.6 Flash는 2027년 1월 1일에 두 배가 됩니다.
아래에는 가격을 나란히 비교하고, 무엇이 언제 바뀌는지, 그리고 평범한 요청 1,000건이 Gemini와 CheapTokens를 통해 호출할 수 있는 모델에서 각각 얼마인지 정리했습니다. 청구의 정확한 원리는 입력 vs 출력 토큰에서 짧게 설명합니다.
오늘의 Gemini 가격, 1M 토큰당#
2026년 10월 29일 기준 Google의 가격 페이지에 있는 표준 유료 티어 텍스트 가격입니다.
표를 오른쪽으로 스크롤하세요 →
| 모델 | 입력 | 출력 | 무료 티어 |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | 예 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | 예 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 예 |
| Gemini 2.5 Flash | $0.30 | $2.50 | 예 |
| Gemini 4 Argon | $2.00 | $10.00 | 아니요 |
각주에 몇 가지가 숨어 있습니다. Flash-Lite 모델은 오디오 입력이 더 비쌉니다(2.5 Flash-Lite는 $0.30, 3.1 Flash-Lite는 $0.50). 따라서 음성 파이프라인은 이 표와 맞지 않습니다. Batch API는 50% 할인되지만 비동기 방식입니다: 작업을 제출하고 나중에 결과를 수집하므로 야간 작업에는 적합하지만 채팅 창에는 맞지 않습니다. 그리고 출력 열의 제목은 *Output (incl. thinking)*인데, 이는 보이는 것보다 중요합니다. 잠시 후 더 다루겠습니다.
Gemini 3.1 Pro Preview는 200k 토큰 이하 프롬프트에서 $2.00 / $12.00, 그 이상에서는 $4.00 / $18.00로 더 높습니다. 200k 구간이 나뉘는 모델은 이것과 Gemini 2.5 Pro뿐입니다.
어떤 가격이 언제 두 배가 되나#
무료 티어에서 프로토타이핑한다면 첫날부터 유료 가격을 계획하고 다음 날짜를 기억하세요. Gemini 4 Argon 가격에 대한 별도 글에서 해당 모델을 자세히 다룹니다.
타임라인
Google 페이지에 이미 올라온 Gemini 가격 변경
- 2026년 10월 27일가격 페이지 마지막 업데이트; Gemini 2.5 Flash-Lite가 가장 낮은 유료 텍스트 가격
- 2026년 12월 1일Gemini 4 Argon이 1M 토큰당 $2.00 / $10.00에서 $4.00 / $20.00로
- 2027년 1월 1일Gemini 3.8 Flash와 Gemini 3.6 Flash가 1M 토큰당 $0.75 / $3.75에서 $1.50 / $7.50로
목록에 없는 것을 보세요: 세 가지 Flash-Lite 모델입니다. 가격은 표와 그대로 유지됩니다. Gemini 3.6 Flash는 페이지에서 이전 세대로 표시되므로, 오늘 새 Flash 모델을 고른다면 인상은 더 저렴한 행을 살펴볼 또 하나의 이유입니다.
가격 페이지에는 gemini-의 종료 날짜가 없습니다. 가장 저렴한 행 위에 1년짜리 제품을 만들기 전에 Google의 지원 중단 페이지를 열어 확인하세요.
요청 1,000건의 비용#
1M 토큰당 가격은 체감하기 어렵습니다. 작업 단위가 더 쉽습니다. 티켓을 요약하는 지원 봇을 운영한다고 가정해 봅시다: 각 요청은 약 800 토큰을 보내고 약 300 토큰을 받습니다. 그러면 1,000건은 입력 0.8M 토큰, 출력 0.3M 토큰입니다. Gemini 표준 가격 기준:
- Gemini 2.5 Flash-Lite: 입력 0.8 × $0.10 = $0.08, 출력 0.3 × $0.40 = $0.12, 총 $0.08 + $0.12 = $0.20.
- Gemini 3.1 Flash-Lite: 입력 0.8 × $0.25 = $0.20, 출력 0.3 × $1.50 = $0.45, 총 $0.20 + $0.45 = $0.65.
- Gemini 3.5 Flash-Lite: 입력 0.8 × $0.30 = $0.24, 출력 0.3 × $2.50 = $0.75, 총 $0.24 + $0.75 = $0.99.
- Gemini 4 Argon: 입력 0.8 × $2.00 = $1.60, 출력 0.3 × $10.00 = $3.00, 지금은 총 $1.60 + $3.00 = $4.60이고, 12월 1일부터는 0.8 × $4.00 = $3.20에 0.3 × $20.00 = $6.00을 더해 $9.20입니다.
패턴이 보이나요? 출력 가격이 타격을 줍니다. Flash-Lite 세대는 입력에서 차이가 작지만($0.10에서 $0.30) 출력은 $0.40에서 $2.50로 올라가고, 짧은 답변 워크로드는 이를 체감합니다.
이제 같은 1,000건의 요청을 CheapTokens로 보냅니다. 먼저 한 줄: MiniMax-M2.7(MiniMaxAI/)은 이 워크로드를 $0.085에 처리합니다. 아래 실시간 표에는 세 모델 모두와 OpenRouter의 참조 가격이 나란히 있습니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 1,000회 요청 | OpenRouter, 1,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
요청당 입력 800개 및 출력 300개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
표는 페이지가 로드될 때마다 현재 가격으로 다시 계산되므로 요금이 바뀌어도 정확합니다. 입력과 출력은 함께 계산되며, 그 합계에서 세 CheapTokens 모델 모두 OpenRouter 참조 가격보다 낮습니다. Gemini 2.5 Flash-Lite는 같은 1,000건에 $0.20이 듭니다; 위 표는 정확히 이 워크로드의 CheapTokens 합계를 입력과 출력을 합쳐 보여줍니다 — 둘을 나란히 읽어 보세요.
사고 토큰 함정#
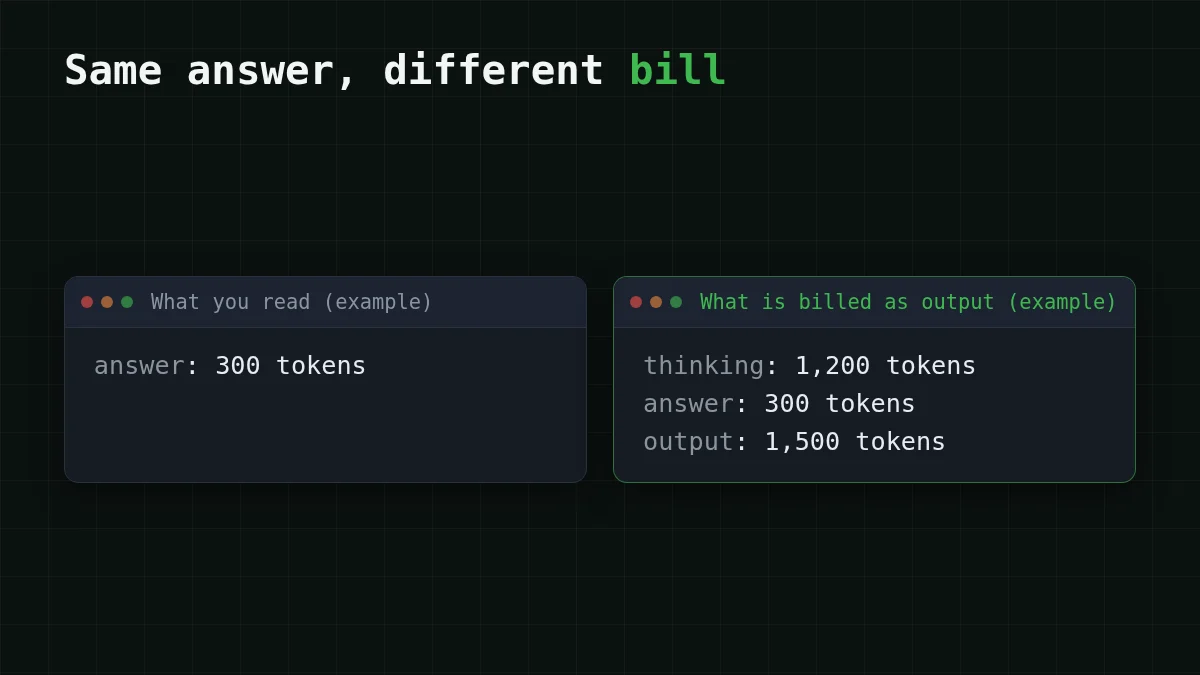
incl. thinking 헤더로 돌아갑니다. 답하기 전에 사고하는 모델은 보이지 않는 추가 토큰을 쓰고, Gemini는 이를 출력으로 청구합니다. 각 티켓 요약이 300 토큰 답변 위에 1,200 사고 토큰을 유발한다고 가정해 봅시다. 요청당 출력은 이제 1,500 토큰이므로 1,000건은 2.5 Flash-Lite에서 1.5 × $0.40 = $0.60의 출력이 되어 $0.12에서 올라갑니다. 보이는 답변은 같지만 출력 항목은 다섯 배입니다.
빠른 확인
Gemini 답변은 300 토큰인데 청구서에는 출력 토큰 1,500이 표시됩니다. 가장 가능성 높은 원인은?
정답 보기
정답: 모델이 약 1,200 토큰을 사고에 썼고, 사고는 출력으로 청구됨
Google의 출력 열에는 사고 토큰이 포함되므로 숨은 추론이 청구서의 출력 쪽에 나타납니다. 한 달을 추정하기 전에 실제 응답 몇 개의 사용량 수치를 확인하세요.
무엇을 고를까#
올바른 행은 단일 순위가 아니라 무엇을 하는지에 달려 있습니다.
사례 선택하기
어떤 설정이 당신의 사례에 맞나요?
답을 보려면 옵션을 선택하세요
트래픽이 아주 적은 프로토타입
무료 티어가 있는 모델 중 하나에서 Gemini 무료 티어를 사용하세요. 배우는 수단으로 여기고, 출시 전에 같은 모델의 유료 가격을 예산에 넣으세요.
짧은 대화형 요청이 많음
Gemini 2.5 Flash-Lite는 가장 저렴한 유료 Gemini 행입니다. 위 비용 표의 합계를 Gemini의 $0.20과 비교하세요: DeepSeek-V4-Flash는 하루 중 언제든 고정 가격, 380K 컨텍스트, 답변당 최대 32,768 출력 토큰을 제공하며 모든 모델에 걸쳐 하나의 잔액을 씁니다.
기다릴 수 있는 큰 작업
비동기 결과를 감수할 수 있다면 Gemini의 Batch API가 가격을 절반으로 줄입니다. 같은 요청에서 답을 받고 싶다면 GLM-5.3-Flash(390K 컨텍스트, 최대 8,192 출력 토큰)가 표의 저비용 소형 모델입니다.
코딩 에이전트와 긴 루프
MiniMax-M2.7은 에이전트 및 코딩 작업을 위한 CheapTokens 모델입니다(180K 컨텍스트, 최대 8,192 출력 토큰). 에이전트 루프는 입력을 많이 다시 보내므로 실제 실행을 먼저 측정하세요; GLM vs DeepSeek vs MiniMax에서 세 모델 중 선택하는 방법을 다룹니다.
가격은 선택의 절반일 뿐입니다. 두세 후보에 자신의 프롬프트를 실행해 답변을 비교한 뒤 무엇이든 전환하세요.
CheapTokens에서 같은 요청 시도하기#
API는 OpenAI 및 Anthropic과 호환되므로 호출은 일반 채팅 요청과 같습니다. 문서에서 모델 id를 가져오고 — 제공자마다 다릅니다 — 응답에서 usage을 읽으세요: 위 표에 쓸 요청당 실제 토큰을 알려줍니다.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
모든 모델의 현재 가격은 가격 페이지에 있고, DeepSeek-V4-Flash 모델 페이지에 모델 세부 정보가 있습니다.


