Modèles & comparaisonsComparaison
Le modèle d'API Gemini le moins cher en 2026 : les prix Flash-Lite comparés
Quel modèle Gemini a le prix payant le plus bas, lesquels ont un palier gratuit, ce qui double le 1er déc. et le 1er janv., et ce que coûtent 1 000 requêtes face aux modèles CheapTokens.
Sur cette page
Vous voulez le modèle Gemini le moins cher, et la grille tarifaire de Google a plus de lignes que vous n'avez de patience. Voici la version courte. Sur la page de tarification de l'API Gemini (mise à jour le 27 octobre 2026, vérifiée le 29 octobre), Gemini 2.5 Flash-Lite (gemini-) affiche le prix texte payant le plus bas : 0,10 $ par 1M de tokens d'entrée et 0,40 $ par 1M de tokens de sortie. Il dispose aussi d'un palier gratuit, comme Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite et Gemini 2.5 Flash. Et deux hausses de prix figurent déjà sur la page : Gemini 4 Argon double le 1er décembre 2026, Gemini 3.8 Flash et 3.6 Flash doublent le 1er janvier 2027.
Ci-dessous : les prix côte à côte, ce qui change et quand, et ce que coûtent 1 000 requêtes ordinaires sur Gemini face aux modèles que vous pouvez appeler via CheapTokens. Pour la mécanique exacte de la facturation, tokens d'entrée vs tokens de sortie est l'explication courte.
Les prix Gemini aujourd'hui, par 1M de tokens#
Voici les prix texte standard du palier payant, tirés de la page de tarification de Google, au 29 octobre 2026.
Faites défiler le tableau vers la droite →
| Modèle | Entrée | Sortie | Palier gratuit |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | 0,10 $ | 0,40 $ | oui |
| Gemini 3.1 Flash-Lite | 0,25 $ | 1,50 $ | oui |
| Gemini 3.5 Flash-Lite | 0,30 $ | 2,50 $ | oui |
| Gemini 2.5 Flash | 0,30 $ | 2,50 $ | oui |
| Gemini 4 Argon | 2,00 $ | 10,00 $ | non |
Quelques détails se cachent dans les notes de bas de page. L'entrée audio coûte plus cher sur les modèles Flash-Lite (0,30 $ sur 2.5 Flash-Lite, 0,50 $ sur 3.1 Flash-Lite), donc un pipeline vocal ne correspondra pas à ce tableau. La Batch API applique 50 % de remise, mais elle est asynchrone : vous soumettez une tâche et récupérez les résultats plus tard, ce qui convient aux traitements de nuit, pas à une fenêtre de chat. Et la colonne de sortie est intitulée Sortie (incl. réflexion), ce qui compte plus qu'il n'y paraît. On y revient dans une minute.
Gemini 3.1 Pro Preview se situe plus haut, à 2,00 $ / 12,00 $ pour les prompts jusqu'à 200k tokens et 4,00 $ / 18,00 $ au-delà. Seuls lui et Gemini 2.5 Pro ont ce découpage à 200k.
Quels prix doublent, et quand#
Si vous prototypiez sur un palier gratuit, prévoyez le prix payant dès le premier jour, et gardez ces dates en tête. Notre article dédié à la tarification de Gemini 4 Argon détaille ce modèle.
Chronologie
Changements de prix Gemini déjà sur la page de Google
- 27 oct. 2026dernière mise à jour de la page de tarification ; Gemini 2.5 Flash-Lite est le prix texte payant le plus bas
- 1er déc. 2026Gemini 4 Argon passe de 2,00 $ / 10,00 $ à 4,00 $ / 20,00 $ par 1M de tokens
- 1er janv. 2027Gemini 3.8 Flash et Gemini 3.6 Flash passent de 0,75 $ / 3,75 $ à 1,50 $ / 7,50 $ par 1M de tokens
Remarquez ce qui n'est pas sur cette liste : les trois modèles Flash-Lite. Leurs prix restent ceux du tableau. Gemini 3.6 Flash est étiqueté génération précédente sur la page, donc si vous choisissez un nouveau modèle Flash aujourd'hui, la hausse est une raison de plus de regarder les lignes moins chères.
La page de tarification ne donne aucune date d'arrêt pour gemini-. Avant de bâtir un produit sur un an sur la ligne la moins chère, ouvrez la page des dépréciations de Google et cherchez-en une.
Ce que coûtent 1 000 requêtes#
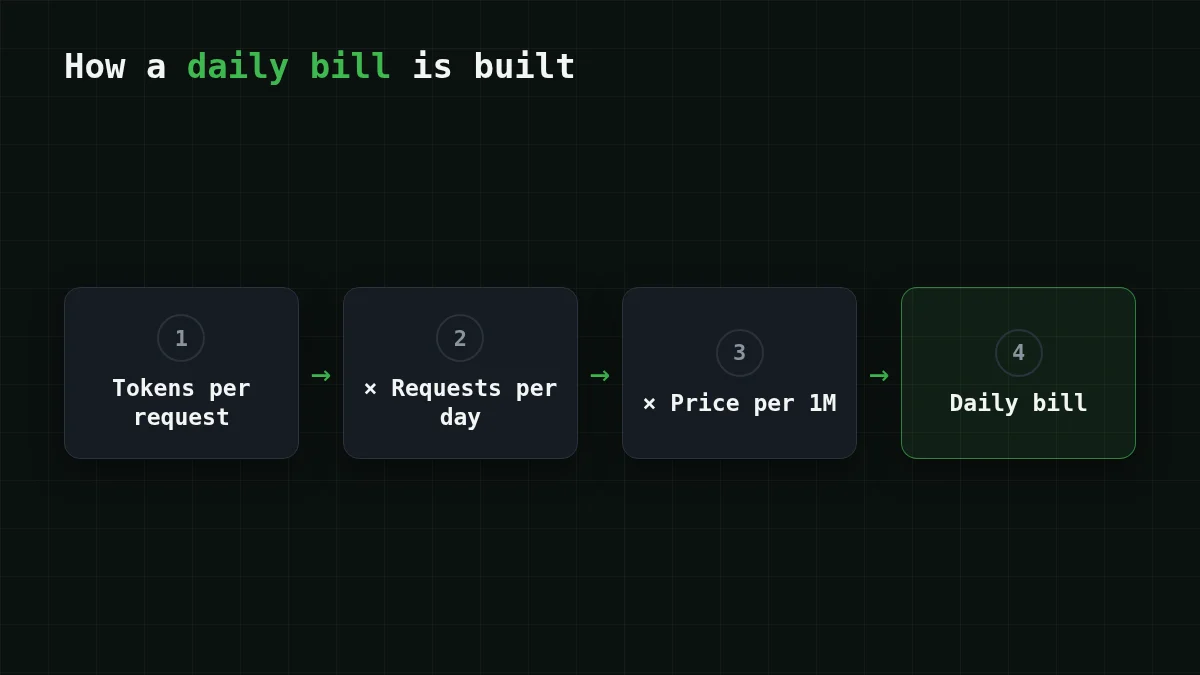
Le prix par 1M de tokens est difficile à ressentir. Une tâche, c'est plus simple. Disons que vous faites tourner un bot de support qui résume des tickets : chaque requête envoie environ 800 tokens en entrée et reçoit environ 300 tokens en sortie. Mille requêtes représentent donc 0,8M de tokens d'entrée et 0,3M de tokens de sortie. Aux prix standard de Gemini :
- Gemini 2.5 Flash-Lite : entrée 0,8 × 0,10 $ = 0,08 $, sortie 0,3 × 0,40 $ = 0,12 $, soit 0,08 $ + 0,12 $ = 0,20 $ au total.
- Gemini 3.1 Flash-Lite : entrée 0,8 × 0,25 $ = 0,20 $, sortie 0,3 × 1,50 $ = 0,45 $, soit 0,20 $ + 0,45 $ = 0,65 $ au total.
- Gemini 3.5 Flash-Lite : entrée 0,8 × 0,30 $ = 0,24 $, sortie 0,3 × 2,50 $ = 0,75 $, soit 0,24 $ + 0,75 $ = 0,99 $ au total.
- Gemini 4 Argon : entrée 0,8 × 2,00 $ = 1,60 $, sortie 0,3 × 10,00 $ = 3,00 $, soit 1,60 $ + 3,00 $ = 4,60 $ aujourd'hui, et 0,8 × 4,00 $ = 3,20 $ plus 0,3 × 20,00 $ = 6,00 $ font 9,20 $ à partir du 1er décembre.
Vous voyez le schéma ? C'est le prix de sortie qui fait mal. Les générations Flash-Lite diffèrent peu en entrée (0,10 $ à 0,30 $) mais la sortie grimpe de 0,40 $ à 2,50 $, et une charge de travail à réponses courtes le ressent.
Maintenant, les mêmes 1 000 requêtes via CheapTokens. Une ligne d'abord : MiniMax-M2.7 (MiniMaxAI/) exécute cette charge de travail pour $0.085. Le tableau en direct ci-dessous présente les trois modèles avec le prix de référence d'OpenRouter à côté :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 tokens d'entrée et 300 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Le tableau se recalcule à partir des prix actuels à chaque chargement de la page, il reste donc correct quand les tarifs bougent. Entrée et sortie sont comptées ensemble, et dans ce total les trois modèles CheapTokens passent sous le prix de référence d'OpenRouter. Gemini 2.5 Flash-Lite prend 0,20 $ pour les mêmes 1 000 requêtes ; le tableau ci-dessus montre les totaux CheapTokens pour exactement cette charge de travail, entrée et sortie ensemble — lisez les deux côte à côte.
Le piège des tokens de réflexion#
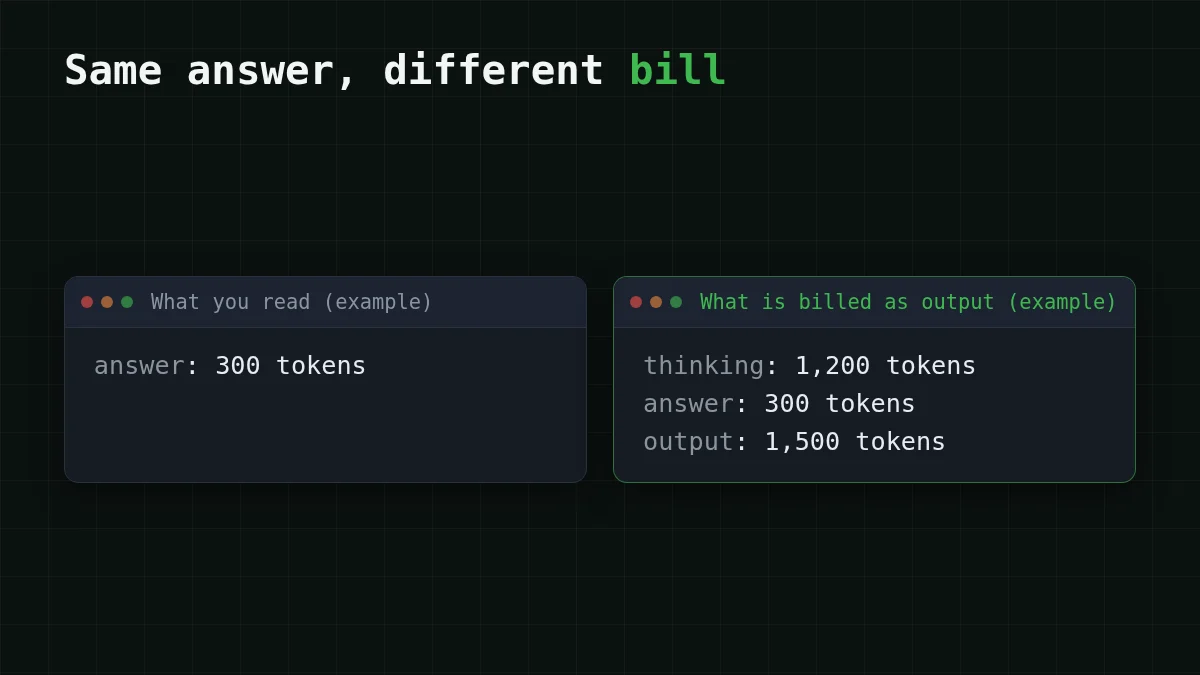
Revenons à cet en-tête incl. réflexion. Un modèle qui réfléchit avant de répondre écrit des tokens supplémentaires que vous ne voyez jamais, et Gemini les facture comme de la sortie. Disons que chaque résumé de ticket déclenche 1 200 tokens de réflexion en plus de la réponse de 300 tokens. La sortie par requête est alors de 1 500 tokens, donc mille requêtes donnent 1,5 × 0,40 $ = 0,60 $ de sortie sur 2.5 Flash-Lite, contre 0,12 $. Même réponse visible, ligne de sortie multipliée par cinq.
Vérification rapide
Votre réponse Gemini fait 300 tokens, mais la facture affiche 1 500 tokens de sortie. Que s'est-il probablement passé ?
Afficher la réponse
Réponse: Le modèle a passé environ 1 200 tokens à réfléchir, et la réflexion est facturée comme de la sortie
La colonne de sortie de Google inclut les tokens de réflexion, donc le raisonnement caché apparaît du côté sortie de la facture. Vérifiez les chiffres d'usage sur quelques vraies réponses avant d'estimer un mois.
Lequel choisir#
La bonne ligne dépend de ce que vous faites, pas d'un classement unique.
Choisissez votre cas
Quelle configuration correspond à votre cas ?
Choisissez une option pour voir la réponse
Prototype à très faible trafic
Utilisez le palier gratuit de Gemini sur l'un des modèles qui en disposent. Traitez-le comme un moyen d'apprendre, et inscrivez le prix payant du même modèle dans votre budget avant de livrer.
Beaucoup de requêtes interactives courtes
Gemini 2.5 Flash-Lite est la ligne Gemini payante la moins chère. Comparez les totaux du tableau de coûts ci-dessus avec les 0,20 $ de Gemini : DeepSeek-V4-Flash vous offre un prix fixe à toute heure, un contexte de 380K et jusqu'à 32 768 tokens de sortie par réponse, avec un seul solde pour tous les modèles.
Gros traitements qui peuvent attendre
La Batch API de Gemini divise le prix par deux, si vous pouvez vivre avec des résultats asynchrones. Si vous préférez obtenir les réponses dans la même requête, GLM-5.3-Flash (contexte de 390K, jusqu'à 8 192 tokens de sortie) est le petit modèle économique du tableau.
Agents de codage et boucles longues
MiniMax-M2.7 est le modèle CheapTokens pour le travail agentique et de codage (contexte de 180K, jusqu'à 8 192 tokens de sortie). Les boucles d'agents renvoient beaucoup d'entrée, donc mesurez d'abord une vraie exécution ; GLM vs DeepSeek vs MiniMax explique comment choisir entre les trois.
Le prix n'est que la moitié d'un choix. Lancez vos propres prompts sur les deux ou trois candidats et comparez les réponses avant de changer quoi que ce soit.
Essayez la même requête sur CheapTokens#
L'API est compatible OpenAI et Anthropic, donc l'appel ressemble à n'importe quelle requête de chat. Récupérez l'id du modèle dans la documentation — il diffère selon les fournisseurs — et lisez usage dans la réponse : cela vous donne les vrais tokens par requête pour le tableau ci-dessus.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Les prix actuels de chaque modèle sont sur la page de tarification, et la page du modèle DeepSeek-V4-Flash contient les détails du modèle.


