Modèles & comparaisonsComparaison
Le modèle d'API DeepSeek le moins cher en 2026 : deepseek-flash vs Pro
Prix officiels de l'API DeepSeek vérifiés le 29 oct. 2026 : Flash vs Pro, pointe vs hors pointe, touchés de cache, et ce que coûtent vraiment un bot de support et un agent.
Sur cette page
Votre facture DeepSeek dépend de trois choses que le prix par token ne montre pas : le modèle que vous appelez, l'heure à laquelle vous l'appelez, et la part de votre prompt que le cache retient. La réponse courte : des deux modèles officiels, deepseek-flash est le moins cher dans toutes les colonnes. Hors pointe, il coûte 0,15 $ par 1M de tokens d'entrée (échec de cache) et 0,60 $ par 1M de tokens de sortie. En pointe, les deux doublent.
Les prix ci-dessous proviennent de la page tarifaire de DeepSeek, récupérée le 29 octobre 2026. La page ne porte aucune date de publication, considérez donc la date de récupération comme date des prix.
Deux modèles officiels, un renommage#
L'API officielle vend deux modèles : deepseek-flash, servi par DeepSeek-V4.1-Flash-1017, et deepseek-v4-pro, servi par DeepSeek-V4-Pro-0813. Les deux affichent un contexte de 1M et jusqu'à 384K tokens de sortie.
Si votre code dit encore deepseek- ou deepseek-, rien ne casse. La note de version du 17 octobre 2026 de DeepSeek indique que ces modèles sont retirés et que leurs noms routent désormais vers DeepSeek-V4.1-Flash-1017 au prix Flash. Ce qui a changé dans le modèle est couvert dans l'article sur la version.
Voici les prix par 1M de tokens, en USD :
Faites défiler le tableau vers la droite →
| Par 1M de tokens | Flash, hors pointe | Flash, pointe | Pro, hors pointe | Pro, pointe |
|---|---|---|---|---|
| Entrée, cache touché | 0,003 $ | 0,006 $ | 0,022 $ | 0,044 $ |
| Entrée, cache manqué | 0,15 $ | 0,30 $ | 0,66 $ | 1,32 $ |
| Sortie | 0,60 $ | 1,20 $ | 1,98 $ | 3,96 $ |
« Cache touché » signifie que DeepSeek reconnaît le début de votre prompt à partir d'une requête antérieure et facture cette partie au tarif réduit. Le cache de prompt expliqué en détaille le mécanisme. Tout ce qui n'est pas un touché est un manqué.
Heures de pointe : même requête, prix doublé#
La pointe est de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, sauf jours fériés chinois. En dehors de ces fenêtres, vous payez le prix hors pointe, soit la moitié.
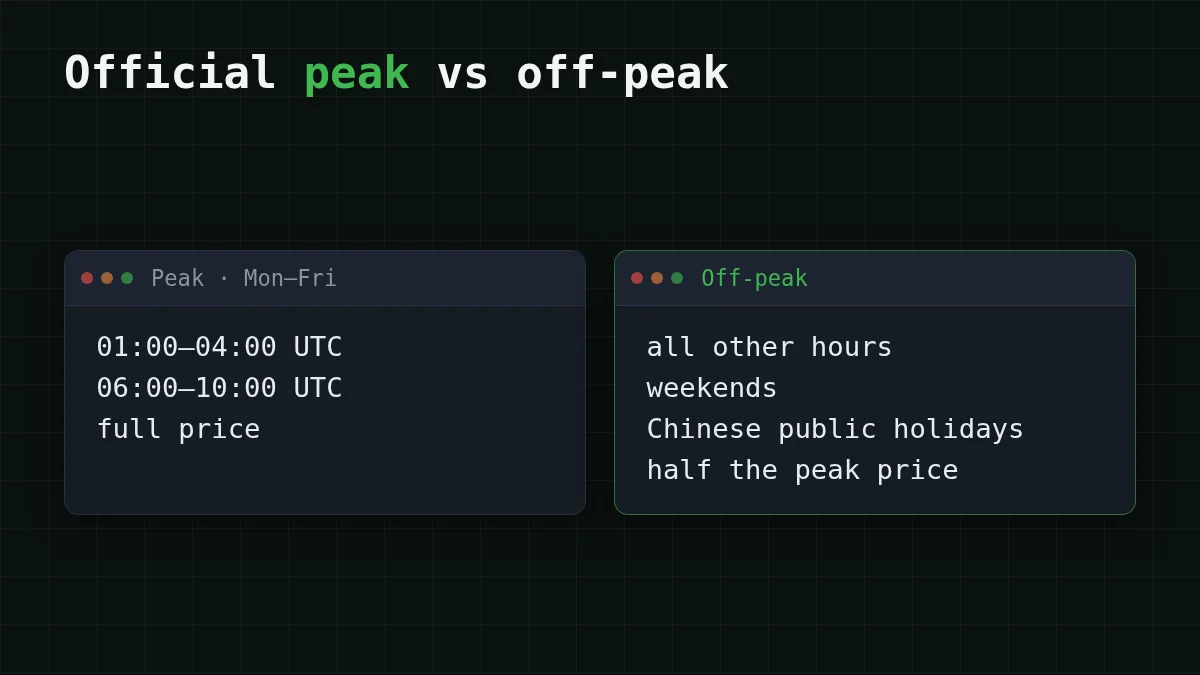
Sept heures par jour semblent peu. C'est peu : 7 × 5 = 35 des 168 heures de la semaine, environ un cinquième. Mais ces fenêtres couvrent la majeure partie de la journée de travail à Pékin et la matinée européenne, donc un bot qui parle aux gens de ces fuseaux vit à l'intérieur. Un job qui tourne à 22:00 UTC ne voit jamais les tarifs de pointe.
Devinez le nombre
Combien d'heures d'un jour de semaine tombent dans les fenêtres de pointe officielles ?
Votre estimation
024
Afficher la réponse
Réponse: 7
Sept : 01:00–04:00 fait 3 heures et 06:00–10:00 fait 4 heures, et 3 + 4 = 7.
Un bot de support : 1 000 requêtes par jour#
Disons que vous exploitez un bot de support. Chaque requête porte environ 1 500 tokens d'entrée (les instructions plus le message du client) et renvoie environ 400 tokens. Cela fait 1,5M de tokens d'entrée et 0,4M de tokens de sortie par jour, et pour simplifier rien ne touche le cache.
Sur deepseek-flash en pointe, l'entrée est 1,5 × 0,30 $ = 0,45 $. La sortie est 0,4 × 1,20 $ = 0,48 $. Une journée revient à 0,45 $ + 0,48 $ = 0,93 $. Hors pointe, l'entrée est 1,5 × 0,15 $ = 0,225 $ et la sortie est 0,4 × 0,60 $ = 0,24 $, donc une journée est 0,225 $ + 0,24 $ = 0,465 $.
Sur deepseek-v4-pro en pointe, l'entrée est 1,5 × 1,32 $ = 1,98 $. La sortie est 0,4 × 3,96 $ = 1,584 $. Une journée revient à 1,98 $ + 1,584 $ = 3,564 $.
Regardez où va l'argent. Sur Flash, les réponses de 400 tokens coûtent légèrement plus que les prompts de 1 500 tokens, car la sortie est le côté cher. Et Pro est le modèle que vous choisissez après qu'un test sur vos propres tickets montre que les réponses de Flash sont insuffisantes, pas avant : ce test vaut 3,564 $ par jour en pointe.
Une boucle d'agent : où le cache paie#
Un agent de codage est l'opposé d'un chatbot. Chaque étape renvoie le même gros préfixe : instructions, définitions d'outils, fichiers déjà lus. Disons qu'une exécution fait 100 étapes avec 30 000 tokens d'entrée et 2 000 tokens de sortie chacune, et que 80 % de chaque prompt est ce préfixe répété. Cela fait 3M de tokens d'entrée (2,4M touchés, 0,6M manqués) et 0,2M de tokens de sortie.
Sur deepseek-flash en pointe, sans aucun cache : 3 × 0,30 $ = 0,90 $ pour l'entrée plus 0,2 × 1,20 $ = 0,24 $ pour la sortie, 0,90 $ + 0,24 $ = 1,14 $.
Avec le taux de touché de 80 % : 2,4 × 0,006 $ = 0,0144 $ pour les touchés, 0,6 × 0,30 $ = 0,18 $ pour les manqués, et les mêmes 0,24 $ pour la sortie, 0,0144 $ + 0,18 $ + 0,24 $ = 0,4344 $.
Le cache a fait passer l'entrée de 0,90 $ à 0,1944 $ et a fait de la sortie la plus grosse ligne de la facture. C'est le schéma avec les agents : une fois le préfixe en cache, les réponses coûtent plus que la lecture. Gardez le début de votre prompt identique d'une étape à l'autre, et mettez ce qui change à la fin.
Changez les chiffres pour votre propre boucle :
Calculateur de coût
Un agent de codage : 100 étapes
Tokens d'entrée par requête: 30 000 · Tokens de sortie par requête: 2 000 · Requêtes par jour: 100
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
Le calculateur utilise les prix en direct, il bouge donc quand la liste de prix bouge. Les chiffres officiels ci-dessus restent au 29 octobre 2026.
Quelle configuration convient à votre travail#
Choisissez votre cas
Choisissez le travail le plus proche
Choisissez une option pour voir la réponse
Bot de support, trafic toute la journée
Le trafic n'attend pas l'hors pointe. Officiellement, deepseek-flash en pointe est le chiffre avec lequel planifier : 0,30 $ en entrée et 1,20 $ en sortie par 1M de tokens. Un prix unique à toute heure, comme DeepSeek-V4-Flash sur CheapTokens, rend la facture mensuelle facile à prévoir.
Job par lots de nuit
Déplacez le planning en dehors de 01:00–04:00 et 06:00–10:00 UTC et le prix officiel hors pointe s'applique, la moitié de la pointe. Si le job ne peut pas bouger, le prix de pointe est le vrai.
Agent avec un gros prompt répété
Gardez le préfixe du prompt stable pour que le taux de touché du cache reste élevé, et attendez-vous à ce que la sortie devienne la plus grosse part de la facture. Un prix fixe sans fenêtres de pointe rend une boucle comme celle-ci facile à budgéter.
Flash ne suffit pas
Testez deepseek-v4-pro sur un échantillon de vos propres tâches d'abord. Son entrée en cache manqué est de 1,32 $ en pointe et sa sortie de 3,96 $, il devrait donc mériter ce prix sur vos données.
Les mêmes charges sur CheapTokens#
Pour le bot de support et la boucle d'agent, CheapTokens propose DeepSeek-V4-Flash : id deepseek-, contexte de 380K, jusqu'à 32 768 tokens de sortie par réponse. C'est un prix unique à toute heure, sans fenêtres de pointe, un solde pour tous les modèles, et une API compatible OpenAI et Anthropic à https:/. Au total, entrée et sortie comptées ensemble, c'est moins cher qu'OpenRouter.
Une requête de bot de support (1 500 en entrée, 400 en sortie) coûte $0.000063. L'exécution d'agent de 100 étapes ci-dessus (3M en entrée, 0,2M en sortie) coûte $0.065. Le tableau ci-dessous est la journée du bot, 1 000 requêtes, sur tous nos modèles avec la colonne OpenRouter à côté ; mettez-le en regard des chiffres officiels ci-dessus :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
1 500 tokens d'entrée et 400 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
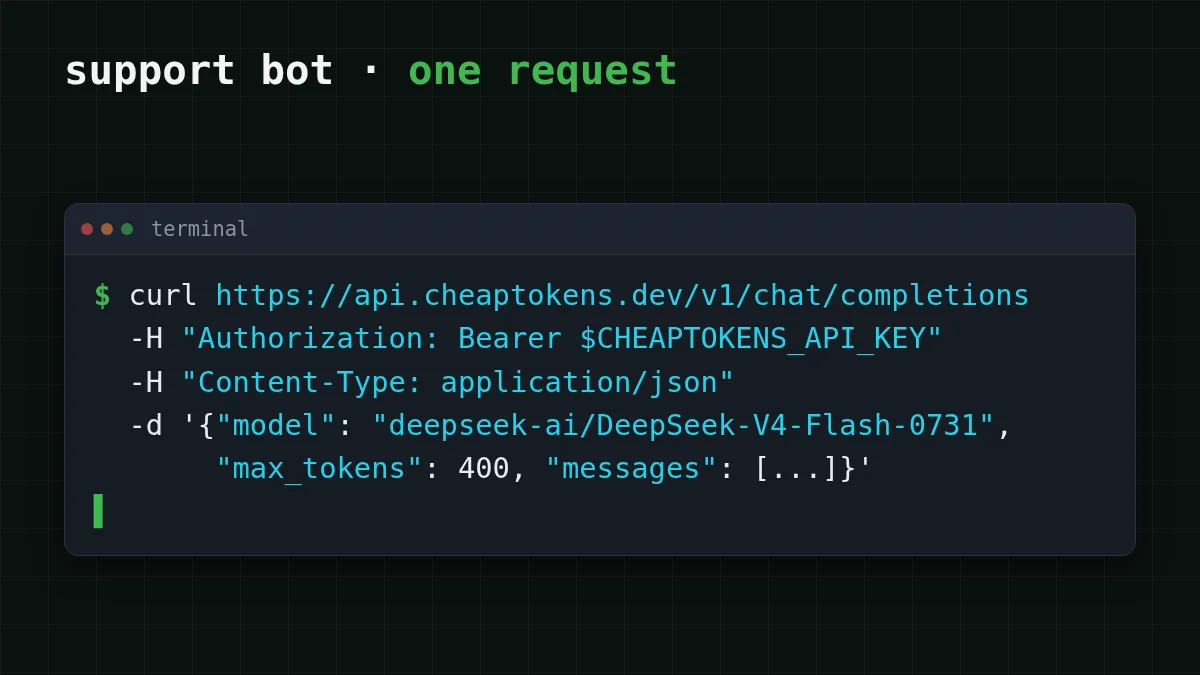
Pour envoyer vous-même la requête du bot (utilisez l'id exactement tel qu'écrit ; les ids courts des étiquettes de prix ne sont pas acceptés) :
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
La réponse contient un bloc usage avec les vrais comptes de tokens d'entrée et de sortie. Multipliez-les par les prix en direct, ou collez-les dans le tableau ci-dessus, et vous avez le coût de votre propre requête au lieu d'une estimation.
Pour les détails de connexion, voir la documentation CheapTokens, la page DeepSeek et le tableau des prix en direct. Si vous comparez DeepSeek à une autre famille, MiniMax-M2.7 vs DeepSeek-V4-Flash les met côte à côte sur les mêmes tâches.


