Mô hình & so sánhSo sánh
Mô hình API DeepSeek rẻ nhất năm 2026: deepseek-flash so với Pro
Giá API DeepSeek chính thức được kiểm tra ngày 29 tháng 10 năm 2026: Flash so với Pro, giờ cao điểm so với ngoài giờ cao điểm, cache hit, và chi phí thực của một bot hỗ trợ và một agent.
Trên trang này
Hóa đơn DeepSeek của bạn phụ thuộc vào ba điều mà giá trên mỗi token không hiển thị: bạn gọi mô hình nào, bạn gọi vào giờ nào và bộ nhớ đệm nhớ được bao nhiêu phần trong prompt của bạn. Câu trả lời ngắn gọn: trong hai mô hình chính thức, deepseek-flash là mô hình rẻ hơn ở mọi cột. Ngoài giờ cao điểm, nó có giá $0.15 cho 1M token đầu vào (cache miss) và $0.60 cho 1M token đầu ra. Vào giờ cao điểm, cả hai đều tăng gấp đôi.
Giá bên dưới được lấy từ trang giá của DeepSeek, truy cập ngày 29 tháng 10 năm 2026. Trang không có ngày xuất bản, nên hãy coi ngày truy cập là ngày giá.
Hai mô hình chính thức, một lần đổi tên#
API chính thức bán hai mô hình: deepseek-flash, được phục vụ bởi DeepSeek-V4.1-Flash-1017, và deepseek-v4-pro, được phục vụ bởi DeepSeek-V4-Pro-0813. Cả hai đều có ngữ cảnh 1M và tối đa 384K token đầu ra.
Nếu mã của bạn vẫn ghi deepseek- hoặc deepseek-, không có gì hỏng. Ghi chú phát hành ngày 17 tháng 10 năm 2026 của DeepSeek cho biết các mô hình đó đã ngừng hoạt động và tên của chúng giờ được định tuyến đến DeepSeek-V4.1-Flash-1017 với giá Flash. Những gì thay đổi bên trong mô hình được đề cập trong bài viết về bản phát hành.
Dưới đây là giá trên mỗi 1M token, tính bằng USD:
Cuộn bảng sang phải →
| Trên 1M token | Flash, ngoài giờ cao điểm | Flash, giờ cao điểm | Pro, ngoài giờ cao điểm | Pro, giờ cao điểm |
|---|---|---|---|---|
| Đầu vào, cache hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Đầu vào, cache miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Đầu ra | $0.60 | $1.20 | $1.98 | $3.96 |
"Cache hit" nghĩa là DeepSeek nhận ra phần đầu trong prompt của bạn từ một yêu cầu trước đó và tính phần đó với mức giá rẻ. Giải thích về bộ nhớ đệm prompt có cơ chế. Mọi thứ không phải hit đều là miss.
Giờ cao điểm: cùng yêu cầu, gấp đôi giá#
Giờ cao điểm là 01:00–04:00 và 06:00–10:00 UTC, từ thứ Hai đến thứ Sáu, trừ các ngày lễ công cộng của Trung Quốc. Ngoài các khung giờ đó, bạn trả giá ngoài giờ cao điểm, tức là một nửa.
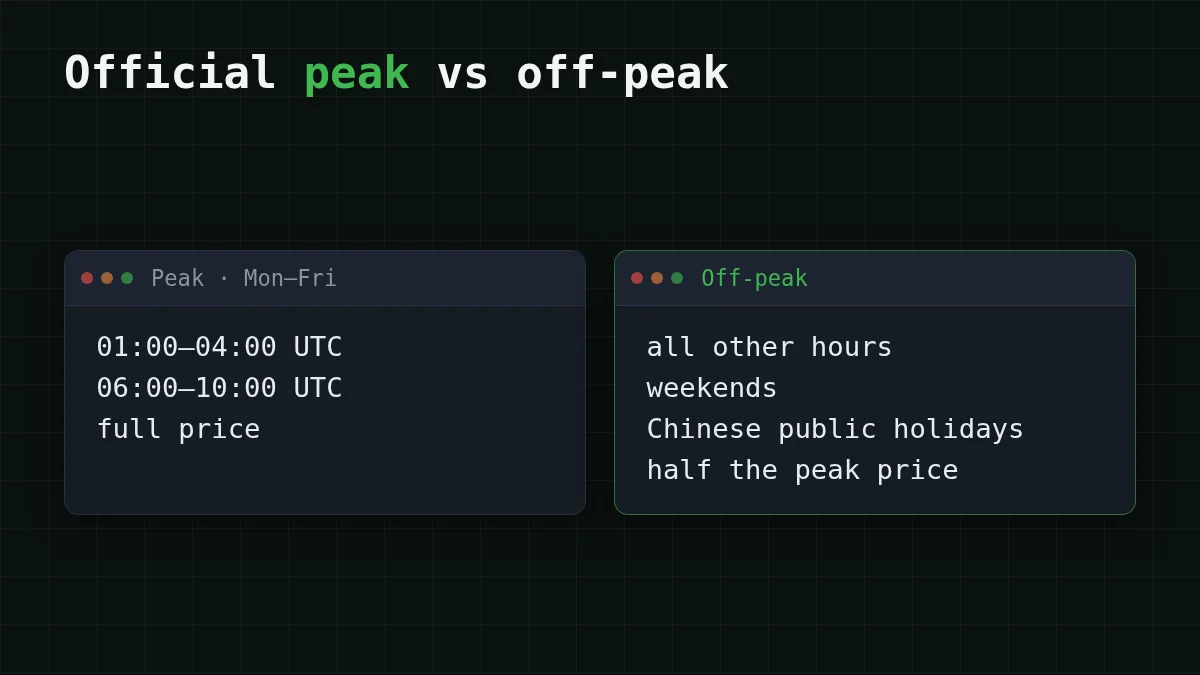
Bảy giờ một ngày nghe có vẻ ít. Đúng là ít: 7 × 5 = 35 trong 168 giờ của tuần, khoảng một phần năm. Nhưng các khung giờ đó bao phủ phần lớn ngày làm việc ở Bắc Kinh và buổi sáng châu Âu, nên một bot trò chuyện với người ở các múi giờ đó sống bên trong chúng. Một tác vụ chạy lúc 22:00 UTC không bao giờ thấy giá cao điểm.
Đoán số
Có bao nhiêu giờ của một ngày trong tuần nằm trong khung giờ cao điểm chính thức?
Dự đoán của bạn
024
Hiện đáp án
Trả lời: 7
Bảy: 01:00–04:00 là 3 giờ và 06:00–10:00 là 4 giờ, và 3 + 4 = 7.
Một bot hỗ trợ: 1.000 yêu cầu mỗi ngày#
Giả sử bạn chạy một bot hỗ trợ. Mỗi yêu cầu mang khoảng 1.500 token đầu vào (hướng dẫn cộng với tin nhắn của khách hàng) và trả về khoảng 400 token. Đó là 1,5M đầu vào và 0,4M đầu ra token mỗi ngày, và để đơn giản, không phần nào trúng bộ nhớ đệm.
Trên deepseek-flash vào giờ cao điểm, đầu vào là 1,5 × $0.30 = $0.45. Đầu ra là 0,4 × $1.20 = $0.48. Một ngày là $0.45 + $0.48 = $0.93. Ngoài giờ cao điểm, đầu vào là 1,5 × $0.15 = $0.225 và đầu ra là 0,4 × $0.60 = $0.24, vậy một ngày là $0.225 + $0.24 = $0.465.
Trên deepseek-v4-pro vào giờ cao điểm, đầu vào là 1,5 × $1.32 = $1.98. Đầu ra là 0,4 × $3.96 = $1.584. Một ngày là $1.98 + $1.584 = $3.564.
Hãy xem tiền đi đâu. Trên Flash, các câu trả lời 400 token tốn hơn một chút so với các prompt 1.500 token, vì đầu ra là phía đắt. Và Pro là mô hình bạn chọn sau khi thử nghiệm trên chính các ticket của bạn cho thấy câu trả lời của Flash chưa đủ, chứ không phải trước: thử nghiệm đó đáng giá $3.564 một ngày vào giờ cao điểm.
Một vòng lặp agent: nơi bộ nhớ đệm trả tiền#
Một agent lập trình là ngược lại với chatbot. Mỗi bước gửi lại cùng một tiền tố lớn: hướng dẫn, định nghĩa công cụ, các tệp nó đã đọc. Giả sử một lần chạy là 100 bước với 30.000 token đầu vào và 2.000 token đầu ra mỗi bước, và 80% mỗi prompt là tiền tố lặp lại đó. Đó là 3M token đầu vào (2,4M hit, 0,6M miss) và 0,2M token đầu ra.
Trên deepseek-flash vào giờ cao điểm, không có bộ nhớ đệm: 3 × $0.30 = $0.90 cho đầu vào cộng 0,2 × $1.20 = $0.24 cho đầu ra, $0.90 + $0.24 = $1.14.
Với tỷ lệ hit 80%: 2,4 × $0.006 = $0.0144 cho các hit, 0,6 × $0.30 = $0.18 cho các miss, và $0.24 tương tự cho đầu ra, $0.0144 + $0.18 + $0.24 = $0.4344.
Bộ nhớ đệm đưa đầu vào từ $0.90 xuống $0.1944 và biến đầu ra thành dòng lớn nhất trên hóa đơn. Đó là mô hình với agent: một khi tiền tố được lưu vào bộ nhớ đệm, câu trả lời tốn hơn việc đọc. Giữ phần đầu prompt giống hệt nhau từ bước này sang bước khác, và đặt những gì thay đổi ở cuối.
Thay đổi các con số cho vòng lặp của riêng bạn:
Máy tính chi phí
Một agent lập trình: 100 bước
Token đầu vào mỗi yêu cầu: 30.000 · Token đầu ra mỗi yêu cầu: 2.000 · Số yêu cầu mỗi ngày: 100
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
Máy tính dùng giá trực tiếp, nên nó thay đổi khi bảng giá thay đổi. Các số liệu chính thức ở trên vẫn tính đến ngày 29 tháng 10 năm 2026.
Cấu hình nào phù hợp với công việc của bạn#
Chọn trường hợp của bạn
Chọn công việc gần nhất
Chọn một tùy chọn để xem đáp án
Bot hỗ trợ, lưu lượng cả ngày
Lưu lượng không chờ ngoài giờ cao điểm. Về mặt chính thức, deepseek-flash vào giờ cao điểm là con số để lập kế hoạch: $0.30 đầu vào và $1.20 đầu ra trên 1M token. Một mức giá duy nhất ở mọi giờ, như DeepSeek-V4-Flash trên CheapTokens, giúp dễ dự đoán hóa đơn hàng tháng.
Tác vụ hàng loạt qua đêm
Chuyển lịch ra ngoài 01:00–04:00 và 06:00–10:00 UTC và giá ngoài giờ cao điểm chính thức sẽ áp dụng, bằng một nửa giờ cao điểm. Nếu tác vụ không thể di chuyển, giá cao điểm là giá thực.
Agent với prompt lặp lại lớn
Giữ tiền tố prompt ổn định để tỷ lệ cache hit cao, và dự kiến đầu ra sẽ trở thành phần lớn nhất của hóa đơn. Một mức giá cố định không có khung giờ cao điểm giúp dễ lập ngân sách cho một vòng lặp như thế này.
Flash không đủ tốt
Thử deepseek-v4-pro trên một mẫu các tác vụ của chính bạn trước. Đầu vào cache miss của nó là $1.32 vào giờ cao điểm và đầu ra là $3.96, nên nó phải xứng đáng với mức giá đó trên dữ liệu của bạn.
Cùng các tải đó trên CheapTokens#
Đối với bot hỗ trợ và vòng lặp agent, CheapTokens có DeepSeek-V4-Flash: id deepseek-, ngữ cảnh 380K, tối đa 32.768 token đầu ra mỗi câu trả lời. Đó là một mức giá ở mọi giờ, không có khung giờ cao điểm, một số dư cho tất cả mô hình, và API tương thích OpenAI và Anthropic tại https:/. Tổng cộng, khi tính cả đầu vào và đầu ra, nó rẻ hơn OpenRouter.
Một yêu cầu của bot hỗ trợ (1.500 vào, 400 ra) tốn $0.000063. Lần chạy agent 100 bước ở trên (3M vào, 0,2M ra) tốn $0.065. Bảng dưới đây là một ngày của bot, 1.000 yêu cầu, trên tất cả các mô hình của chúng tôi với cột OpenRouter bên cạnh; hãy đặt nó bên cạnh các số liệu chính thức ở trên:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
1.500 token đầu vào và 400 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
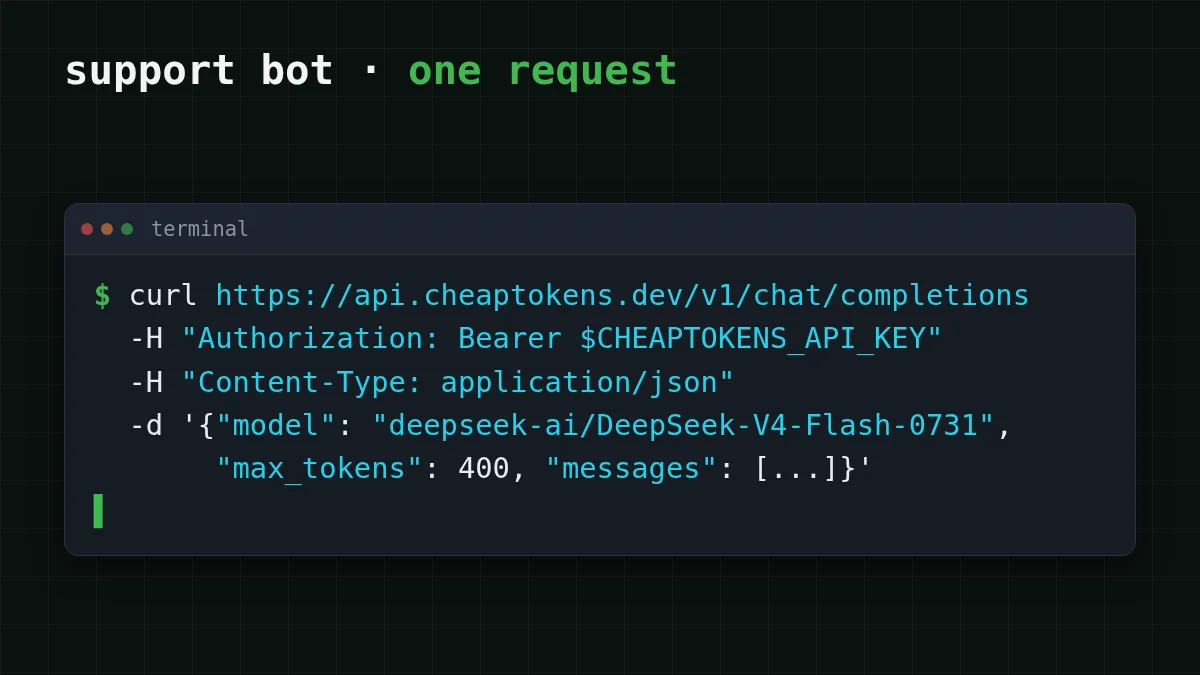
Để tự gửi yêu cầu của bot (dùng id chính xác như đã viết; id ngắn từ nhãn giá không được chấp nhận):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
Phản hồi có một khối usage với số lượng token đầu vào và đầu ra thực tế. Nhân chúng với giá trực tiếp, hoặc dán chúng vào bảng trên, và bạn có chi phí cho yêu cầu của chính mình thay vì phỏng đoán.
Để biết chi tiết kết nối, xem tài liệu CheapTokens, trang DeepSeek và bảng giá trực tiếp. Nếu bạn đang cân nhắc DeepSeek với một dòng mô hình khác, MiniMax-M2.7 so với DeepSeek-V4-Flash đặt chúng cạnh nhau trên cùng các tác vụ.


