Modelle & VergleicheVergleich
Günstigstes DeepSeek-API-Modell 2026: deepseek-flash vs Pro
Offizielle DeepSeek-API-Preise geprüft am 29. Okt. 2026: Flash vs Pro, Stoßzeit vs außerhalb der Stoßzeiten, Cache-Hits und was ein Support-Bot und ein Agent wirklich kosten.
Auf dieser Seite
Ihre DeepSeek-Rechnung hängt von drei Dingen ab, die der Preis pro Token nicht zeigt: welches Modell Sie aufrufen, zu welcher Stunde Sie es aufrufen und wie viel Ihres Prompts der Cache sich merkt. Die kurze Antwort: Von den beiden offiziellen Modellen ist deepseek-flash in jeder Spalte das günstigere. Außerhalb der Stoßzeiten kostet es $0.15 pro 1M Input-Tokens (Cache-Miss) und $0.60 pro 1M Output-Tokens. Zu Stoßzeiten verdoppeln sich beide.
Die Preise unten stammen von DeepSeeks Preisseite, abgerufen am 29. Oktober 2026. Die Seite trägt kein Veröffentlichungsdatum, behandeln Sie das Abrufdatum also als Preisdatum.
Zwei offizielle Modelle, eine Umbenennung#
Die offizielle API verkauft zwei Modelle: deepseek-flash, bedient von DeepSeek-V4.1-Flash-1017, und deepseek-v4-pro, bedient von DeepSeek-V4-Pro-0813. Beide geben einen Kontext von 1M und bis zu 384K Output-Tokens an.
Wenn Ihr Code noch deepseek- oder deepseek- sagt, bricht nichts. DeepSeeks Versionshinweis vom 17. Oktober 2026 besagt, dass diese Modelle eingestellt sind und ihre Namen jetzt zu DeepSeek-V4.1-Flash-1017 zum Flash-Preis führen. Was sich im Modell geändert hat, steht in der Beschreibung des Releases.
Hier sind die Preise pro 1M Tokens in USD:
Tabelle nach rechts scrollen →
| Pro 1M Tokens | Flash, außerhalb der Stoßzeiten | Flash, Stoßzeit | Pro, außerhalb der Stoßzeiten | Pro, Stoßzeit |
|---|---|---|---|---|
| Input, Cache-Hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Input, Cache-Miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Output | $0.60 | $1.20 | $1.98 | $3.96 |
„Cache-Hit“ bedeutet, dass DeepSeek den Anfang Ihres Prompts aus einer früheren Anfrage erkennt und diesen Teil zum günstigen Tarif abrechnet. Prompt-Caching erklärt beschreibt die Mechanik. Alles, was kein Hit ist, ist ein Miss.
Stoßzeiten: gleiche Anfrage, doppelter Preis#
Stoßzeit ist 01:00–04:00 und 06:00–10:00 UTC, Montag bis Freitag, außer an chinesischen Feiertagen. Außerhalb dieser Fenster zahlen Sie den Preis außerhalb der Stoßzeiten, also die Hälfte.
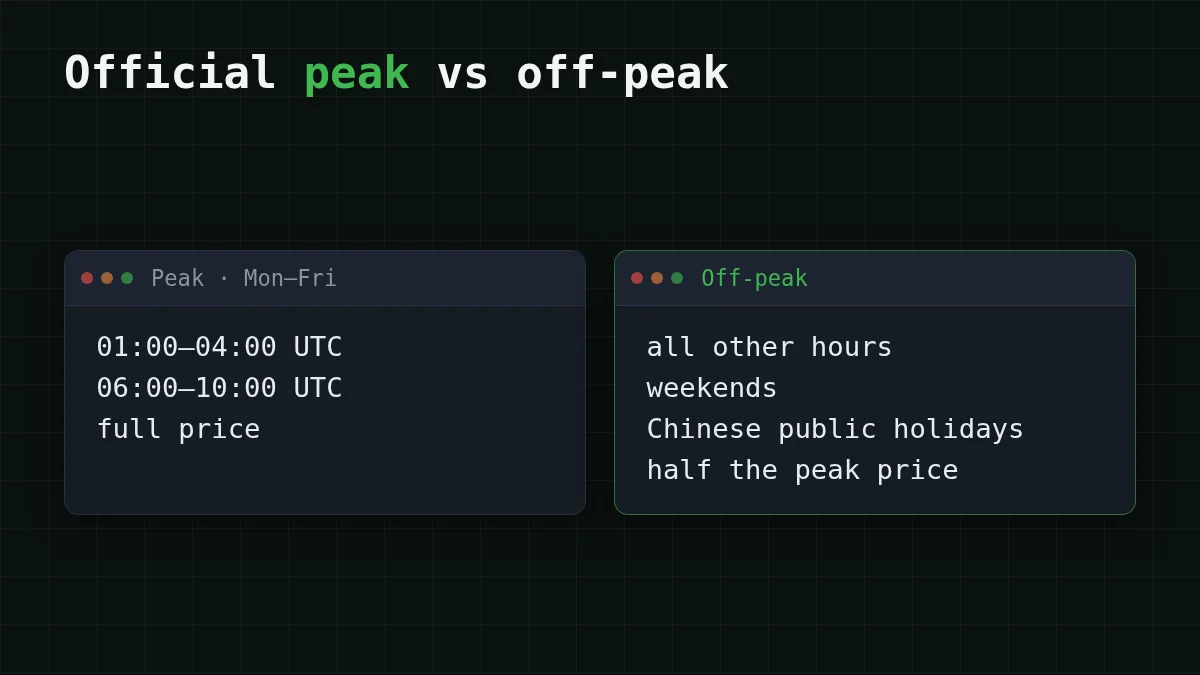
Sieben Stunden am Tag klingen wenig. Sind es aber: 7 × 5 = 35 der 168 Wochenstunden, etwa ein Fünftel. Doch diese Fenster decken den größten Teil des Pekinger Arbeitstags und den europäischen Vormittag ab, ein Bot, der in diesen Zeitzonen mit Menschen spricht, lebt also darin. Ein Job, der um 22:00 UTC läuft, sieht nie Stoßzeitenpreise.
Zahl erraten
Wie viele Stunden eines Wochentags fallen in die offiziellen Stoßzeitenfenster?
Deine Schätzung
024
Antwort anzeigen
Antwort: 7
Sieben: 01:00–04:00 sind 3 Stunden und 06:00–10:00 sind 4 Stunden, und 3 + 4 = 7.
Ein Support-Bot: 1.000 Anfragen pro Tag#
Angenommen, Sie betreiben einen Support-Bot. Jede Anfrage trägt etwa 1.500 Input-Tokens (die Anweisungen plus die Nachricht des Kunden) und liefert etwa 400 Tokens zurück. Das sind 1,5M Input- und 0,4M Output-Tokens pro Tag, und der Einfachheit halber trifft nichts davon den Cache.
Auf deepseek-flash zu Stoßzeiten kostet Input 1,5 × $0.30 = $0.45. Output kostet 0,4 × $1.20 = $0.48. Ein Tag kommt auf $0.45 + $0.48 = $0.93. Außerhalb der Stoßzeiten kostet Input 1,5 × $0.15 = $0.225 und Output 0,4 × $0.60 = $0.24, ein Tag kostet also $0.225 + $0.24 = $0.465.
Auf deepseek-v4-pro zu Stoßzeiten kostet Input 1,5 × $1.32 = $1.98. Output kostet 0,4 × $3.96 = $1.584. Ein Tag kommt auf $1.98 + $1.584 = $3.564.
Schauen Sie, wohin das Geld fließt. Bei Flash kosten die 400-Token-Antworten etwas mehr als die 1.500-Token-Prompts, weil Output die teure Seite ist. Und Pro ist das Modell, das Sie wählen, nachdem ein Test mit Ihren eigenen Tickets zeigt, dass Flashs Antworten nicht ausreichen, nicht davor: Dieser Test ist zu Stoßzeiten $3.564 pro Tag wert.
Eine Agent-Schleife: wo der Cache sich lohnt#
Ein Coding-Agent ist das Gegenteil eines Chatbots. Jeder Schritt sendet dasselbe große Präfix erneut: Anweisungen, Tool-Definitionen, die bereits gelesenen Dateien. Angenommen, ein Lauf umfasst 100 Schritte mit je 30.000 Input-Tokens und 2.000 Output-Tokens, und 80 % jedes Prompts sind dieses wiederholte Präfix. Das sind 3M Input-Tokens (2,4M Hits, 0,6M Misses) und 0,2M Output-Tokens.
Auf deepseek-flash zu Stoßzeiten, ganz ohne Cache: 3 × $0.30 = $0.90 für Input plus 0,2 × $1.20 = $0.24 für Output, $0.90 + $0.24 = $1.14.
Mit der Hit-Rate von 80 %: 2,4 × $0.006 = $0.0144 für die Hits, 0,6 × $0.30 = $0.18 für die Misses und dieselben $0.24 für Output, $0.0144 + $0.18 + $0.24 = $0.4344.
Der Cache hat den Input von $0.90 auf $0.1944 gesenkt und den Output zur größten Position auf der Rechnung gemacht. Das ist das Muster bei Agenten: Sobald das Präfix gecacht ist, kosten die Antworten mehr als das Lesen. Halten Sie den Anfang Ihres Prompts von Schritt zu Schritt identisch und stellen Sie das, was sich ändert, ans Ende.
Passen Sie die Zahlen an Ihre eigene Schleife an:
Kostenrechner
Ein Coding-Agent: 100 Schritte
Eingabe-Tokens pro Anfrage: 30.000 · Ausgabe-Tokens pro Anfrage: 2.000 · Anfragen pro Tag: 100
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
Der Rechner verwendet Live-Preise, er ändert sich also mit der Preisliste. Die offiziellen Zahlen oben gelten weiterhin Stand 29. Oktober 2026.
Welches Setup zu Ihrer Aufgabe passt#
Wähle deinen Fall
Wählen Sie die nächstliegende Aufgabe
Wähle eine Option, um die Antwort zu sehen
Support-Bot, Traffic den ganzen Tag
Traffic wartet nicht auf die Zeit außerhalb der Stoßzeiten. Offiziell ist deepseek-flash zu Stoßzeiten die Zahl, mit der Sie planen sollten: $0.30 Input und $1.20 Output pro 1M Tokens. Ein einheitlicher Preis zu jeder Stunde, wie DeepSeek-V4-Flash auf CheapTokens, macht die Monatsrechnung leicht vorhersagbar.
Nächtlicher Batch-Job
Verschieben Sie den Zeitplan außerhalb von 01:00–04:00 und 06:00–10:00 UTC, und es gilt der offizielle Preis außerhalb der Stoßzeiten, also die Hälfte der Stoßzeit. Wenn der Job nicht verschoben werden kann, ist der Stoßzeitenpreis der echte.
Agent mit einem großen wiederholten Prompt
Halten Sie das Prompt-Präfix stabil, damit die Cache-Hit-Rate hoch bleibt, und rechnen Sie damit, dass Output zum größten Teil der Rechnung wird. Ein Pauschalpreis ohne Stoßzeitenfenster macht eine solche Schleife leicht zu budgetieren.
Flash reicht nicht aus
Testen Sie deepseek-v4-pro zuerst an einer Stichprobe Ihrer eigenen Aufgaben. Sein Cache-Miss-Input kostet zu Stoßzeiten $1.32 und sein Output $3.96, er sollte diesen Preis also mit Ihren Daten verdienen.
Dieselben Lasten auf CheapTokens#
Für den Support-Bot und die Agent-Schleife hat CheapTokens DeepSeek-V4-Flash: id deepseek-, 380K Kontext, bis zu 32.768 Output-Tokens pro Antwort. Es ist ein Preis zu jeder Stunde, ohne Stoßzeitenfenster, ein Guthaben für alle Modelle und eine OpenAI- und Anthropic-kompatible API unter https:/. Insgesamt, mit Input und Output zusammengerechnet, ist es günstiger als OpenRouter.
Eine Support-Bot-Anfrage (1.500 Input, 400 Output) kostet $0.000063. Der 100-Schritte-Agent-Lauf oben (3M Input, 0,2M Output) kostet $0.065. Die Tabelle unten zeigt den Tag des Bots, 1.000 Anfragen, über alle unsere Modelle mit der OpenRouter-Spalte daneben; stellen Sie sie neben die offiziellen Zahlen oben:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
1.500 Input- und 400 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
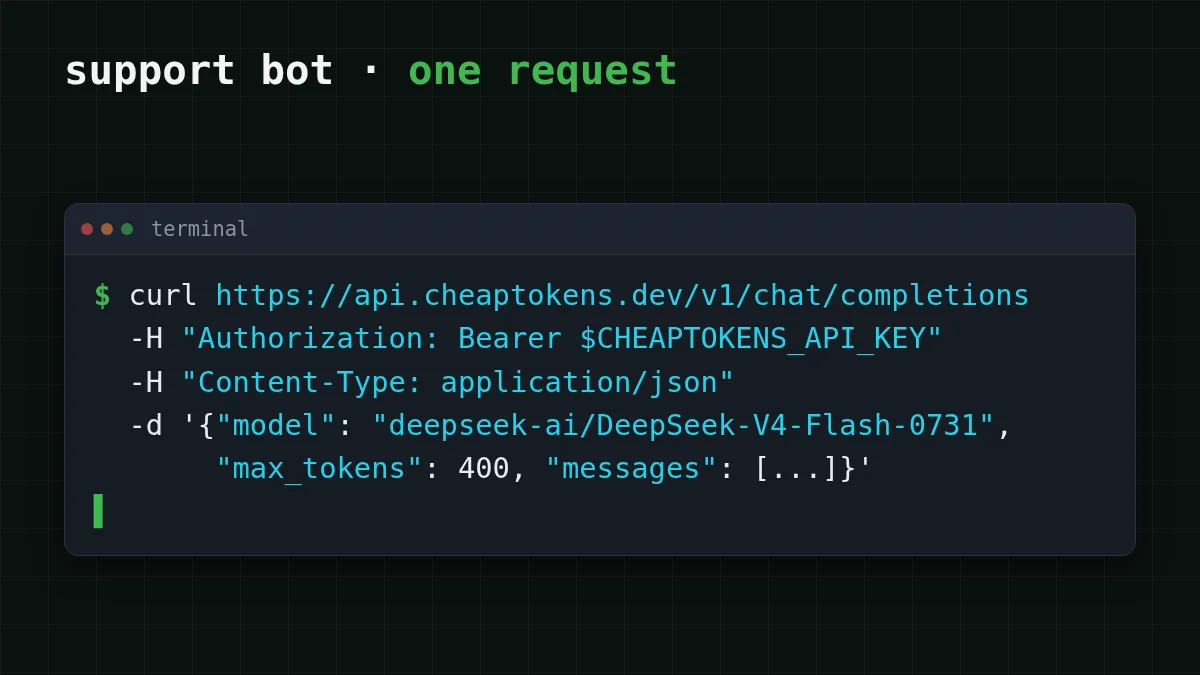
Um die Anfrage des Bots selbst zu senden (verwenden Sie die id genau wie geschrieben; kurze ids aus Preisangaben werden nicht akzeptiert):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
Die Antwort enthält einen usage-Block mit den tatsächlichen Input- und Output-Token-Zahlen. Multiplizieren Sie sie mit den Live-Preisen oder fügen Sie sie in die Tabelle oben ein, und Sie haben die Kosten Ihrer eigenen Anfrage statt einer Schätzung.
Die Verbindungsdetails finden Sie in den CheapTokens-Docs, auf der DeepSeek-Seite und in der Live-Preistabelle. Wenn Sie DeepSeek gegen eine andere Familie abwägen, stellt MiniMax-M2.7 vs DeepSeek-V4-Flash sie bei denselben Aufgaben nebeneinander.


