Model & perbandinganPerbandingan
Model API DeepSeek termurah pada 2026: deepseek-flash vs Pro
Harga API DeepSeek resmi diperiksa 29 Okt 2026: Flash vs Pro, jam sibuk vs luar jam sibuk, cache hit, dan berapa biaya sebenarnya untuk bot dukungan dan agen.
Di halaman ini
Tagihan DeepSeek Anda bergantung pada tiga hal yang tidak ditunjukkan oleh harga per token: model mana yang Anda panggil, jam berapa Anda memanggilnya, dan seberapa banyak prompt Anda yang diingat oleh cache. Jawaban singkatnya: dari dua model resmi, deepseek-flash adalah yang lebih murah di setiap kolom. Di luar jam sibuk biayanya $0,15 per 1 juta token input (cache miss) dan $0,60 per 1 juta token output. Pada jam sibuk, keduanya menjadi dua kali lipat.
Harga di bawah ini berasal dari halaman harga DeepSeek, diambil pada 29 Oktober 2026. Halaman tersebut tidak mencantumkan tanggal publikasi, jadi anggap tanggal pengambilan sebagai tanggal harga.
Dua model resmi, satu penggantian nama#
API resmi menjual dua model: deepseek-flash, dilayani oleh DeepSeek-V4.1-Flash-1017, dan deepseek-v4-pro, dilayani oleh DeepSeek-V4-Pro-0813. Keduanya mencantumkan konteks 1 juta dan hingga 384 ribu token output.
Jika kode Anda masih menyebut deepseek- atau deepseek-, tidak ada yang rusak. Catatan rilis 17 Oktober 2026 DeepSeek menyatakan model tersebut sudah pensiun dan namanya sekarang dialihkan ke DeepSeek-V4.1-Flash-1017 dengan harga Flash. Apa yang berubah di dalam model dibahas dalam tulisan tentang rilis tersebut.
Berikut harga per 1 juta token, dalam USD:
Gulir tabel ke kanan →
| Per 1 juta token | Flash, luar jam sibuk | Flash, jam sibuk | Pro, luar jam sibuk | Pro, jam sibuk |
|---|---|---|---|---|
| Input, cache hit | $0,003 | $0,006 | $0,022 | $0,044 |
| Input, cache miss | $0,15 | $0,30 | $0,66 | $1,32 |
| Output | $0,60 | $1,20 | $1,98 | $3,96 |
"Cache hit" berarti DeepSeek mengenali awal prompt Anda dari permintaan sebelumnya dan menagih bagian itu dengan tarif murah. Penjelasan prompt caching membahas mekanismenya. Segala sesuatu yang bukan hit adalah miss.
Jam sibuk: permintaan sama, harga dua kali lipat#
Jam sibuk adalah 01.00–04.00 dan 06.00–10.00 UTC, Senin hingga Jumat, kecuali hari libur nasional Tiongkok. Di luar jendela tersebut Anda membayar harga luar jam sibuk, yaitu setengahnya.
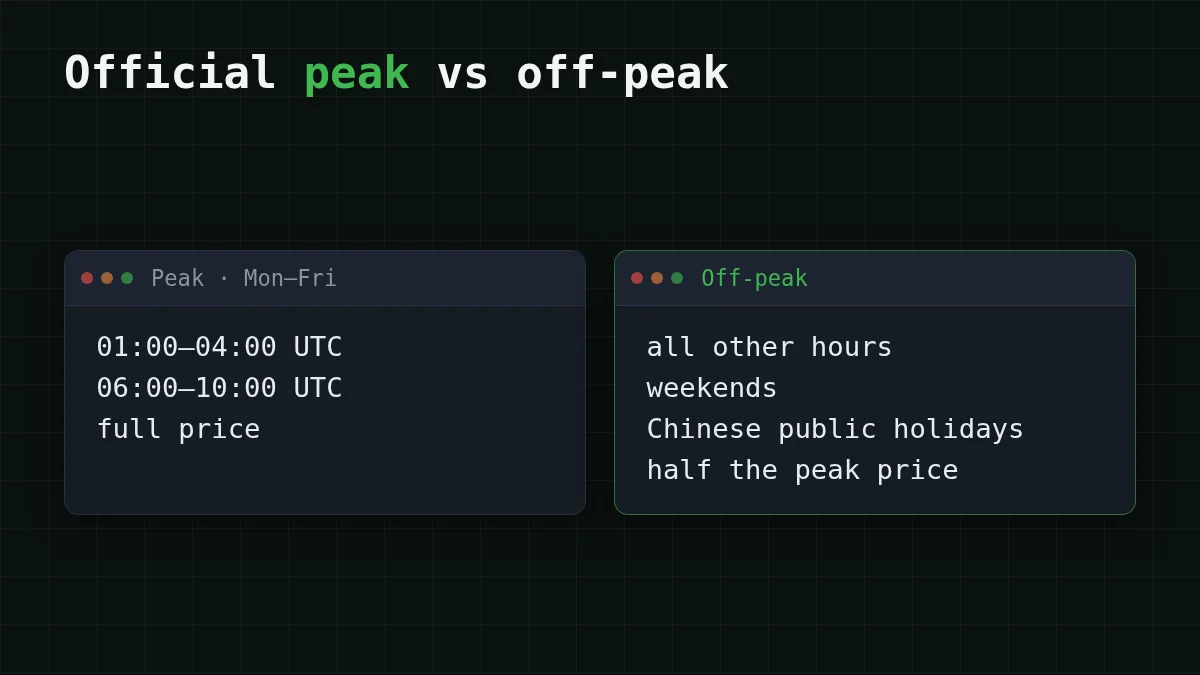
Tujuh jam sehari terdengar sedikit. Memang: 7 × 5 = 35 dari 168 jam dalam seminggu, sekitar seperlima. Tetapi jendela tersebut mencakup sebagian besar hari kerja Beijing dan pagi hari Eropa, jadi bot yang berbicara dengan orang di zona waktu tersebut hidup di dalamnya. Pekerjaan yang berjalan pada 22.00 UTC tidak pernah melihat harga jam sibuk.
Tebak angkanya
Berapa jam dalam hari kerja yang masuk dalam jendela jam sibuk resmi?
Tebakan Anda
024
Tampilkan jawaban
Jawaban: 7
Tujuh: 01.00–04.00 adalah 3 jam dan 06.00–10.00 adalah 4 jam, dan 3 + 4 = 7.
Bot dukungan: 1.000 permintaan sehari#
Katakanlah Anda menjalankan bot dukungan. Setiap permintaan membawa sekitar 1.500 token input (instruksi plus pesan pelanggan) dan mengembalikan sekitar 400 token. Itu berarti 1,5 juta input dan 0,4 juta token output sehari, dan untuk kesederhanaan tidak ada yang kena cache.
Pada deepseek-flash di jam sibuk, input adalah 1,5 × $0,30 = $0,45. Output adalah 0,4 × $1,20 = $0,48. Sehari menjadi $0,45 + $0,48 = $0,93. Di luar jam sibuk, input adalah 1,5 × $0,15 = $0,225 dan output adalah 0,4 × $0,60 = $0,24, jadi sehari adalah $0,225 + $0,24 = $0,465.
Pada deepseek-v4-pro di jam sibuk, input adalah 1,5 × $1,32 = $1,98. Output adalah 0,4 × $3,96 = $1,584. Sehari menjadi $1,98 + $1,584 = $3,564.
Perhatikan ke mana uangnya pergi. Pada Flash, jawaban 400 token sedikit lebih mahal daripada prompt 1.500 token, karena output adalah sisi yang mahal. Dan Pro adalah model yang Anda pilih setelah pengujian pada tiket Anda sendiri menunjukkan jawaban Flash kurang memadai, bukan sebelumnya: pengujian itu bernilai $3,564 sehari pada jam sibuk.
Loop agen: di mana cache membayar#
Agen coding adalah kebalikan dari chatbot. Setiap langkah mengirim ulang prefiks besar yang sama: instruksi, definisi alat, file yang sudah dibaca. Katakanlah satu proses adalah 100 langkah dengan 30.000 token input dan 2.000 token output masing-masing, dan 80% dari setiap prompt adalah prefiks berulang tersebut. Itu berarti 3 juta token input (2,4 juta hit, 0,6 juta miss) dan 0,2 juta token output.
Pada deepseek-flash di jam sibuk, tanpa cache sama sekali: 3 × $0,30 = $0,90 untuk input plus 0,2 × $1,20 = $0,24 untuk output, $0,90 + $0,24 = $1,14.
Dengan tingkat hit 80%: 2,4 × $0,006 = $0,0144 untuk hit, 0,6 × $0,30 = $0,18 untuk miss, dan $0,24 yang sama untuk output, $0,0144 + $0,18 + $0,24 = $0,4344.
Cache menurunkan input dari $0,90 menjadi $0,1944 dan menjadikan output sebagai baris terbesar dalam tagihan. Itulah pola pada agen: setelah prefiks di-cache, jawaban lebih mahal daripada pembacaan. Jaga awal prompt Anda tetap identik dari langkah ke langkah, dan letakkan yang berubah di akhir.
Ubah angka sesuai loop Anda sendiri:
Kalkulator biaya
Agen coding: 100 langkah
Token input per permintaan: 30.000 · Token output per permintaan: 2.000 · Permintaan per hari: 100
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
Kalkulator menggunakan harga langsung, jadi ikut berubah saat daftar harga berubah. Angka resmi di atas tetap per 29 Oktober 2026.
Pengaturan mana yang cocok untuk pekerjaan Anda#
Pilih kasus Anda
Pilih pekerjaan yang paling mendekati
Pilih opsi untuk melihat jawabannya
Bot dukungan, lalu lintas sepanjang hari
Lalu lintas tidak menunggu luar jam sibuk. Secara resmi, deepseek-flash pada jam sibuk adalah angka yang harus direncanakan: $0,30 input dan $1,20 output per 1 juta token. Satu harga di setiap jam, seperti DeepSeek-V4-Flash di CheapTokens, membuat tagihan bulanan mudah diprediksi.
Pekerjaan batch semalam
Pindahkan jadwal ke luar 01.00–04.00 dan 06.00–10.00 UTC dan harga resmi luar jam sibuk berlaku, setengah dari jam sibuk. Jika pekerjaan tidak bisa dipindahkan, harga jam sibuk adalah yang sebenarnya.
Agen dengan prompt berulang besar
Jaga prefiks prompt tetap stabil agar tingkat cache hit tetap tinggi, dan perkirakan output menjadi bagian terbesar dari tagihan. Harga tetap tanpa jendela jam sibuk membuat loop seperti ini mudah dianggarkan.
Flash tidak cukup baik
Uji deepseek-v4-pro pada sampel tugas Anda sendiri terlebih dahulu. Input cache-miss-nya $1,32 pada jam sibuk dan outputnya $3,96, jadi model itu harus membuktikan nilainya pada data Anda.
Beban yang sama di CheapTokens#
Untuk bot dukungan dan loop agen, CheapTokens memiliki DeepSeek-V4-Flash: id deepseek-, konteks 380 ribu, hingga 32.768 token output per jawaban. Harganya satu di jam berapa pun, tanpa jendela jam sibuk, satu saldo untuk semua model, dan API yang kompatibel dengan OpenAI dan Anthropic di https:/. Secara total, dengan input dan output dihitung bersama, ini lebih murah daripada OpenRouter.
Satu permintaan bot dukungan (1.500 input, 400 output) berbiaya $0.000063. Proses agen 100 langkah di atas (3 juta input, 0,2 juta output) berbiaya $0.065. Tabel di bawah adalah hari bot, 1.000 permintaan, di semua model kami dengan kolom OpenRouter di sebelahnya; bandingkan dengan angka resmi di atas:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
1.500 token input dan 400 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
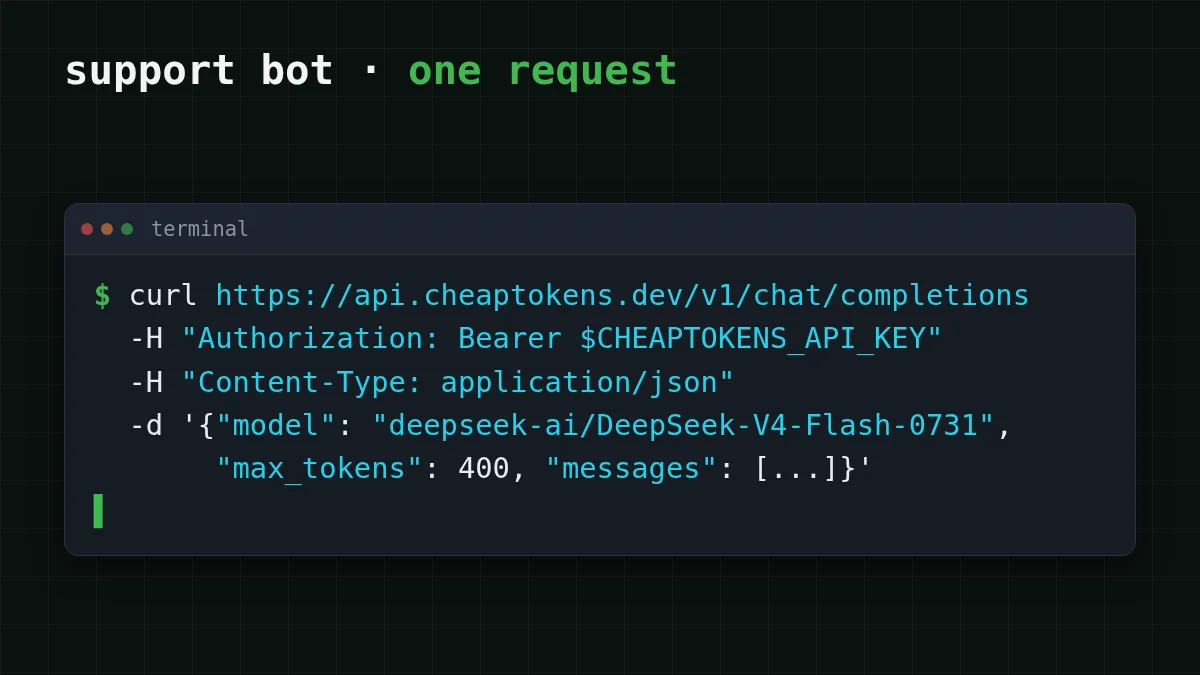
Untuk mengirim permintaan bot sendiri (gunakan id persis seperti tertulis; id pendek dari label harga tidak diterima):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
Respons memiliki blok usage dengan jumlah token input dan output sebenarnya. Kalikan dengan harga langsung, atau tempel ke tabel di atas, dan Anda mendapatkan biaya permintaan Anda sendiri alih-alih perkiraan.
Untuk detail koneksi lihat dokumentasi CheapTokens, halaman DeepSeek dan tabel harga langsung. Jika Anda mempertimbangkan DeepSeek terhadap keluarga lain, MiniMax-M2.7 vs DeepSeek-V4-Flash menempatkan keduanya berdampingan pada tugas yang sama.


