Mga modelo at paghahambingPaghahambing
Pinakamurang DeepSeek API model sa 2026: deepseek-flash vs Pro
Mga opisyal na presyo ng DeepSeek API na sinuri noong 29 Okt 2026: Flash vs Pro, peak vs off-peak, cache hits, at ang tunay na gastos ng support bot at agent.
Sa pahinang ito
Ang bill mo sa DeepSeek ay nakadepende sa tatlong bagay na hindi ipinapakita ng presyo kada token: kung aling modelo ang tinatawag mo, anong oras mo ito tinatawag, at gaano karami sa prompt mo ang natatandaan ng cache. Ang maikling sagot: sa dalawang opisyal na modelo, ang deepseek-flash ang mas mura sa lahat ng kolum. Off-peak, nagkakahalaga ito ng $0.15 kada 1M input tokens (cache miss) at $0.60 kada 1M output tokens. Sa peak, dumodoble ang dalawa.
Ang mga presyo sa ibaba ay galing sa pricing page ng DeepSeek, na kinuha noong 29 Oktubre 2026. Walang petsa ng publikasyon ang page, kaya ituring na petsa ng presyo ang petsa ng pagkuha.
Dalawang opisyal na modelo, isang rename#
Dalawang modelo ang ibinebenta ng opisyal na API: ang deepseek-flash, na ine-serve ng DeepSeek-V4.1-Flash-1017, at ang deepseek-v4-pro, na ine-serve ng DeepSeek-V4-Pro-0813. Pareho silang may 1M context at hanggang 384K tokens na output.
Kung ang code mo ay may deepseek- o deepseek- pa rin, walang masisira. Ayon sa release note ng DeepSeek noong 17 Oktubre 2026, retired na ang mga modelong iyon at ang mga pangalan nila ay naka-route na sa DeepSeek-V4.1-Flash-1017 sa presyo ng Flash. Ang mga nagbago sa loob ng modelo ay saklaw ng write-up ng release.
Narito ang mga presyo kada 1M tokens, sa USD:
I-scroll ang table pakanan →
| Kada 1M tokens | Flash, off-peak | Flash, peak | Pro, off-peak | Pro, peak |
|---|---|---|---|---|
| Input, cache hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Input, cache miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Output | $0.60 | $1.20 | $1.98 | $3.96 |
Ang "cache hit" ay nangangahulugang nakikilala ng DeepSeek ang simula ng prompt mo mula sa naunang request at sinisingil ang bahaging iyon sa murang rate. Nasa Prompt caching explained ang mekaniks. Lahat ng hindi hit ay miss.
Peak hours: parehong request, doble ang presyo#
Ang peak ay 01:00–04:00 at 06:00–10:00 UTC, Lunes hanggang Biyernes, maliban sa mga pampublikong holiday ng China. Sa labas ng mga window na iyon, binabayaran mo ang off-peak na presyo, na kalahati.
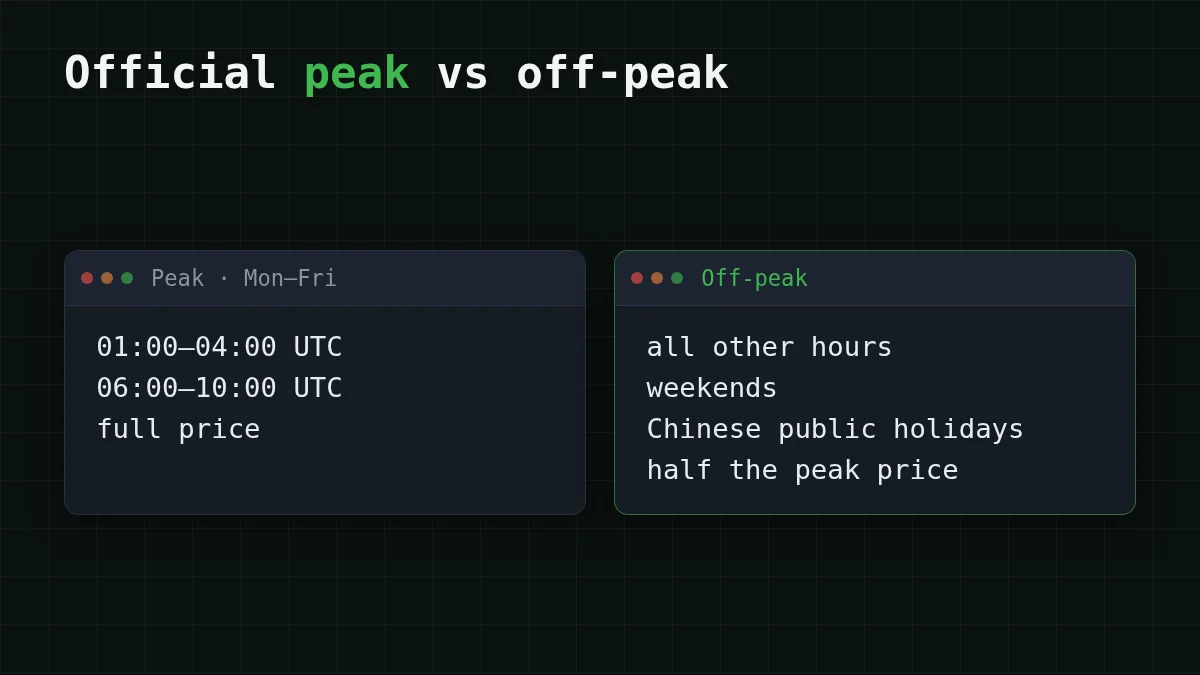
Pitong oras kada araw ay mukhang kaunti. Totoo iyon: 7 × 5 = 35 sa 168 oras ng linggo, mga isang-kalima. Pero sakop ng mga window na iyon ang karamihan ng araw ng trabaho sa Beijing at ang umaga sa Europa, kaya ang bot na nakikipag-usap sa mga tao sa mga time zone na iyon ay nasa loob nito. Ang job na tumatakbo sa 22:00 UTC ay hindi kailanman nakakakita ng peak pricing.
Hulaan ang numero
Ilang oras ng isang weekday ang nasa loob ng opisyal na peak windows?
Ang iyong hula
024
Ipakita ang sagot
Sagot: 7
Pito: ang 01:00–04:00 ay 3 oras at ang 06:00–10:00 ay 4 na oras, at 3 + 4 = 7.
Isang support bot: 1,000 request kada araw#
Sabihin nating may support bot ka. Bawat request ay may mga 1,500 input tokens (ang mga instruksyon at ang mensahe ng customer) at nakakakuha ng mga 400 tokens pabalik. Iyon ay 1.5M input at 0.4M output tokens kada araw, at para sa simplehan, wala sa mga ito ang tumatama sa cache.
Sa deepseek-flash sa peak, ang input ay 1.5 × $0.30 = $0.45. Ang output ay 0.4 × $1.20 = $0.48. Ang isang araw ay umaabot sa $0.45 + $0.48 = $0.93. Off-peak, ang input ay 1.5 × $0.15 = $0.225 at ang output ay 0.4 × $0.60 = $0.24, kaya ang isang araw ay $0.225 + $0.24 = $0.465.
Sa deepseek-v4-pro sa peak, ang input ay 1.5 × $1.32 = $1.98. Ang output ay 0.4 × $3.96 = $1.584. Ang isang araw ay umaabot sa $1.98 + $1.584 = $3.564.
Tingnan kung saan napupunta ang pera. Sa Flash, ang 400-token na mga sagot ay mas mahal nang bahagya kaysa sa 1,500-token na mga prompt, dahil ang output ang mahal na bahagi. At ang Pro ang pipiliin mo pagkatapos ng test sa sarili mong mga ticket na nagpapakita na kulang ang mga sagot ng Flash, hindi bago iyon: ang test na iyon ay nagkakahalaga ng $3.564 kada araw sa peak.
Isang agent loop: kung saan nagbabayad ang cache#
Ang coding agent ay kabaligtaran ng chatbot. Bawat hakbang ay muling ipinapadala ang parehong malaking prefix: mga instruksyon, tool definitions, ang mga file na nabasa na. Sabihin nating ang isang run ay 100 hakbang na may 30,000 input tokens at 2,000 output tokens bawat isa, at 80% ng bawat prompt ay ang paulit-ulit na prefix. Iyon ay 3M input tokens (2.4M hits, 0.6M misses) at 0.2M output tokens.
Sa deepseek-flash sa peak, na walang cache: 3 × $0.30 = $0.90 para sa input at 0.2 × $1.20 = $0.24 para sa output, $0.90 + $0.24 = $1.14.
Sa 80% hit rate: 2.4 × $0.006 = $0.0144 para sa mga hit, 0.6 × $0.30 = $0.18 para sa mga miss, at parehong $0.24 para sa output, $0.0144 + $0.18 + $0.24 = $0.4344.
Inilipat ng cache ang input mula $0.90 papuntang $0.1944 at ginawang output ang pinakamalaking linya sa bill. Iyon ang pattern sa mga agent: kapag naka-cache na ang prefix, mas mahal ang mga sagot kaysa sa pagbasa. Panatilihing pareho ang simula ng prompt mo sa bawat hakbang, at ilagay sa dulo ang nagbabago.
Palitan ang mga numero ng sarili mong loop:
Calculator ng gastos
Isang coding agent: 100 hakbang
Mga input token bawat kahilingan: 30,000 · Mga output token bawat kahilingan: 2,000 · Mga kahilingan bawat araw: 100
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
Gumagamit ang calculator ng live na presyo, kaya nagbabago ito kapag nagbago ang price list. Ang mga opisyal na numero sa itaas ay nananatiling ayon sa 29 Oktubre 2026.
Aling setup ang bagay sa trabaho mo#
Piliin ang iyong kaso
Piliin ang pinakamalapit na trabaho
Pumili ng opsyon upang makita ang sagot
Support bot, trapiko buong araw
Hindi naghihintay ang trapiko sa off-peak. Sa opisyal, ang deepseek-flash sa peak ang numero na dapat gamitin sa pagpaplano: $0.30 input at $1.20 output kada 1M tokens. Ang isang presyo sa lahat ng oras, tulad ng DeepSeek-V4-Flash sa CheapTokens, ay nagpapadali sa paghula ng buwanang bill.
Overnight batch job
Ilipat ang schedule sa labas ng 01:00–04:00 at 06:00–10:00 UTC at ang opisyal na off-peak na presyo ang gagamitin, kalahati ng peak. Kung hindi mailipat ang job, ang peak na presyo ang totoo.
Agent na may malaking paulit-ulit na prompt
Panatilihing stable ang prompt prefix para manatiling mataas ang cache hit rate, at asahan na ang output ang magiging pinakamalaking bahagi ng bill. Ang flat na presyo na walang peak windows ay nagpapadali sa pag-budget ng loop na tulad nito.
Hindi sapat ang Flash
Subukan muna ang deepseek-v4-pro sa sample ng sarili mong mga task. Ang cache-miss input nito ay $1.32 sa peak at ang output ay $3.96, kaya dapat itong makabawi ng presyong iyon sa data mo.
Ang parehong load sa CheapTokens#
Para sa support bot at agent loop, may DeepSeek-V4-Flash ang CheapTokens: id deepseek-, 380K context, hanggang 32,768 output tokens kada sagot. Isang presyo ito sa kahit anong oras, walang peak windows, isang balance para sa lahat ng modelo, at OpenAI- at Anthropic-compatible na API sa https:/. Sa kabuuan, kapag pinagsama ang input at output, mas mura ito kaysa sa OpenRouter.
Ang isang support-bot request (1,500 in, 400 out) ay nagkakahalaga ng $0.000063. Ang 100-hakbang na agent run sa itaas (3M in, 0.2M out) ay nagkakahalaga ng $0.065. Ang table sa ibaba ay ang araw ng bot, 1,000 request, sa lahat ng modelo namin kasama ang OpenRouter column sa tabi nila; ihambing ito sa mga opisyal na numero sa itaas:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
1,500 input at 400 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
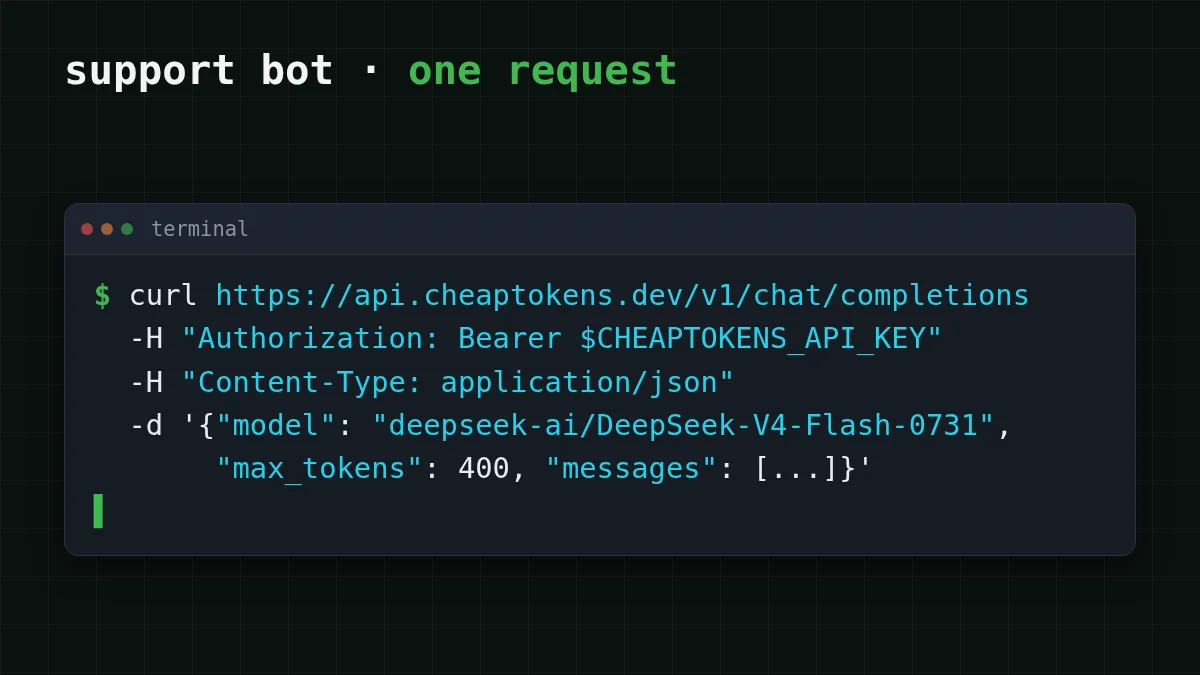
Para ipadala mismo ang request ng bot (gamitin ang id nang eksakto kung paano ito nakasulat; hindi tinatanggap ang maiikling id mula sa price labels):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
Ang response ay may usage block na may totoong bilang ng input at output tokens. I-multiply ang mga ito sa live na presyo, o i-paste sa table sa itaas, at mayroon ka nang halaga ng sarili mong request sa halip na hula.
Para sa mga detalye ng koneksyon, tingnan ang CheapTokens docs, ang DeepSeek page at ang live na pricing table. Kung pinaghahambing mo ang DeepSeek sa ibang pamilya, inilalagay sila ng MiniMax-M2.7 vs DeepSeek-V4-Flash nang magkatabi sa parehong mga task.


