模型与对比对比
2026 年最便宜的 DeepSeek API 模型:deepseek-flash vs Pro
2026 年 10 月 29 日核实的官方 DeepSeek API 价格:Flash vs Pro、高峰 vs 非高峰、缓存命中,以及支持机器人和智能体的真实成本。
你的 DeepSeek 账单取决于每 token 价格没有体现的三件事:你调用哪个模型、你在哪个时段调用,以及缓存记住了你提示词中的多少内容。简短回答:在两个官方模型中,deepseek-flash 在每一列上都更便宜。非高峰时段,每 1M 输入 token 花费 $0.15(缓存未命中),每 1M 输出 token 花费 $0.60。高峰时段,两者都翻倍。
以下价格来自 DeepSeek 的定价页面,抓取于 2026 年 10 月 29 日。该页面没有发布日期,因此请将抓取日期视为价格日期。
两个官方模型,一次重命名#
官方 API 销售两个模型:deepseek-flash,由 DeepSeek-V4.1-Flash-1017 提供服务;以及 deepseek-v4-pro,由 DeepSeek-V4-Pro-0813 提供服务。两者都列出 1M 上下文和最多 384K token 的输出。
如果你的代码仍然写着 deepseek- 或 deepseek-,不会出问题。DeepSeek 的 2026 年 10 月 17 日发布说明 表示这些模型已退役,它们的名称现在以 Flash 价格路由到 DeepSeek-V4.1-Flash-1017。模型内部的变化在该发布的文章中介绍。
以下是每 1M token 的价格,单位为美元:
向右滚动表格 →
| 每 1M token | Flash,非高峰 | Flash,高峰 | Pro,非高峰 | Pro,高峰 |
|---|---|---|---|---|
| 输入,缓存命中 | $0.003 | $0.006 | $0.022 | $0.044 |
| 输入,缓存未命中 | $0.15 | $0.30 | $0.66 | $1.32 |
| 输出 | $0.60 | $1.20 | $1.98 | $3.96 |
“缓存命中”是指 DeepSeek 从先前的请求中识别出你提示词的开头,并按便宜费率对该部分计费。提示词缓存详解介绍了其机制。所有不是命中的都算未命中。
高峰时段:同样的请求,价格翻倍#
高峰时段为 UTC 周一至周五 01:00–04:00 和 06:00–10:00,中国法定节假日除外。在这些时间窗口之外,你支付非高峰价格,即一半。
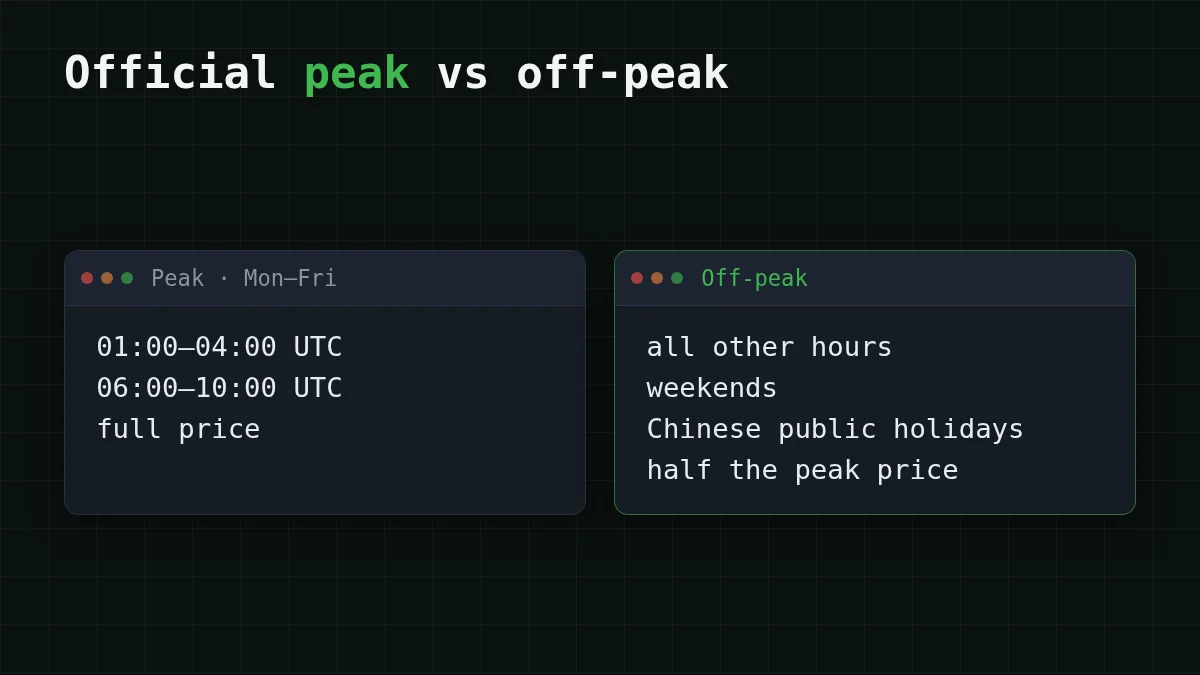
每天七小时听起来很少。确实如此:7 × 5 = 一周 168 小时中的 35 小时,约五分之一。但这些窗口覆盖了北京工作日的绝大部分和欧洲的上午,因此与这些时区的人交流的机器人就处在这些窗口内。在 UTC 22:00 运行的作业永远不会遇到高峰定价。
猜数字
工作日有多少小时落在官方高峰窗口内?
你的猜测
024
显示答案
答案: 7
七小时:01:00–04:00 是 3 小时,06:00–10:00 是 4 小时,3 + 4 = 7。
一个支持机器人:每天 1,000 次请求#
假设你运行一个支持机器人。每个请求携带约 1,500 个输入 token(指令加上客户的消息),并返回约 400 个 token。即每天 1.5M 输入和 0.4M 输出 token,为简单起见,假设没有命中缓存。
在高峰时段的 deepseek-flash 上,输入为 1.5 × $0.30 = $0.45。输出为 0.4 × $1.20 = $0.48。一天合计 $0.45 + $0.48 = $0.93。非高峰时段,输入为 1.5 × $0.15 = $0.225,输出为 0.4 × $0.60 = $0.24,因此一天为 $0.225 + $0.24 = $0.465。
在高峰时段的 deepseek-v4-pro 上,输入为 1.5 × $1.32 = $1.98。输出为 0.4 × $3.96 = $1.584。一天合计 $1.98 + $1.584 = $3.564。
看看钱花在哪里。在 Flash 上,400 token 的回答比 1,500 token 的提示词略贵,因为输出是昂贵的一侧。而 Pro 是你先在自己的工单上测试、发现 Flash 的回答不够好之后才选择的模型,而不是之前:那次测试在高峰时段每天价值 $3.564。
一个智能体循环:缓存发挥作用的地方#
编码智能体与聊天机器人相反。每一步都会重新发送相同的大前缀:指令、工具定义、它已经读过的文件。假设一次运行有 100 步,每步 30,000 个输入 token 和 2,000 个输出 token,且每个提示词的 80% 是那个重复的前缀。即 3M 输入 token(2.4M 命中,0.6M 未命中)和 0.2M 输出 token。
在高峰时段的 deepseek-flash 上,完全不用缓存:输入 3 × $0.30 = $0.90,加上输出 0.2 × $1.20 = $0.24,$0.90 + $0.24 = $1.14。
在 80% 命中率下:命中为 2.4 × $0.006 = $0.0144,未命中为 0.6 × $0.30 = $0.18,输出同样是 $0.24,$0.0144 + $0.18 + $0.24 = $0.4344。
缓存将输入从 $0.90 降到 $0.1944,并使输出成为账单上最大的一项。这就是智能体的模式:一旦前缀被缓存,回答的成本就高于读取。让你的提示词开头在每一步之间保持相同,并把变化的内容放在末尾。
把数字换成你自己的循环:
成本计算器
一个编码智能体:100 步
每次请求的输入 token 数: 30,000 · 每次请求的输出 token 数: 2,000 · 每日请求数: 100
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.068 | $2.04 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.065 | $1.95 |
| MiniMax-M2.7$0.05$0.15 | $0.18 | $5.40 |
计算器使用实时价格,因此它会随价格表变动。上述官方数字截至 2026 年 10 月 29 日。
哪种方案适合你的工作#
选择你的情况
选择最接近的工作
选择一个选项以查看答案
支持机器人,全天流量
流量不会等待非高峰。官方上,高峰时段的 deepseek-flash 是规划时应采用的数字:每 1M token 输入 $0.30、输出 $1.20。每个小时都统一的价格,比如 CheapTokens 上的 DeepSeek-V4-Flash,让月度账单易于预测。
夜间批处理作业
将计划移出 UTC 01:00–04:00 和 06:00–10:00,官方非高峰价格就适用,即高峰的一半。如果作业无法移动,高峰价格就是真实价格。
带有大量重复提示词的智能体
保持提示词前缀稳定,使缓存命中率保持高位,并预期输出会成为账单中最大的部分。没有高峰窗口的固定价格让这样的循环易于预算。
Flash 不够好
先在你自己的任务样本上测试 deepseek-v4-pro。其缓存未命中输入在高峰时为 $1.32,输出为 $3.96,因此它应该在你的数据上值这个价。
在 CheapTokens 上的相同负载#
对于支持机器人和智能体循环,CheapTokens 有 DeepSeek-V4-Flash:id 为 deepseek-,380K 上下文,每次回答最多 32,768 个输出 token。它在任何时段都是统一价格,没有高峰窗口,所有模型共用一个余额,并在 https:/ 提供 OpenAI 和 Anthropic 兼容的 API。总体而言,将输入和输出合计计算,它比 OpenRouter 更便宜。
一次支持机器人请求(1,500 输入,400 输出)花费 $0.000063。上述 100 步智能体运行(3M 输入,0.2M 输出)花费 $0.065。下表是机器人的一天,1,000 次请求,涵盖我们所有模型,旁边是 OpenRouter 列;将其与上面的官方数字并排比较:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.046 | $0.0923 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0625 | $0.134 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.135 | $0.93 |
每次请求 1,500 个输入 token 和 400 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
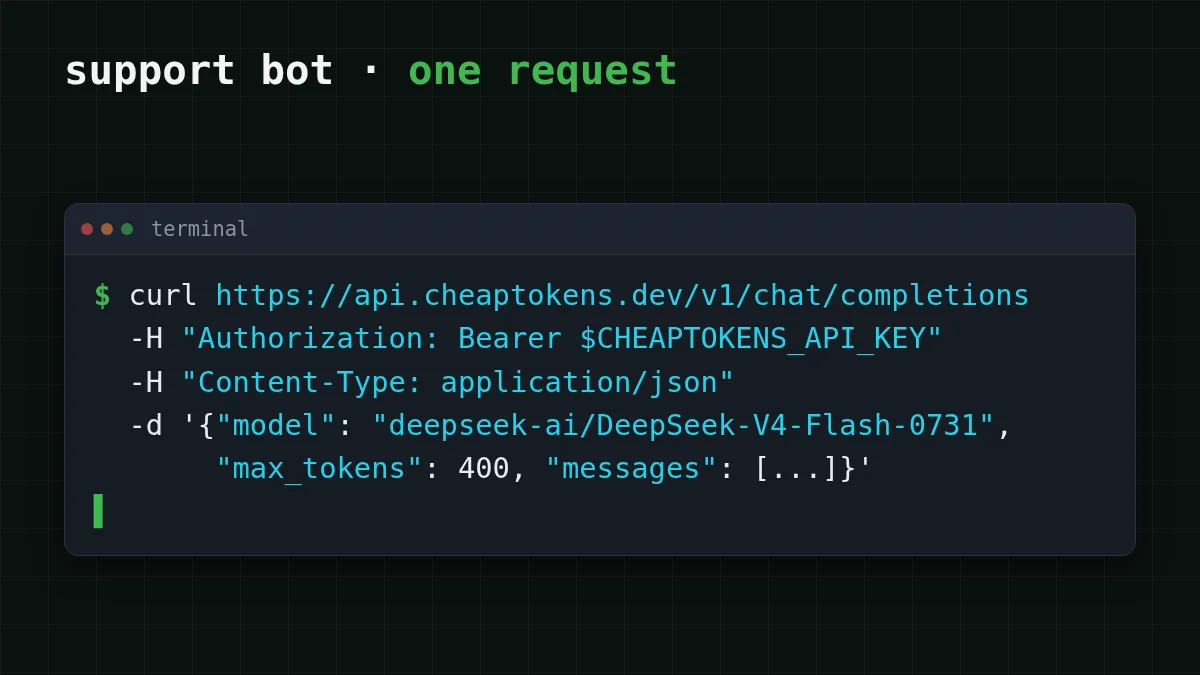
要自己发送机器人的请求(完全按所写使用 id;不接受价格标签中的短 id):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "max_tokens": 400,
    "messages": [{"role": "user", "content": "Where is my order #1042?"}]
  }'
响应中有一个 usage 块,包含真实的输入和输出 token 计数。将它们乘以实时价格,或粘贴到上表中,你就能得到自己请求的成本,而不是猜测。
有关连接详情,请参阅 CheapTokens 文档、DeepSeek 页面和实时定价表。如果你正在权衡 DeepSeek 与另一个系列,MiniMax-M2.7 vs DeepSeek-V4-Flash 在相同任务上将它们并排比较。


