模型与对比对比
2026 年最便宜的 Gemini API 模型:Flash-Lite 价格对比
哪个 Gemini 模型的付费价格最低,哪些有免费额度,12 月 1 日和 1 月 1 日什么会翻倍,以及 1,000 次请求与 CheapTokens 模型相比要花多少钱。
你想要最便宜的 Gemini 模型,而 Google 的价格表行数多得让人没耐心看。这里是简短版本。在 Gemini API 定价页面(2026 年 10 月 27 日更新,10 月 29 日核对)上,Gemini 2.5 Flash-Lite(gemini-)的付费文本价格最低:每 1M 输入 token 为 $0.10,每 1M 输出 token 为 $0.40。它也有免费额度,和 Gemini 3.1 Flash-Lite、Gemini 3.5 Flash-Lite 以及 Gemini 2.5 Flash 一样。而且页面上已经列出两次涨价:Gemini 4 Argon 在 2026 年 12 月 1 日翻倍,Gemini 3.8 Flash 和 3.6 Flash 在 2027 年 1 月 1 日翻倍。
下面:价格并排对比、什么会变以及何时变,还有 1,000 次普通请求在 Gemini 上要花多少钱,对比你可以通过 CheapTokens 调用的模型。关于计费的精确机制,输入 vs 输出 token 是简短说明。
今天的 Gemini 价格,每 1M token#
这些是 Google 定价页面 上的标准付费层文本价格,截至 2026 年 10 月 29 日。
向右滚动表格 →
| 模型 | 输入 | 输出 | 免费额度 |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | 有 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | 有 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 有 |
| Gemini 2.5 Flash | $0.30 | $2.50 | 有 |
| Gemini 4 Argon | $2.00 | $10.00 | 无 |
脚注里藏着几件事。Flash-Lite 模型的音频输入更贵(2.5 Flash-Lite 为 $0.30,3.1 Flash-Lite 为 $0.50),所以语音流水线不会符合这张表。Batch API 打五折,但它是异步的:你提交任务,稍后收集结果,所以适合过夜任务,不适合聊天窗口。输出列标题是 Output (incl. thinking),这比看起来更重要。稍后会详细说明。
Gemini 3.1 Pro Preview 更高,提示不超过 200k token 时为 $2.00 / $12.00,超过后为 $4.00 / $18.00。只有它和 Gemini 2.5 Pro 有这种 200k 分档。
哪些价格会翻倍,何时翻倍#
如果你在免费额度上做原型,从第一天起就按付费价格做计划,并记住这些日期。我们关于 Gemini 4 Argon 定价 的单独文章详细介绍了该模型。
时间线
Google 页面上已经列出的 Gemini 价格变化
- 2026 年 10 月 27 日定价页面最后更新;Gemini 2.5 Flash-Lite 是最低的付费文本价格
- 2026 年 12 月 1 日Gemini 4 Argon 从每 1M token $2.00 / $10.00 涨到 $4.00 / $20.00
- 2027 年 1 月 1 日Gemini 3.8 Flash 和 Gemini 3.6 Flash 从每 1M token $0.75 / $3.75 涨到 $1.50 / $7.50
注意什么不在这个列表上:三个 Flash-Lite 模型。它们的价格保持表中不变。Gemini 3.6 Flash 在页面上被标为上一代,所以如果你今天要选新的 Flash 模型,这次涨价是另一个理由去看更便宜的行。
定价页面没有给出 gemini- 的停用日期。在你基于最便宜的那一行构建为期一年的产品之前,打开 Google 的弃用页面找一找。
1,000 次请求要花多少钱#
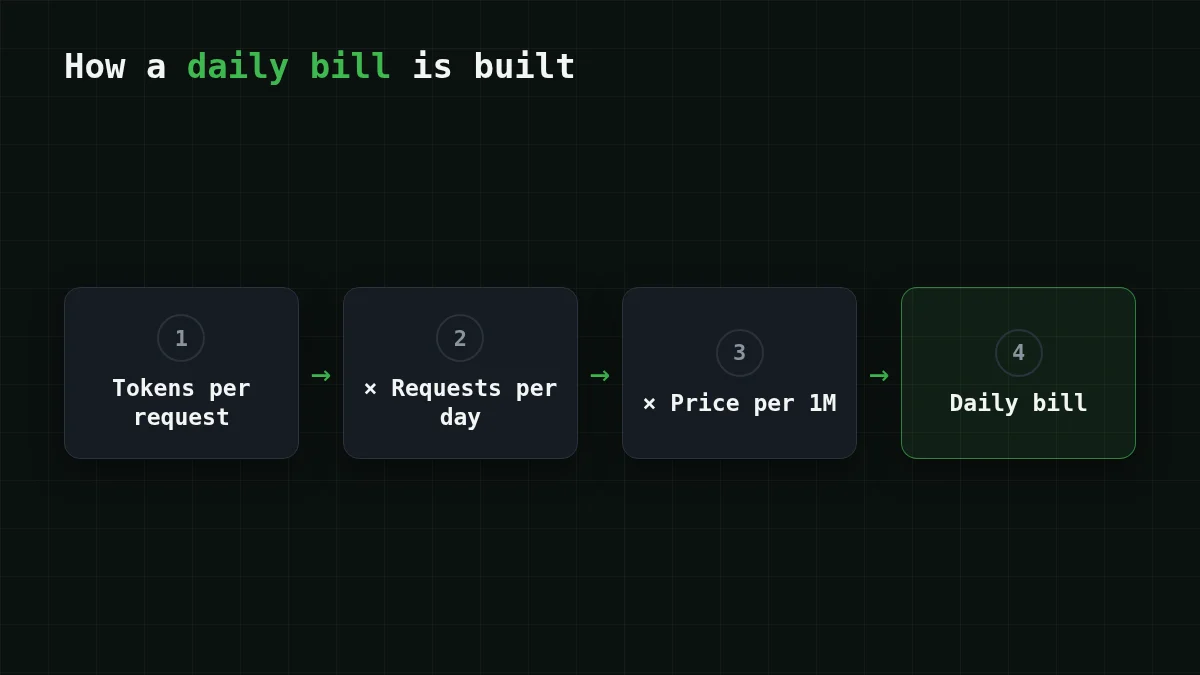
每 1M token 的价格很难有感觉。一个任务更容易。假设你运行一个总结工单的支持机器人:每次请求发送约 800 个输入 token,得到约 300 个输出 token。那么一千次请求就是 0.8M 输入 token 和 0.3M 输出 token。按 Gemini 的标准价格:
- Gemini 2.5 Flash-Lite:输入 0.8 × $0.10 = $0.08,输出 0.3 × $0.40 = $0.12,所以总计 $0.08 + $0.12 = $0.20。
- Gemini 3.1 Flash-Lite:输入 0.8 × $0.25 = $0.20,输出 0.3 × $1.50 = $0.45,所以总计 $0.20 + $0.45 = $0.65。
- Gemini 3.5 Flash-Lite:输入 0.8 × $0.30 = $0.24,输出 0.3 × $2.50 = $0.75,所以总计 $0.24 + $0.75 = $0.99。
- Gemini 4 Argon:输入 0.8 × $2.00 = $1.60,输出 0.3 × $10.00 = $3.00,所以现在总计 $1.60 + $3.00 = $4.60,而从 12 月 1 日起,0.8 × $4.00 = $3.20 加上 0.3 × $20.00 = $6.00,合计 $9.20。
看出规律了吗?输出价格才是伤害所在。Flash-Lite 各代在输入上差别不大($0.10 到 $0.30),但输出从 $0.40 攀升到 $2.50,短回答的工作负载会感受到。
现在同样的 1,000 次请求通过 CheapTokens。先说一句:MiniMax-M2.7(MiniMaxAI/)运行这个工作负载花费 $0.085。下面的实时表格列出了全部三个模型,旁边是 OpenRouter 的参考价格:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
每次请求 800 个输入 token 和 300 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
表格每次页面加载时都会根据当前价格重新计算,所以当资费变动时它仍然正确。输入和输出一起计算,在这个总计中,三个 CheapTokens 模型都低于 OpenRouter 的参考价格。Gemini 2.5 Flash-Lite 对同样的 1,000 次请求收取 $0.20;上面的表格显示了 CheapTokens 针对这个确切工作负载的总计,输入和输出合计——把两者并排看。
思考 token 陷阱#
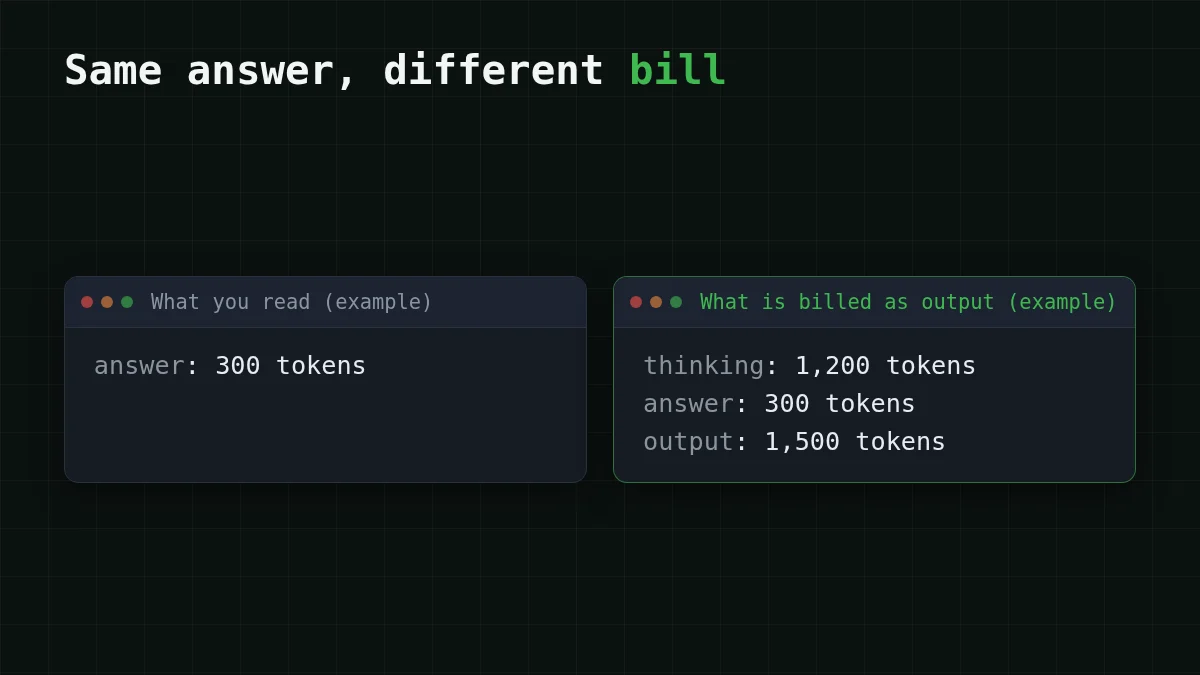
回到那个 incl. thinking 标题。一个在回答前思考的模型会写入你从未看到的额外 token,而 Gemini 将它们作为输出计费。假设每个工单摘要除了 300 token 的回答外还触发 1,200 个思考 token。现在每次请求的输出是 1,500 token,所以一千次请求在 2.5 Flash-Lite 上产生 1.5 × $0.40 = $0.60 的输出费用,高于 $0.12。同样的可见回答,输出行是五倍。
快速检查
你的 Gemini 回答有 300 token 长,但账单显示 1,500 个输出 token。最可能发生了什么?
显示答案
答案: 模型花了约 1,200 个 token 思考,而思考按输出计费
Google 的输出列包含思考 token,所以隐藏的推理会出现在账单的输出侧。在估算一个月之前,先检查几个真实响应的用量数字。
选哪一个#
正确的行取决于你在做什么,而不是单一排名。
选择你的情况
哪种设置适合你的情况?
选择一个选项以查看答案
流量很小的原型
在拥有免费额度的模型上使用 Gemini 免费额度。把它当作学习方式,并在发布前把同一模型的付费价格纳入预算。
大量短的交互式请求
Gemini 2.5 Flash-Lite 是最便宜的付费 Gemini 行。将上面成本表中的总计与 Gemini 的 $0.20 比较:DeepSeek-V4-Flash 在任何时段都给你固定价格、380K 上下文和每次回答最多 32,768 个输出 token,所有模型共用一个余额。
可以等待的大任务
Gemini 的 Batch API 将价格减半,如果你能接受异步结果。如果你更愿意在同一请求中获得答案,GLM-5.3-Flash(390K 上下文,最多 8,192 个输出 token)是表中的低成本小模型。
编码代理和长循环
MiniMax-M2.7 是 CheapTokens 用于代理和编码工作的模型(180K 上下文,最多 8,192 个输出 token)。代理循环会重发大量输入,所以先测量一次真实运行;GLM vs DeepSeek vs MiniMax 介绍了如何在三者之间选择。
价格只是选择的一半。在你切换任何东西之前,在兩三个候选模型上运行你自己的提示并比较答案。
在 CheapTokens 上尝试同样的请求#
该 API 兼容 OpenAI 和 Anthropic,所以调用看起来像任何聊天请求。从文档获取模型 id——不同提供商之间有所不同——并读取回复中的 usage:这能给你上面表格所需的每次请求真实 token 数。
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'每个模型的当前价格在定价页面上,DeepSeek-V4-Flash 模型页面有模型详情。


