Mô hình & so sánhSo sánh
Mô hình Gemini API rẻ nhất năm 2026: so sánh giá Flash-Lite
Mô hình Gemini nào có giá trả phí thấp nhất, mô hình nào có bậc miễn phí, giá nào tăng gấp đôi vào ngày 1 tháng 12 và 1 tháng 1, và 1.000 yêu cầu tốn bao nhiêu so với các mô hình CheapTokens.
Trên trang này
Bạn muốn mô hình Gemini rẻ nhất, và bảng giá của Google có nhiều dòng hơn cả sự kiên nhẫn của bạn. Đây là phiên bản ngắn gọn. Trên trang định giá Gemini API (cập nhật 27 tháng 10 năm 2026, kiểm tra 29 tháng 10), Gemini 2.5 Flash-Lite (gemini-) có giá văn bản trả phí thấp nhất: $0.10 mỗi 1 triệu token đầu vào và $0.40 mỗi 1 triệu token đầu ra. Nó cũng có bậc miễn phí, giống như Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite và Gemini 2.5 Flash. Và đã có hai đợt tăng giá trên trang: Gemini 4 Argon tăng gấp đôi vào ngày 1 tháng 12 năm 2026, Gemini 3.8 Flash và 3.6 Flash tăng gấp đôi vào ngày 1 tháng 1 năm 2027.
Dưới đây: giá cả so sánh trực tiếp, những gì thay đổi và khi nào, và 1.000 yêu cầu thông thường tốn bao nhiêu trên Gemini so với các mô hình bạn có thể gọi qua CheapTokens. Để biết cơ chế tính phí chính xác, token đầu vào so với đầu ra là bài giải thích ngắn gọn.
Giá Gemini hiện tại, mỗi 1 triệu token#
Đây là giá văn bản tiêu chuẩn của bậc trả phí từ trang định giá của Google, tính đến ngày 29 tháng 10 năm 2026.
Cuộn bảng sang phải →
| Mô hình | Đầu vào | Đầu ra | Bậc miễn phí |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | có |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | có |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | có |
| Gemini 2.5 Flash | $0.30 | $2.50 | có |
| Gemini 4 Argon | $2.00 | $10.00 | không |
Một vài điều ẩn trong phần chú thích. Đầu vào âm thanh tốn nhiều hơn trên các mô hình Flash-Lite ($0.30 trên 2.5 Flash-Lite, $0.50 trên 3.1 Flash-Lite), vì vậy một pipeline thoại sẽ không khớp với bảng này. Batch API giảm 50%, nhưng nó không đồng bộ: bạn gửi một công việc và thu kết quả sau, nên nó phù hợp với công việc qua đêm, không phải cửa sổ chat. Và cột đầu ra có tiêu đề Đầu ra (bao gồm suy nghĩ), điều này quan trọng hơn vẻ ngoài của nó. Sẽ nói thêm về điều đó trong một phút.
Gemini 3.1 Pro Preview nằm cao hơn ở mức $2.00 / $12.00 cho các prompt lên đến 200k token và $4.00 / $18.00 trên mức đó. Chỉ nó và Gemini 2.5 Pro có sự phân chia 200k đó.
Giá nào tăng gấp đôi, và khi nào#
Nếu bạn tạo mẫu trên bậc miễn phí, hãy lên kế hoạch cho giá trả phí ngay từ ngày đầu, và ghi nhớ những ngày này. Bài viết riêng của chúng tôi về định giá Gemini 4 Argon đề cập chi tiết mô hình đó.
Dòng thời gian
Thay đổi giá Gemini đã có trên trang của Google
- 27 tháng 10 năm 2026trang định giá được cập nhật lần cuối; Gemini 2.5 Flash-Lite là giá văn bản trả phí thấp nhất
- 1 tháng 12 năm 2026Gemini 4 Argon tăng từ $2.00 / $10.00 lên $4.00 / $20.00 mỗi 1 triệu token
- 1 tháng 1 năm 2027Gemini 3.8 Flash và Gemini 3.6 Flash tăng từ $0.75 / $3.75 lên $1.50 / $7.50 mỗi 1 triệu token
Hãy để ý những gì không có trong danh sách đó: ba mô hình Flash-Lite. Giá của chúng giữ nguyên như trong bảng. Gemini 3.6 Flash được gắn nhãn thế hệ trước trên trang, vì vậy nếu bạn đang chọn một mô hình Flash mới hôm nay, việc tăng giá là một lý do nữa để xem xét các dòng rẻ hơn.
Trang định giá không đưa ra ngày ngừng hoạt động cho gemini-. Trước khi bạn xây dựng một sản phẩm dài hạn trên dòng rẻ nhất, hãy mở trang ngừng hỗ trợ của Google và tìm ngày đó.
1.000 yêu cầu tốn bao nhiêu#
Giá mỗi 1 triệu token thật khó cảm nhận. Một nhiệm vụ thì dễ hơn. Giả sử bạn chạy một bot hỗ trợ tóm tắt phiếu yêu cầu: mỗi yêu cầu gửi khoảng 800 token vào và nhận khoảng 300 token ra. Một nghìn yêu cầu sau đó là 0.8 triệu token đầu vào và 0.3 triệu token đầu ra. Theo giá tiêu chuẩn của Gemini:
- Gemini 2.5 Flash-Lite: đầu vào 0.8 × $0.10 = $0.08, đầu ra 0.3 × $0.40 = $0.12, vậy tổng cộng $0.08 + $0.12 = $0.20.
- Gemini 3.1 Flash-Lite: đầu vào 0.8 × $0.25 = $0.20, đầu ra 0.3 × $1.50 = $0.45, vậy tổng cộng $0.20 + $0.45 = $0.65.
- Gemini 3.5 Flash-Lite: đầu vào 0.8 × $0.30 = $0.24, đầu ra 0.3 × $2.50 = $0.75, vậy tổng cộng $0.24 + $0.75 = $0.99.
- Gemini 4 Argon: đầu vào 0.8 × $2.00 = $1.60, đầu ra 0.3 × $10.00 = $3.00, vậy tổng cộng $1.60 + $3.00 = $4.60 hiện tại, và 0.8 × $4.00 = $3.20 cộng 0.3 × $20.00 = $6.00 thành $9.20 từ ngày 1 tháng 12.
Thấy quy luật không? Giá đầu ra gây thiệt hại. Các thế hệ Flash-Lite khác nhau ít về đầu vào ($0.10 đến $0.30) nhưng đầu ra tăng từ $0.40 lên $2.50, và một khối lượng công việc trả lời ngắn sẽ cảm nhận được điều đó.
Bây giờ là cùng 1.000 yêu cầu qua CheapTokens. Một dòng trước: MiniMax-M2.7 (MiniMaxAI/) chạy khối lượng công việc này với $0.085. Bảng trực tiếp dưới đây có cả ba mô hình với giá tham chiếu của OpenRouter bên cạnh:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 token đầu vào và 300 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Bảng tính lại từ giá hiện tại mỗi khi trang tải, vì vậy nó vẫn đúng khi giá thay đổi. Đầu vào và đầu ra được tính cùng nhau, và trong tổng đó cả ba mô hình CheapTokens đều thấp hơn giá tham chiếu của OpenRouter. Gemini 2.5 Flash-Lite lấy $0.20 cho cùng 1.000 yêu cầu; bảng trên hiển thị tổng của CheapTokens cho chính khối lượng công việc này, đầu vào và đầu ra cùng nhau — hãy đọc hai bên cạnh nhau.
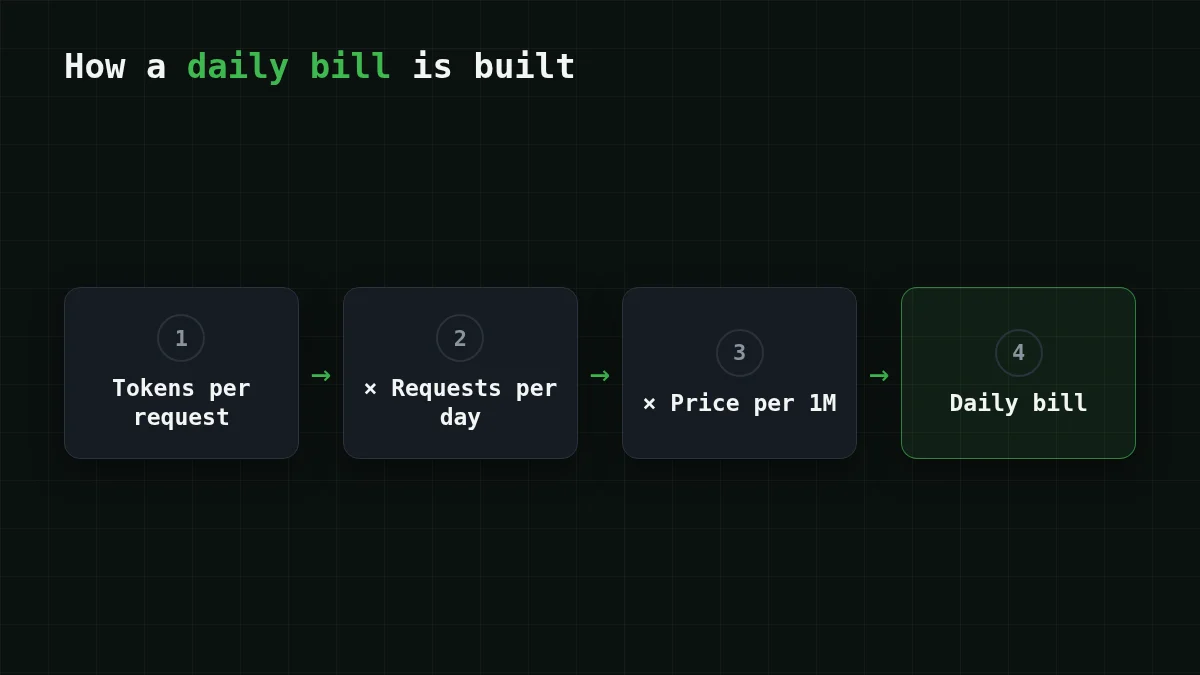
Cái bẫy token suy nghĩ#
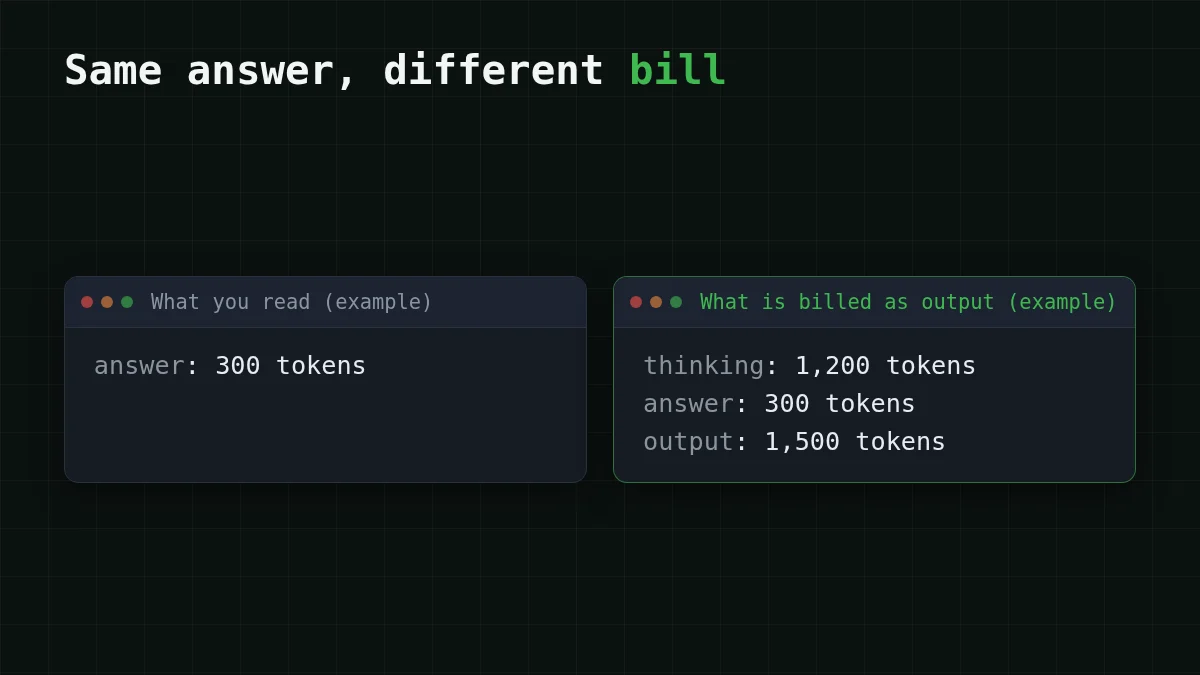
Quay lại tiêu đề bao gồm suy nghĩ. Một mô hình suy nghĩ trước khi trả lời sẽ ghi thêm token mà bạn không bao giờ thấy, và Gemini tính chúng như đầu ra. Giả sử mỗi bản tóm tắt phiếu yêu cầu kích hoạt 1.200 token suy nghĩ thêm vào câu trả lời 300 token. Đầu ra mỗi yêu cầu bây giờ là 1.500 token, vậy một nghìn yêu cầu cho 1.5 × $0.40 = $0.60 đầu ra trên 2.5 Flash-Lite, tăng từ $0.12. Cùng một câu trả lời hiển thị, gấp năm lần dòng đầu ra.
Kiểm tra nhanh
Câu trả lời Gemini của bạn dài 300 token, nhưng hóa đơn hiển thị 1.500 token đầu ra. Điều gì có khả năng nhất đã xảy ra?
Hiện đáp án
Trả lời: Mô hình đã dành khoảng 1.200 token để suy nghĩ, và suy nghĩ được tính là đầu ra
Cột đầu ra của Google bao gồm token suy nghĩ, vì vậy lý luận ẩn xuất hiện ở phía đầu ra của hóa đơn. Hãy kiểm tra số liệu sử dụng trên một vài phản hồi thực tế trước khi ước tính một tháng.
Chọn cái nào#
Dòng đúng phụ thuộc vào việc bạn đang làm gì, không phải vào một bảng xếp hạng duy nhất.
Chọn trường hợp của bạn
Thiết lập nào phù hợp với trường hợp của bạn?
Chọn một tùy chọn để xem đáp án
Tạo mẫu với lưu lượng rất thấp
Sử dụng bậc miễn phí của Gemini trên một trong những mô hình có nó. Hãy coi đó là cách để học, và đưa giá trả phí của cùng mô hình đó vào ngân sách trước khi bạn phát hành.
Nhiều yêu cầu tương tác ngắn
Gemini 2.5 Flash-Lite là dòng Gemini trả phí rẻ nhất. So sánh tổng trong bảng chi phí ở trên với $0.20 của Gemini: DeepSeek-V4-Flash cho bạn giá cố định vào bất kỳ thời điểm nào trong ngày, ngữ cảnh 380K và tối đa 32.768 token đầu ra mỗi câu trả lời, với một số dư chung cho tất cả mô hình.
Công việc lớn có thể chờ
Batch API của Gemini giảm một nửa giá, nếu bạn có thể chấp nhận kết quả không đồng bộ. Nếu bạn muốn nhận câu trả lời trong cùng yêu cầu, GLM-5.3-Flash (ngữ cảnh 390K, tối đa 8.192 token đầu ra) là mô hình nhỏ chi phí thấp trong bảng.
Tác nhân lập trình và vòng lặp dài
MiniMax-M2.7 là mô hình CheapTokens cho công việc tác nhân và lập trình (ngữ cảnh 180K, tối đa 8.192 token đầu ra). Vòng lặp tác nhân gửi lại nhiều đầu vào, vì vậy hãy đo một lần chạy thực tế trước; GLM so với DeepSeek so với MiniMax hướng dẫn cách chọn giữa ba mô hình.
Giá chỉ là một nửa của việc lựa chọn. Hãy chạy prompt của riêng bạn trên hai hoặc ba ứng viên và so sánh câu trả lời trước khi bạn chuyển đổi bất cứ điều gì.
Thử cùng yêu cầu trên CheapTokens#
API tương thích với OpenAI và Anthropic, vì vậy lệnh gọi trông giống như bất kỳ yêu cầu chat nào. Lấy id mô hình từ tài liệu — nó khác nhau giữa các nhà cung cấp — và đọc usage trong phản hồi: điều đó cho bạn số token thực tế mỗi yêu cầu cho bảng ở trên.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Giá hiện tại cho mọi mô hình có trên trang định giá, và trang mô hình DeepSeek-V4-Flash có chi tiết mô hình.


