Modelos e comparaçõesComparação
Modelo Gemini API mais barato em 2026: preços do Flash-Lite comparados
Qual modelo Gemini tem o menor preço pago, quais têm nível gratuito, o que dobra em 1º de dezembro e 1º de janeiro, e quanto custam 1.000 requisições ao lado dos modelos CheapTokens.
Nesta página
Você quer o modelo Gemini mais barato, e a lista de preços do Google tem mais linhas do que a sua paciência. Aqui está a versão curta. Na página de preços da Gemini API (atualizada em 27 de outubro de 2026, verificada em 29 de outubro), o Gemini 2.5 Flash-Lite (gemini-) tem o menor preço pago de texto: $0,10 por 1M de tokens de entrada e $0,40 por 1M de tokens de saída. Ele também tem um nível gratuito, assim como o Gemini 3.1 Flash-Lite, o Gemini 3.5 Flash-Lite e o Gemini 2.5 Flash. E dois aumentos de preço já estão na página: o Gemini 4 Argon dobra em 1º de dezembro de 2026, e o Gemini 3.8 Flash e o 3.6 Flash dobram em 1º de janeiro de 2027.
Abaixo: os preços lado a lado, o que muda e quando, e quanto custam 1.000 requisições comuns no Gemini versus os modelos que você pode chamar pelo CheapTokens. Para a mecânica exata da cobrança, tokens de entrada vs saída é o explicador curto.
Preços do Gemini hoje, por 1M de tokens#
Estes são os preços padrão de texto do nível pago da página de preços do Google, em 29 de outubro de 2026.
Role a tabela para a direita →
| Modelo | Entrada | Saída | Nível gratuito |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0,10 | $0,40 | sim |
| Gemini 3.1 Flash-Lite | $0,25 | $1,50 | sim |
| Gemini 3.5 Flash-Lite | $0,30 | $2,50 | sim |
| Gemini 2.5 Flash | $0,30 | $2,50 | sim |
| Gemini 4 Argon | $2,00 | $10,00 | não |
Algumas coisas se escondem nas notas de rodapé. A entrada de áudio custa mais nos modelos Flash-Lite ($0,30 no 2.5 Flash-Lite, $0,50 no 3.1 Flash-Lite), então um pipeline de voz não vai bater com esta tabela. A Batch API dá 50% de desconto, mas é assíncrona: você envia um job e coleta os resultados depois, então serve para jobs noturnos, não para uma janela de chat. E a coluna de saída tem o cabeçalho Saída (incl. raciocínio), o que importa mais do que parece. Mais sobre isso em um minuto.
O Gemini 3.1 Pro Preview fica mais alto, a $2,00 / $12,00 para prompts de até 200k tokens e $4,00 / $18,00 acima disso. Só ele e o Gemini 2.5 Pro têm essa divisão em 200k.
Quais preços dobram, e quando#
Se você faz protótipo no nível gratuito, planeje o preço pago desde o primeiro dia e mantenha estas datas em mente. Nosso artigo separado sobre preços do Gemini 4 Argon cobre esse modelo em detalhe.
Linha do tempo
Mudanças de preço do Gemini já na página do Google
- 27 out 2026página de preços atualizada pela última vez; Gemini 2.5 Flash-Lite é o menor preço pago de texto
- 1 dez 2026Gemini 4 Argon vai de $2,00 / $10,00 para $4,00 / $20,00 por 1M de tokens
- 1 jan 2027Gemini 3.8 Flash e Gemini 3.6 Flash vão de $0,75 / $3,75 para $1,50 / $7,50 por 1M de tokens
Note o que não está nessa lista: os três modelos Flash-Lite. Os preços deles permanecem como na tabela. O Gemini 3.6 Flash está rotulado como geração anterior na página, então se você está escolhendo um novo modelo Flash hoje, o aumento é mais um motivo para olhar as linhas mais baratas.
A página de preços não dá data de desligamento para gemini-. Antes de construir um produto de um ano na linha mais barata, abra a página de depreciações do Google e procure uma.
Quanto custam 1.000 requisições#
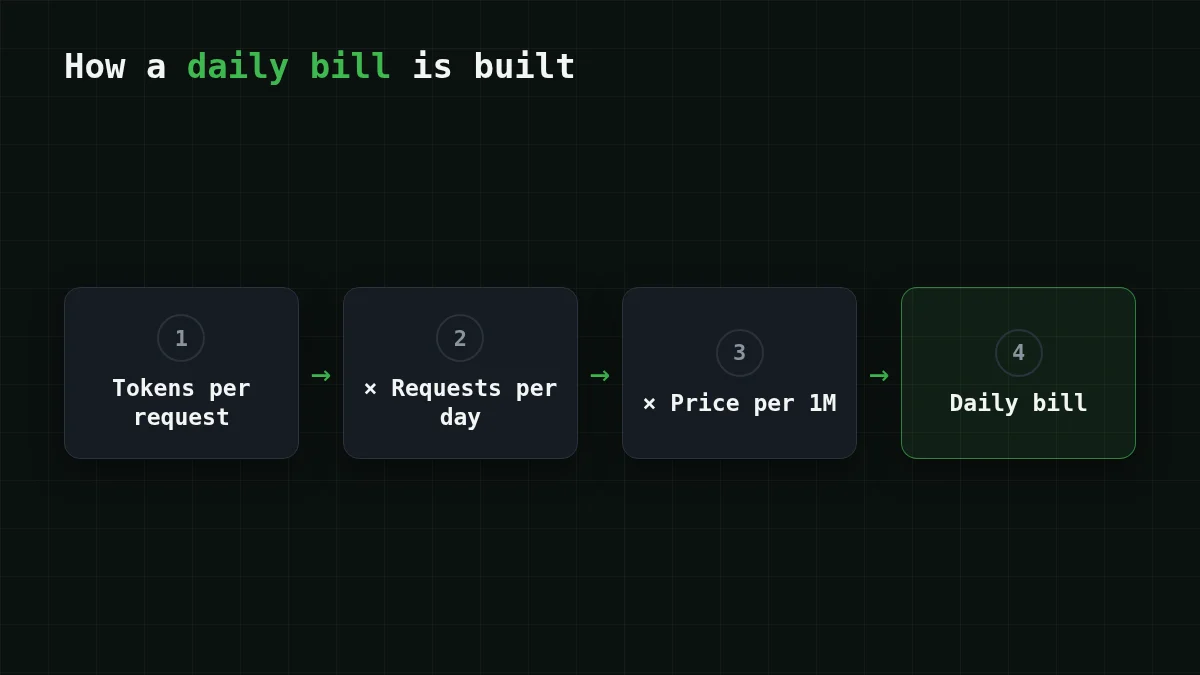
Preço por 1M de tokens é difícil de sentir. Uma tarefa é mais fácil. Digamos que você rode um bot de suporte que resume tickets: cada requisição envia cerca de 800 tokens de entrada e recebe cerca de 300 tokens de saída. Mil requisições são então 0,8M de tokens de entrada e 0,3M de tokens de saída. Nos preços padrão do Gemini:
- Gemini 2.5 Flash-Lite: entrada 0,8 × $0,10 = $0,08, saída 0,3 × $0,40 = $0,12, então $0,08 + $0,12 = $0,20 no total.
- Gemini 3.1 Flash-Lite: entrada 0,8 × $0,25 = $0,20, saída 0,3 × $1,50 = $0,45, então $0,20 + $0,45 = $0,65 no total.
- Gemini 3.5 Flash-Lite: entrada 0,8 × $0,30 = $0,24, saída 0,3 × $2,50 = $0,75, então $0,24 + $0,75 = $0,99 no total.
- Gemini 4 Argon: entrada 0,8 × $2,00 = $1,60, saída 0,3 × $10,00 = $3,00, então $1,60 + $3,00 = $4,60 agora, e 0,8 × $4,00 = $3,20 mais 0,3 × $20,00 = $6,00 dá $9,20 a partir de 1º de dezembro.
Viu o padrão? O preço de saída faz o estrago. As gerações Flash-Lite diferem pouco na entrada ($0,10 a $0,30), mas a saída sobe de $0,40 para $2,50, e uma carga de trabalho de respostas curtas sente isso.
Agora as mesmas 1.000 requisições pelo CheapTokens. Uma linha primeiro: o MiniMax-M2.7 (MiniMaxAI/) roda esta carga de trabalho por $0.085. A tabela ao vivo abaixo tem os três modelos com o preço de referência do OpenRouter ao lado deles:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 tokens de entrada e 300 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
A tabela recalcula a partir dos preços atuais toda vez que a página carrega, então continua correta quando as tarifas mudam. Entrada e saída são contadas juntas, e nesse total os três modelos CheapTokens ficam abaixo do preço de referência do OpenRouter. O Gemini 2.5 Flash-Lite leva $0,20 pelas mesmas 1.000 requisições; a tabela acima mostra os totais do CheapTokens para exatamente esta carga de trabalho, entrada e saída juntas — leia os dois lado a lado.
A armadilha dos tokens de raciocínio#
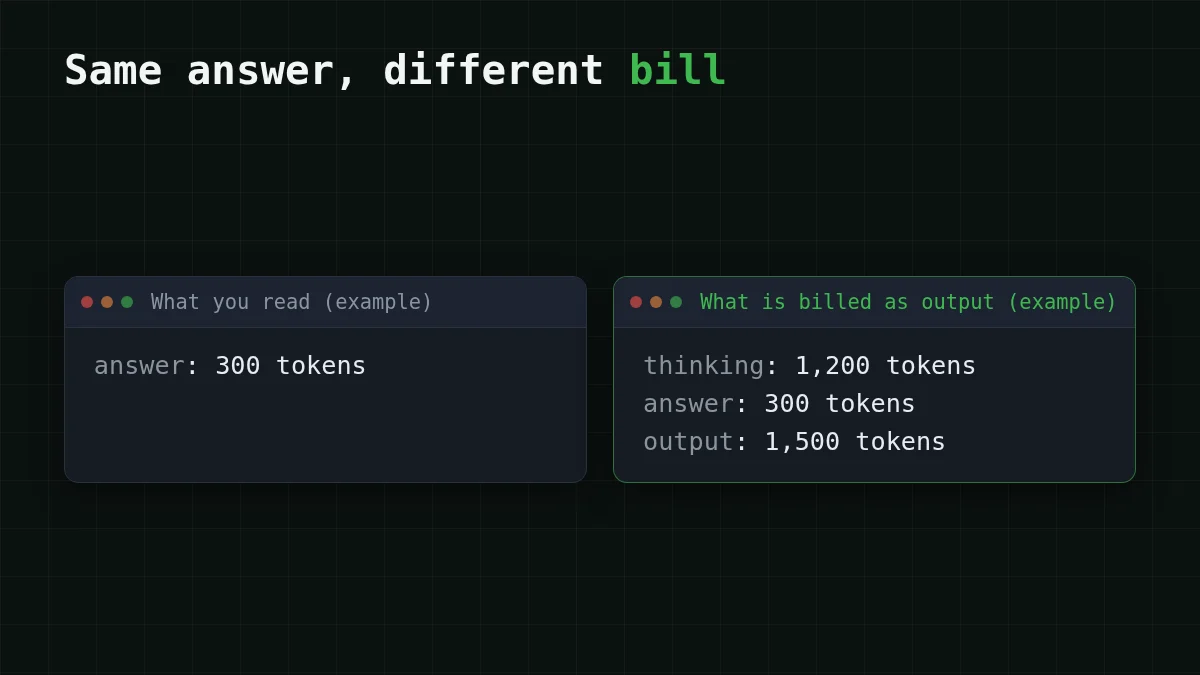
De volta àquele cabeçalho incl. raciocínio. Um modelo que pensa antes de responder escreve tokens extras que você nunca vê, e o Gemini os cobra como saída. Digamos que cada resumo de ticket dispare 1.200 tokens de raciocínio além da resposta de 300 tokens. A saída por requisição agora é de 1.500 tokens, então mil requisições dão 1,5 × $0,40 = $0,60 de saída no 2.5 Flash-Lite, acima de $0,12. Mesma resposta visível, cinco vezes a linha de saída.
Verificação rápida
Sua resposta do Gemini tem 300 tokens, mas a conta mostra 1.500 tokens de saída. O que provavelmente aconteceu?
Mostrar resposta
Resposta: O modelo gastou cerca de 1.200 tokens pensando, e o raciocínio é cobrado como saída
A coluna de saída do Google inclui tokens de raciocínio, então o raciocínio oculto aparece no lado da saída da conta. Verifique os números de uso em algumas respostas reais antes de estimar um mês.
Qual escolher#
A linha certa depende do que você está fazendo, não de um único ranking.
Escolha o seu caso
Qual configuração se encaixa no seu caso?
Escolha uma opção para ver a resposta
Protótipo com muito pouco tráfego
Use o nível gratuito do Gemini em um dos modelos que o têm. Trate-o como uma forma de aprender e coloque o preço pago do mesmo modelo no seu orçamento antes de lançar.
Muitas requisições interativas curtas
O Gemini 2.5 Flash-Lite é a linha paga mais barata do Gemini. Compare os totais na tabela de custos acima com os $0,20 do Gemini: o DeepSeek-V4-Flash oferece um preço fixo a qualquer hora do dia, contexto de 380K e até 32.768 tokens de saída por resposta, com um único saldo em todos os modelos.
Grandes jobs que podem esperar
A Batch API do Gemini corta o preço pela metade, se você puder conviver com resultados assíncronos. Se preferir receber respostas na mesma requisição, o GLM-5.3-Flash (contexto de 390K, até 8.192 tokens de saída) é o modelo pequeno de baixo custo da tabela.
Agentes de código e loops longos
O MiniMax-M2.7 é o modelo CheapTokens para trabalho agêntico e de código (contexto de 180K, até 8.192 tokens de saída). Loops de agentes reenviam muita entrada, então meça uma execução real primeiro; GLM vs DeepSeek vs MiniMax mostra como escolher entre os três.
Preço é só metade da escolha. Rode seus próprios prompts nos dois ou três candidatos e compare as respostas antes de trocar qualquer coisa.
Experimente a mesma requisição no CheapTokens#
A API é compatível com OpenAI e Anthropic, então a chamada parece qualquer requisição de chat. Pegue o id do modelo na documentação — ele difere entre provedores — e leia usage na resposta: isso dá os tokens reais por requisição para a tabela acima.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Os preços atuais de cada modelo estão na página de preços, e a página do modelo DeepSeek-V4-Flash tem os detalhes do modelo.


