Modelle & VergleicheVergleich
Günstigstes Gemini-API-Modell 2026: Flash-Lite-Preise im Vergleich
Welches Gemini-Modell hat den niedrigsten bezahlten Preis, welche haben ein Free Tier, was verdoppelt sich am 1. Dez. und 1. Jan., und was kosten 1.000 Requests im Vergleich zu CheapTokens-Modellen.
Auf dieser Seite
Du willst das günstigste Gemini-Modell, und Googles Preisliste hat mehr Zeilen, als du Geduld hast. Hier die Kurzfassung. Auf der Preisseite der Gemini API (aktualisiert am 27. Oktober 2026, geprüft am 29. Oktober) hat Gemini 2.5 Flash-Lite (gemini-) den niedrigsten bezahlten Textpreis: $0.10 pro 1M Input-Tokens und $0.40 pro 1M Output-Tokens. Es hat außerdem ein Free Tier, genau wie Gemini 3.1 Flash-Lite, Gemini 3.5 Flash-Lite und Gemini 2.5 Flash. Und zwei Preiserhöhungen stehen bereits auf der Seite: Gemini 4 Argon verdoppelt sich am 1. Dezember 2026, Gemini 3.8 Flash und 3.6 Flash verdoppeln sich am 1. Januar 2027.
Unten: die Preise im Vergleich, was sich wann ändert und was 1.000 gewöhnliche Requests auf Gemini im Vergleich zu den Modellen kosten, die du über CheapTokens aufrufen kannst. Für die genaue Abrechnungsmechanik ist input vs output tokens die kurze Erklärung.
Gemini-Preise heute, pro 1M Tokens#
Das sind die Standard-Textpreise der bezahlten Stufe von Googles Preisseite, Stand 29. Oktober 2026.
Tabelle nach rechts scrollen →
| Modell | Input | Output | Free Tier |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | ja |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | ja |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | ja |
| Gemini 2.5 Flash | $0.30 | $2.50 | ja |
| Gemini 4 Argon | $2.00 | $10.00 | nein |
Ein paar Dinge verstecken sich in den Fußnoten. Audio-Input kostet bei den Flash-Lite-Modellen mehr ($0.30 bei 2.5 Flash-Lite, $0.50 bei 3.1 Flash-Lite), eine Voice-Pipeline wird also nicht zu dieser Tabelle passen. Die Batch API gibt 50% Rabatt, ist aber asynchron: Du reichst einen Job ein und holst die Ergebnisse später ab, das passt also zu nächtlichen Jobs, nicht zu einem Chatfenster. Und die Output-Spalte heißt Output (incl. thinking), was wichtiger ist, als es aussieht. Mehr dazu gleich.
Gemini 3.1 Pro Preview liegt höher bei $2.00 / $12.00 für Prompts bis 200k Tokens und $4.00 / $18.00 darüber. Nur es und Gemini 2.5 Pro haben diese 200k-Aufteilung.
Welche Preise sich verdoppeln, und wann#
Wenn du auf einem Free Tier prototypst, plane den bezahlten Preis von Anfang an ein und behalte diese Daten im Blick. Unser separater Beitrag zu Gemini 4 Argon pricing behandelt dieses Modell im Detail.
Zeitstrahl
Gemini-Preisänderungen, die bereits auf Googles Seite stehen
- 27. Okt. 2026Preisseite zuletzt aktualisiert; Gemini 2.5 Flash-Lite ist der niedrigste bezahlte Textpreis
- 1. Dez. 2026Gemini 4 Argon geht von $2.00 / $10.00 auf $4.00 / $20.00 pro 1M Tokens
- 1. Jan. 2027Gemini 3.8 Flash und Gemini 3.6 Flash gehen von $0.75 / $3.75 auf $1.50 / $7.50 pro 1M Tokens
Beachte, was nicht auf dieser Liste steht: die drei Flash-Lite-Modelle. Ihre Preise bleiben wie in der Tabelle. Gemini 3.6 Flash ist auf der Seite als vorherige Generation gekennzeichnet, wenn du also heute ein neues Flash-Modell wählst, ist die Erhöhung ein weiterer Grund, dir die günstigeren Zeilen anzusehen.
Die Preisseite nennt kein Abschaltdatum für gemini-. Bevor du ein einjähriges Produkt auf der günstigsten Zeile baust, öffne Googles Deprecations-Seite und suche danach.
Was 1.000 Requests kosten#
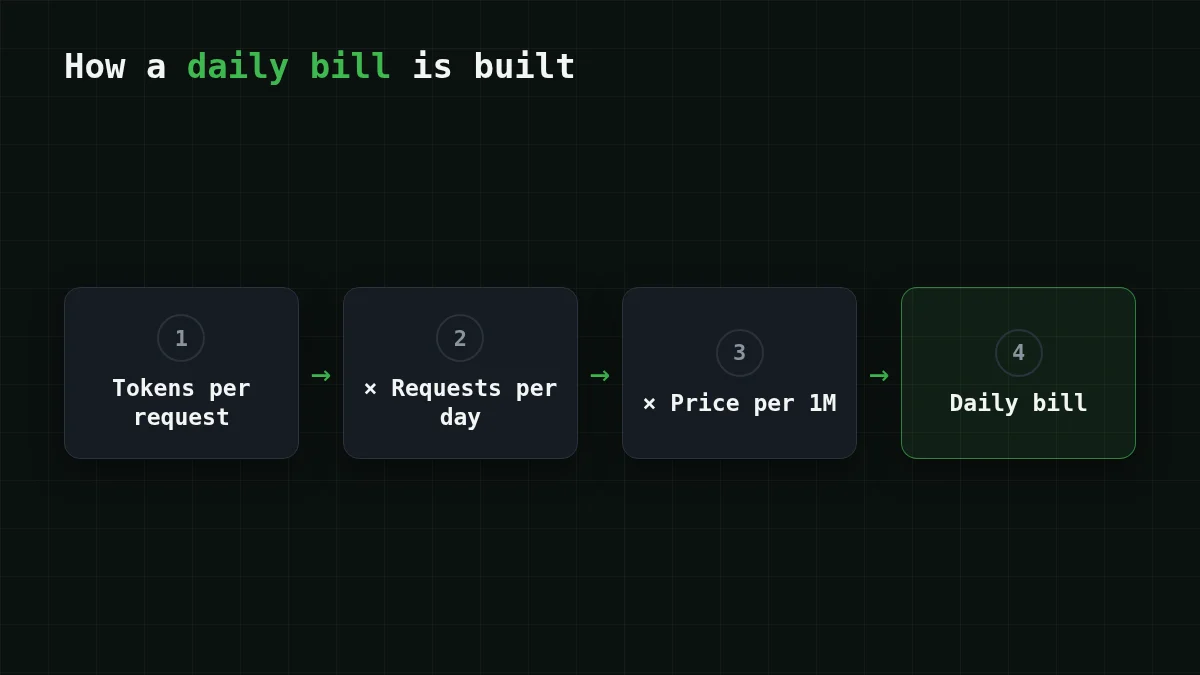
Preis pro 1M Tokens ist schwer zu spüren. Eine Aufgabe ist einfacher. Sagen wir, du betreibst einen Support-Bot, der Tickets zusammenfasst: Jeder Request sendet etwa 800 Tokens Input und bekommt etwa 300 Tokens Output. Tausend Requests sind dann 0.8M Input-Tokens und 0.3M Output-Tokens. Zu Geminis Standardpreisen:
- Gemini 2.5 Flash-Lite: Input 0.8 × $0.10 = $0.08, Output 0.3 × $0.40 = $0.12, also $0.08 + $0.12 = $0.20 insgesamt.
- Gemini 3.1 Flash-Lite: Input 0.8 × $0.25 = $0.20, Output 0.3 × $1.50 = $0.45, also $0.20 + $0.45 = $0.65 insgesamt.
- Gemini 3.5 Flash-Lite: Input 0.8 × $0.30 = $0.24, Output 0.3 × $2.50 = $0.75, also $0.24 + $0.75 = $0.99 insgesamt.
- Gemini 4 Argon: Input 0.8 × $2.00 = $1.60, Output 0.3 × $10.00 = $3.00, also $1.60 + $3.00 = $4.60 jetzt, und 0.8 × $4.00 = $3.20 plus 0.3 × $20.00 = $6.00 ergibt $9.20 ab dem 1. Dezember.
Siehst du das Muster? Der Output-Preis richtet den Schaden an. Die Flash-Lite-Generationen unterscheiden sich beim Input kaum ($0.10 bis $0.30), aber der Output steigt von $0.40 auf $2.50, und eine Workload mit kurzen Antworten spürt das.
Jetzt dieselben 1.000 Requests über CheapTokens. Zuerst eine Zeile: MiniMax-M2.7 (MiniMaxAI/) erledigt diese Workload für $0.085. Die Live-Tabelle unten enthält alle drei Modelle mit OpenRouters Referenzpreis daneben:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
800 Input- und 300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Tabelle berechnet sich bei jedem Seitenaufruf aus den aktuellen Preisen neu, bleibt also korrekt, wenn sich die Tarife ändern. Input und Output werden zusammen gezählt, und in dieser Summe liegen alle drei CheapTokens-Modelle unter OpenRouters Referenzpreis. Gemini 2.5 Flash-Lite nimmt $0.20 für dieselben 1.000 Requests; die Tabelle oben zeigt die CheapTokens-Summen für genau diese Workload, Input und Output zusammen — lies beide nebeneinander.
Die Thinking-Token-Falle#
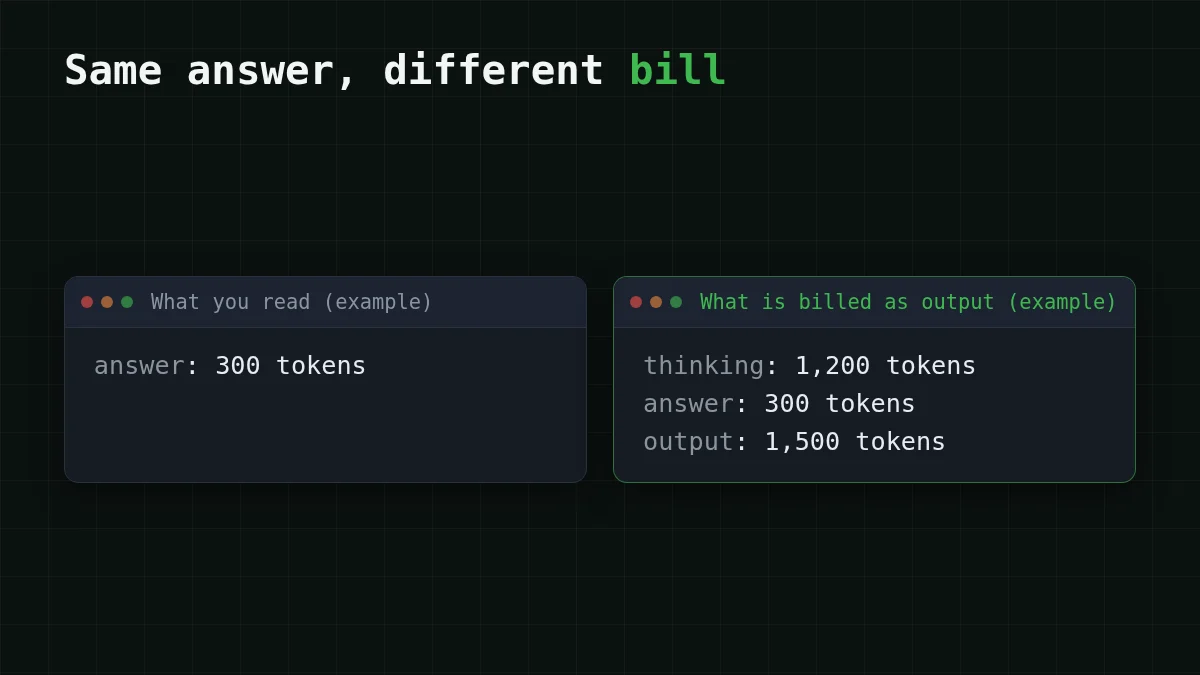
Zurück zu dieser incl. thinking-Überschrift. Ein Modell, das vor der Antwort nachdenkt, schreibt zusätzliche Tokens, die du nie siehst, und Gemini berechnet sie als Output. Sagen wir, jede Ticket-Zusammenfassung löst 1.200 Thinking-Tokens zusätzlich zur 300-Token-Antwort aus. Der Output pro Request beträgt dann 1.500 Tokens, also ergeben tausend Requests 1.5 × $0.40 = $0.60 Output bei 2.5 Flash-Lite, statt $0.12. Gleiche sichtbare Antwort, fünffache Output-Zeile.
Kurzer Check
Deine Gemini-Antwort ist 300 Tokens lang, aber die Rechnung zeigt 1.500 Output-Tokens. Was ist am wahrscheinlichsten passiert?
Antwort anzeigen
Antwort: Das Modell hat etwa 1.200 Tokens mit Thinking verbracht, und Thinking wird als Output abgerechnet
Googles Output-Spalte enthält Thinking-Tokens, verstecktes Reasoning taucht also auf der Output-Seite der Rechnung auf. Prüfe die Usage-Zahlen bei ein paar echten Antworten, bevor du einen Monat schätzt.
Welches du wählen solltest#
Die richtige Zeile hängt davon ab, was du tust, nicht von einem einzigen Ranking.
Wähle deinen Fall
Welches Setup passt zu deinem Fall?
Wähle eine Option, um die Antwort zu sehen
Prototyp mit sehr wenig Traffic
Nutze das Gemini Free Tier bei einem der Modelle, das es hat. Behandle es als Lernmöglichkeit und setze den bezahlten Preis desselben Modells in dein Budget, bevor du launchst.
Viele kurze interaktive Requests
Gemini 2.5 Flash-Lite ist die günstigste bezahlte Gemini-Zeile. Vergleiche die Summen in der Kostentabelle oben mit Geminis $0.20: DeepSeek-V4-Flash gibt dir einen festen Preis zu jeder Tageszeit, einen 380K-Kontext und bis zu 32.768 Output-Tokens pro Antwort, mit einem Guthaben über alle Modelle hinweg.
Große Jobs, die warten können
Geminis Batch API halbiert den Preis, wenn du mit asynchronen Ergebnissen leben kannst. Wenn du Antworten lieber im selben Request bekommst, ist GLM-5.3-Flash (390K-Kontext, bis zu 8.192 Output-Tokens) das kostengünstige kleine Modell in der Tabelle.
Coding-Agents und lange Loops
MiniMax-M2.7 ist das CheapTokens-Modell für agentische und Coding-Arbeit (180K-Kontext, bis zu 8.192 Output-Tokens). Agent-Loops senden viel Input erneut, miss also zuerst einen echten Lauf; GLM vs DeepSeek vs MiniMax erklärt, wie du zwischen den dreien wählst.
Der Preis ist nur die Hälfte einer Wahl. Führe deine eigenen Prompts auf den zwei oder drei Kandidaten aus und vergleiche die Antworten, bevor du irgendetwas umstellst.
Probiere denselben Request auf CheapTokens#
Die API ist OpenAI- und Anthropic-kompatibel, der Aufruf sieht also aus wie jeder Chat-Request. Hol dir die Modell-ID aus der Doku — sie unterscheidet sich je nach Anbieter — und lies usage in der Antwort: Das gibt dir die echten Tokens pro Request für die Tabelle oben.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'
Aktuelle Preise für jedes Modell stehen auf der Preisseite, und die DeepSeek-V4-Flash-Modellseite enthält die Modelldetails.


