モデルと比較比較
2026年最安のGemini APIモデル:Flash-Liteの価格を比較
有料価格が最も安いGeminiモデルはどれか、無料枠があるのはどれか、12月1日と1月1日に何が2倍になるのか、そして1,000リクエストがCheapTokensモデルと比べてどうなるかを解説。
最も安いGeminiモデルを探しているものの、Googleの価格表は行が多すぎて見る気が失せる。手短に言おう。Gemini APIの価格ページ(2026年10月27日更新、10月29日確認)では、Gemini 2.5 Flash-Lite(gemini-)が有料テキスト価格で最安だ。100万入力トークンあたり$0.10、100万出力トークンあたり$0.40。Gemini 3.1 Flash-Lite、Gemini 3.5 Flash-Lite、Gemini 2.5 Flashと同様に無料枠もある。そして値上げが2件すでにページに載っている。Gemini 4 Argonは2026年12月1日に2倍、Gemini 3.8 Flashと3.6 Flashは2027年1月1日に2倍になる。
以下では、価格を並べて比較し、何がいつ変わるのか、そして通常の1,000リクエストがGeminiとCheapTokens経由で呼べるモデルでいくらになるのかを見ていく。課金の正確な仕組みについては、入力トークンと出力トークンが短い解説になっている。
現在のGemini価格(100万トークンあたり)#
以下はGoogleの価格ページにある標準の有料ティアのテキスト価格で、2026年10月29日時点のものだ。
テーブルを右にスクロールしてください →
| モデル | 入力 | 出力 | 無料枠 |
|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | あり |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | あり |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | あり |
| Gemini 2.5 Flash | $0.30 | $2.50 | あり |
| Gemini 4 Argon | $2.00 | $10.00 | なし |
脚注にはいくつか注意点が隠れている。Flash-Liteモデルでは音声入力の料金が高く(2.5 Flash-Liteで$0.30、3.1 Flash-Liteで$0.50)、音声パイプラインではこの表の通りにはならない。Batch APIは50%割引だが非同期だ。ジョブを送信して後で結果を回収するため、夜間バッチには向くがチャットウィンドウには向かない。そして出力列の見出しは*出力(思考を含む)*となっており、これは見た目以上に重要だ。これについては後ほど触れる。
Gemini 3.1 Pro Previewはさらに上で、20万トークンまでのプロンプトで$2.00 / $12.00、それを超えると$4.00 / $18.00となる。この20万トークンの区分があるのはこれとGemini 2.5 Proだけだ。
どの価格がいつ2倍になるか#
無料枠でプロトタイプを作るなら、初日から有料価格を想定しておき、以下の日付を覚えておこう。Gemini 4 Argonの価格に関する別記事で、そのモデルの詳細を扱っている。
タイムライン
Googleのページにすでに載っているGeminiの価格変更
- 2026年10月27日価格ページの最終更新。Gemini 2.5 Flash-Liteが有料テキスト価格で最安
- 2026年12月1日Gemini 4 Argonが100万トークンあたり$2.00 / $10.00から$4.00 / $20.00へ
- 2027年1月1日Gemini 3.8 FlashとGemini 3.6 Flashが100万トークンあたり$0.75 / $3.75から$1.50 / $7.50へ
このリストに載っていないものに注目してほしい。3つのFlash-Liteモデルだ。これらの価格は表のまま変わらない。Gemini 3.6 Flashはページ上で前世代と表示されているので、今日新しいFlashモデルを選ぶなら、値上げはより安い行に目を向けるもう一つの理由になる。
価格ページにはgemini-の提供終了日は書かれていない。最安の行で1年がかりの製品を作る前に、Googleの非推奨ページを開いて終了日を確認しよう。
1,000リクエストのコスト#
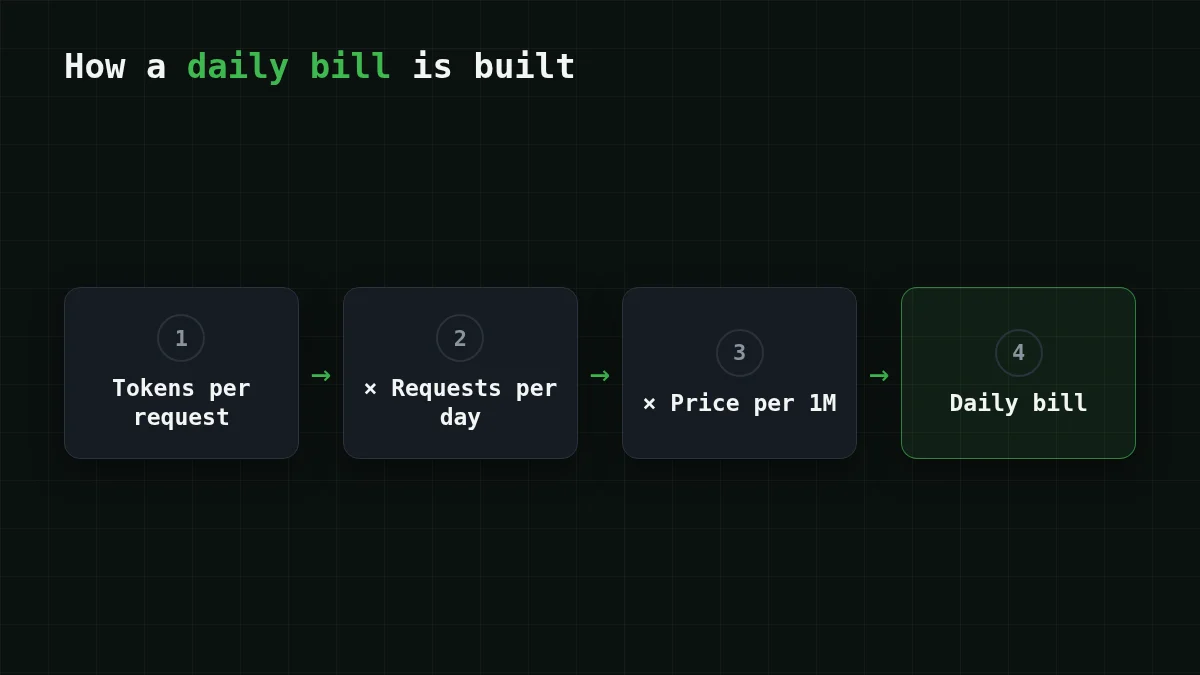
100万トークンあたりの価格は実感しにくい。タスクで考えるとわかりやすい。チケットを要約するサポートボットを運用しているとしよう。各リクエストは約800トークンを送信し、約300トークンを受け取る。すると1,000リクエストは入力0.8Mトークン、出力0.3Mトークンになる。Geminiの標準価格では:
- Gemini 2.5 Flash-Lite:入力 0.8 × $0.10 = $0.08、出力 0.3 × $0.40 = $0.12、合計 $0.08 + $0.12 = $0.20。
- Gemini 3.1 Flash-Lite:入力 0.8 × $0.25 = $0.20、出力 0.3 × $1.50 = $0.45、合計 $0.20 + $0.45 = $0.65。
- Gemini 3.5 Flash-Lite:入力 0.8 × $0.30 = $0.24、出力 0.3 × $2.50 = $0.75、合計 $0.24 + $0.75 = $0.99。
- Gemini 4 Argon:入力 0.8 × $2.00 = $1.60、出力 0.3 × $10.00 = $3.00、現在は合計 $1.60 + $3.00 = $4.60、12月1日からは 0.8 × $4.00 = $3.20 に 0.3 × $20.00 = $6.00 を加えて $9.20。
パターンが見えるだろうか。コストを押し上げるのは出力価格だ。Flash-Liteの世代間で入力はほとんど変わらない($0.10から$0.30)が、出力は$0.40から$2.50へと上がり、短い回答のワークロードではそれが響く。
では同じ1,000リクエストをCheapTokens経由で実行するとどうなるか。まず一言。MiniMax-M2.7(MiniMaxAI/)はこのワークロードを$0.085で実行する。以下のライブ表には3モデルすべてがOpenRouterの参考価格と並べて示されている:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0558 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.085 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $0.60 |
リクエストあたり 800 入力トークンと 300 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
この表はページが読み込まれるたびに現在の価格から再計算されるので、料金が変わっても正しいままだ。入力と出力は合算され、その合計ではCheapTokensの3モデルすべてがOpenRouterの参考価格を下回る。Gemini 2.5 Flash-Liteは同じ1,000リクエストで$0.20かかる。上の表はまさにこのワークロードのCheapTokens合計(入力と出力を合わせたもの)を示している。両者を並べて読んでほしい。
思考トークンの罠#
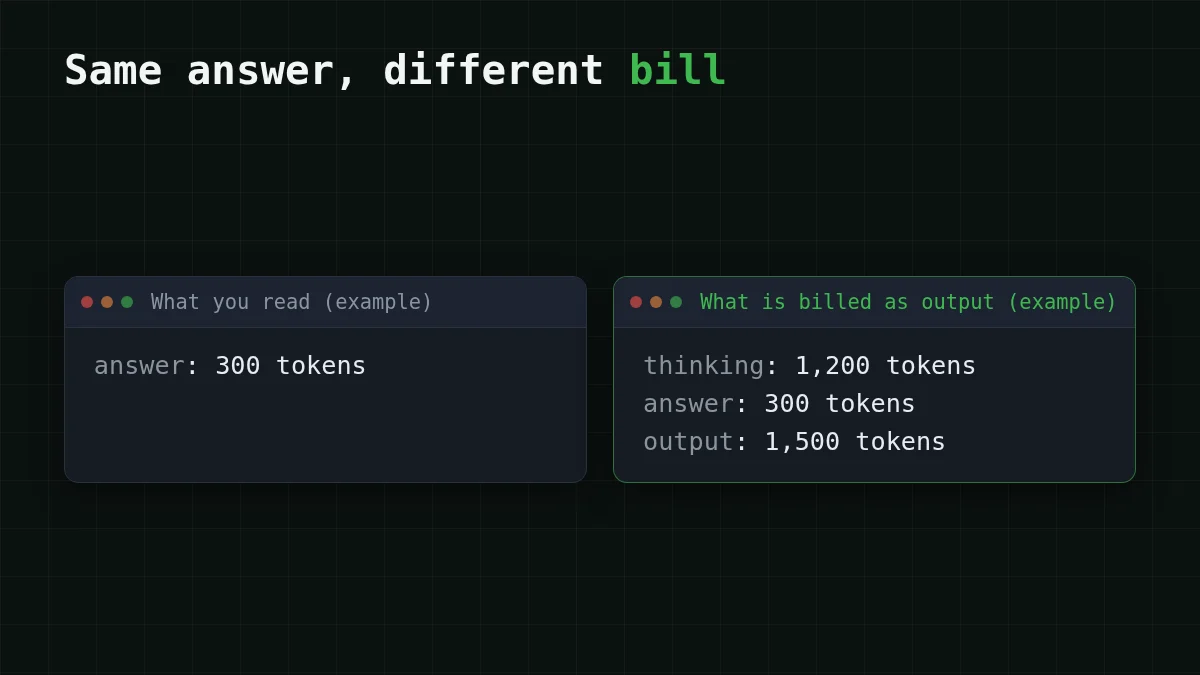
あの思考を含むという見出しに戻ろう。答える前に考えるモデルは、目に見えない余分なトークンを書き出し、Geminiはそれを出力として課金する。各チケット要約が300トークンの回答に加えて1,200の思考トークンを発生させるとしよう。するとリクエストあたりの出力は1,500トークンになり、1,000リクエストでは2.5 Flash-Liteの出力が$0.12から1.5 × $0.40 = $0.60に増える。見える回答は同じなのに、出力の行は5倍になる。
クイックチェック
Geminiの回答は300トークンの長さなのに、請求には1,500出力トークンと表示されている。最も可能性が高いのはどれか?
答えを表示
答え: モデルが約1,200トークンを思考に費やし、思考は出力として課金される
Googleの出力列には思考トークンが含まれるため、隠れた推論は請求の出力側に現れる。月の見積もりを出す前に、実際のレスポンスをいくつか確認して使用量の数値をチェックしよう。
どれを選ぶか#
正しい行は単一のランキングではなく、何をしているかによって決まる。
ケースを選ぶ
あなたのケースに合う構成はどれか?
オプションを選択して答えを表示
ごく少ないトラフィックでプロトタイプ
無料枠があるモデルのいずれかでGeminiの無料枠を使おう。学習手段として扱い、リリース前に同じモデルの有料価格を予算に入れておく。
短いインタラクティブなリクエストが多い
Gemini 2.5 Flash-Liteは有料のGeminiで最安の行だ。上のコスト表の合計とGeminiの$0.20を比較しよう。DeepSeek-V4-Flashは時間帯を問わず固定価格で、380Kのコンテキストと回答あたり最大32,768出力トークンを提供し、全モデルで1つの残高を共有する。
待てる大きなジョブ
非同期の結果で構わなければ、GeminiのBatch APIは価格を半額にする。同じリクエストで回答を得たいなら、GLM-5.3-Flash(390Kコンテキスト、最大8,192出力トークン)が表の中の低コスト小型モデルだ。
コーディングエージェントと長いループ
MiniMax-M2.7はエージェントやコーディング作業向けのCheapTokensモデルだ(180Kコンテキスト、最大8,192出力トークン)。エージェントのループは大量の入力を再送するので、まず実際の実行を計測しよう。GLM vs DeepSeek vs MiniMaxで3つの選び方を解説している。
価格は選択の半分にすぎない。候補の2、3のモデルで自分のプロンプトを実行し、何かを切り替える前に回答を比較しよう。
CheapTokensで同じリクエストを試す#
APIはOpenAIおよびAnthropicと互換性があるので、呼び出しは通常のチャットリクエストと同じに見える。モデルIDはドキュメントから取得し(プロバイダーによって異なる)、返信のusageを読もう。それが上の表の実際のリクエストあたりトークン数を与えてくれる。
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: the invoice PDF will not download."}], "max_tokens": 300}'全モデルの現在の価格は価格ページにあり、DeepSeek-V4-Flashモデルページにはモデルの詳細がある。


