Agenci i automatyzacjaPrzewodnik
Połącz n8n z CheapTokens: dane uwierzytelniające OpenAI, Base URL
Skieruj dane uwierzytelniające OpenAI w n8n na Base URL CheapTokens, przejdź test połączenia i uruchom łańcuch LLM na DeepSeek-V4-Flash.
Na tej stronie
W n8n utwórz dane uwierzytelniające OpenAI, wstaw https:/ do pola Base URL, wklej swój klucz CheapTokens do API Key i wybierz identyfikator modelu w węźle OpenAI Chat Model. To cała zmiana: żadnego niestandardowego węzła, żadnego pakietu społecznościowego. Istniejące przepływy pracy zachowują swoje węzły i zyskują tylko nowe dane uwierzytelniające.
To działa, ponieważ API CheapTokens mówi w formacie OpenAI Chat Completions (oraz Anthropic Messages), więc węzeł OpenAI w n8n nie potrafi dostrzec różnicy. Jeśli koncepcja „base URL” jest dla Ciebie nowa, ten wyjaśnienie omawia ją w dwie minuty.
Co dają Ci dane uwierzytelniające n8n#
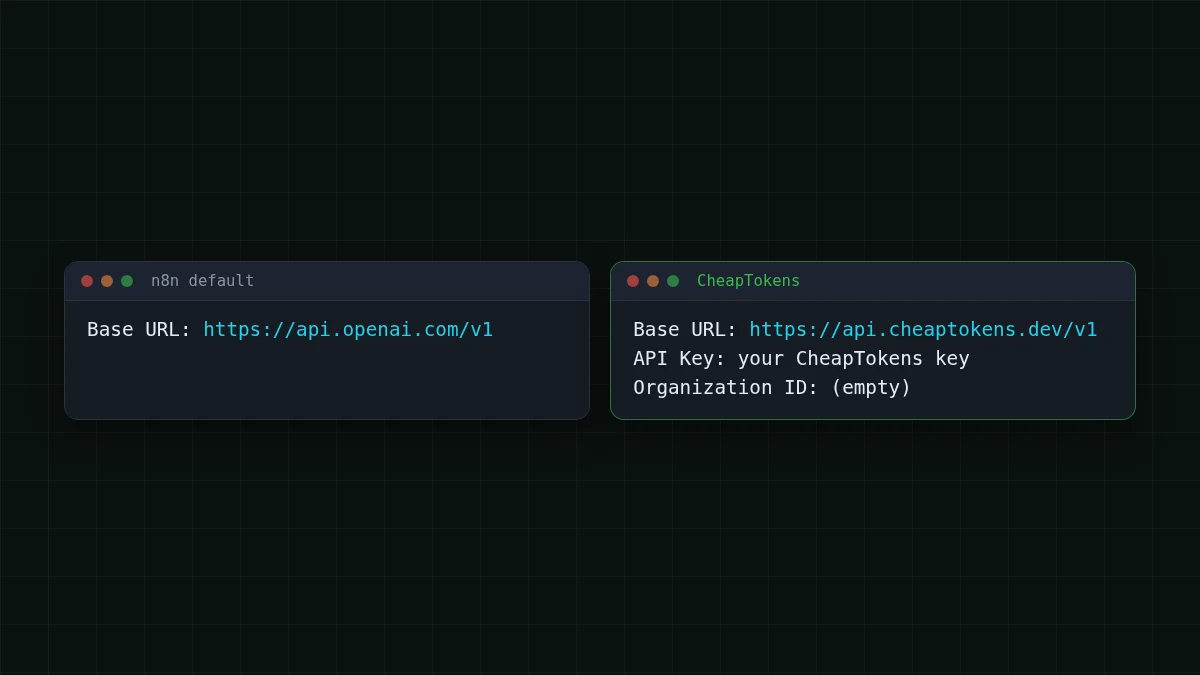
Dane uwierzytelniające OpenAI w n8n mają cztery rzeczy do wypełnienia. Według kodu źródłowego danych uwierzytelniających w repozytorium n8n (gałąź master, sprawdzone 1 listopada 2026) są to: API Key (wymagane, zamaskowane), Organization ID (opcjonalne), Base URL (domyślnie https:/, opisane jako nadpisujące bazowy adres API) oraz przełącznik Add Custom Header z nazwą i wartością nagłówka.
Jeden szczegół wart poznania: własna strona dokumentacji n8n dla danych uwierzytelniających OpenAI wymienia tylko klucz i identyfikator organizacji. Pole Base URL jest widoczne w kodzie źródłowym, więc to na nim opiera się ten przewodnik.
Po zapisaniu n8n testuje dane uwierzytelniające, wysyłając żądanie do {Base URL}/ z nagłówkiem Authorization: Bearer <API Key>. Więc błędny Base URL lub błędny klucz pokaże się właśnie tam, zanim cokolwiek zbudujesz.
Skonfiguruj to w czterech krokach#
Krok po kroku
Połącz n8n z CheapTokens
Utwórz dane uwierzytelniające
W n8n otwórz Credentials, utwórz nowe i wybierz OpenAI. Trzymaj swój klucz CheapTokens w menedżerze haseł lub zmiennej środowiskowej, dopóki go nie wkleisz, nigdy w polu tekstowym przepływu pracy.
Wypełnij dwa pola
API Key: twój klucz CheapTokens. Base URL: https:/. Pozostaw Organization ID puste. Zapisz dane uwierzytelniające i poczekaj na test połączenia: wywołuje on /models pod tym adresem.
Dodaj węzeł modelu
W przepływie pracy dodaj Basic LLM Chain i dołącz OpenAI Chat Model jako jego model. Wybierz nowe dane uwierzytelniające. Dla modelu użyj identyfikatora z dokumentacji CheapTokens: deepseek-. Jeśli lista rozwijana go nie zawiera, przełącz pole na ręczne wprowadzanie identyfikatora (przez ID lub jako wyrażenie).
Zostaw Chat Completions włączone
Węzeł domyślnie używa API Chat Completions. Pozostaw Use Responses API wyłączone. W opcjach węzła ustaw Maximum Number of Tokens, aby wymykająca się odpowiedź nie zjadła budżetu.
Nie wiesz, co wpisać jako identyfikator modelu? Zapytaj samo API: Lista modeli z GET /v1/models pokazuje dokładne ciągi. Różni dostawcy nazywają ten sam model inaczej, więc kopiuj identyfikator z CheapTokens, a nie z dokumentacji innej usługi.
Najpierw sprawdź klucz poza n8n#
Jeśli test danych uwierzytelniających się nie powiedzie, chcesz wiedzieć, czy problem leży w n8n, czy w kluczu. Krótkie sprawdzenie w terminalu to rozstrzyga. Klucz siedzi w zmiennej środowiskowej, więc nic tajnego nie trafia do historii.
To samo sprawdzenie w curl i Pythonie
curl
export CHEAPTOKENS_API_KEY="your-key-here"
curl https://api.cheaptokens.dev/v1/models \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY"
To jest to samo żądanie, które n8n wysyła, gdy testuje dane uwierzytelniające. Lista modeli w JSON oznacza, że klucz i adres są poprawne.
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Reply with one word: ready"}],
    max_tokens=20,
)
print(r.choices[0].message.content, r.usage)
To jest pełne żądanie czatu. r.usage pokazuje tokeny wejściowe i wyjściowe dla tego drobnego żądania; aby oszacować przepływ pracy, wstaw typowy e-mail do promptu i ponownie odczytaj usage.
Pierwszy przepływ pracy: sortowanie przychodzących e-maili#
Powiedzmy, że wspólna skrzynka odbiorcza dostaje około tysiąca e-maili dziennie. Chcesz, aby każdy został oznaczony jako billing, bug lub other, plus jednolinijkowe podsumowanie dla osoby, która go przejmie.
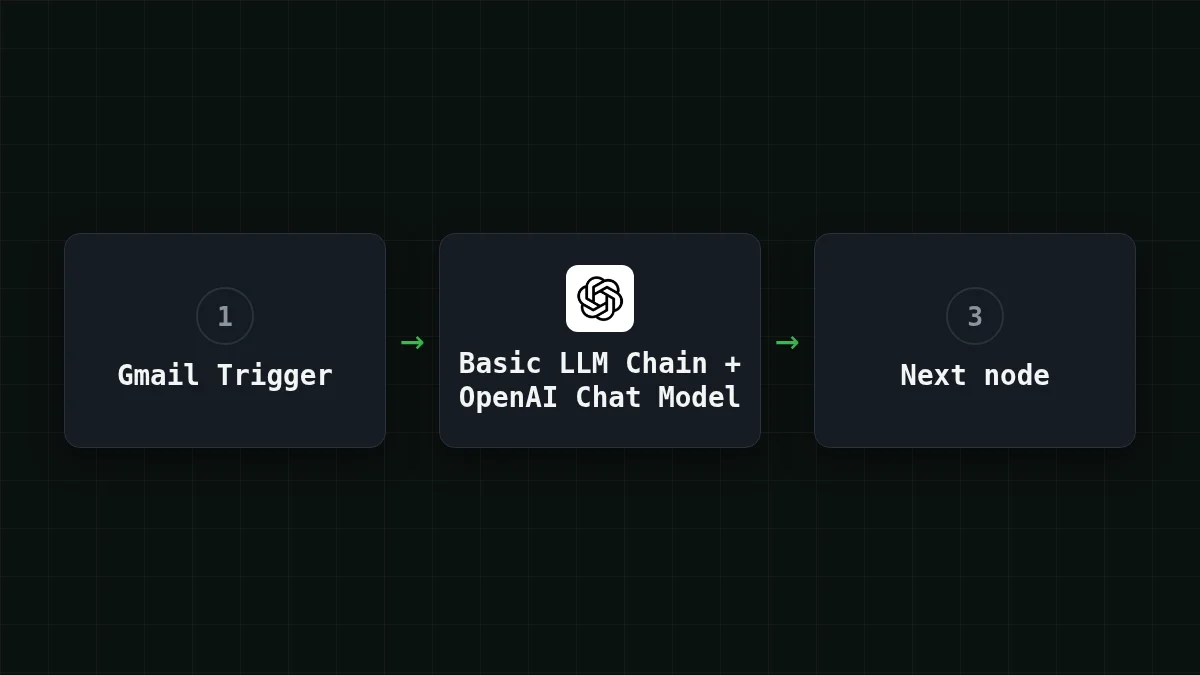
Zbuduj to tak: Gmail Trigger (lub węzeł Webhook) zasila Basic LLM Chain. Prompt w łańcuchu brzmi mniej więcej „Sklasyfikuj ten e-mail jako billing, bug lub other, a następnie podsumuj go w jednym zdaniu”, z treścią e-maila wstawioną z poprzedniego węzła. Węzeł OpenAI Chat Model pod nim, z twoimi danymi uwierzytelniającymi CheapTokens, wykonuje myślenie.
Zadanie jest krótkie i powtarzalne: małe wejście, mała odpowiedź, tysiące identycznych uruchomień. To tutaj tani model ze stabilną ceną opłaca się najbardziej. Do tego rodzaju pracy w CheapTokens DeepSeek-V4-Flash daje jedną cenę o każdej porze dnia, okno kontekstu 380K i do 32 768 tokenów na odpowiedź.
Ile kosztuje uruchomienie#
Powiedzmy, że każdy e-mail tworzy prompt o około 1500 tokenów (instrukcje plus e-mail), a model zapisuje około 300 tokenów z powrotem. Jedno uruchomienie na DeepSeek-V4-Flash kosztuje $0.000053. Dla 1000 e-maili dziennie, oto wszystkie modele obok siebie z OpenRouter, wejście i wyjście liczone razem:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000042 | $0.042 | $0.0752 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000053 | $0.0525 | $0.147 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00012 | $0.12 | $1.44 |
1500 tokenów wejściowych i 300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Liczby tokenów to założenie dla tego przykładu; zmierz własne, wysyłając typowy e-mail przez sprawdzenie w Pythonie i odczytując usage, a następnie zastąp liczby. Aktualne ceny są na stronie cenowej.
Przepływ pracy w stylu czatu jest inny. Z węzłem pamięci cała historia podróżuje z każdym wywołaniem, więc wejście rośnie z każdą wiadomością. Dlaczego długi czat AI kosztuje więcej pokazuje, jak szybko to się sumuje.
Jeśli to nie działa#
Większość awarii to jedna z trzech rzeczy: klucz, adres lub identyfikator modelu. API 401 lub 404: zły klucz, base URL lub identyfikator modelu omawia każdy tekst błędu. Zanim go otworzysz, przejdź przez tę listę:
Lista kontrolna
Zanim zaczniesz dalej debugować
Chcesz zobaczyć resztę konfiguracji? Dokumentacja CheapTokens zawiera pełną referencję API, a strona DeepSeek wymienia limity modelu. Używasz już innego narzędzia z tym samym wzorcem? Open WebUI i LangChain łączą się w ten sam sposób: jeden adres, jeden klucz, jeden identyfikator modelu.


