Agents & AutomatisierungAnleitung
n8n mit CheapTokens verbinden: OpenAI-Credential, Base URL
Richte die OpenAI-Credential von n8n auf die CheapTokens-Base-URL aus, bestehe den Verbindungstest und betreibe eine LLM-Chain auf DeepSeek-V4-Flash.
Auf dieser Seite
Erstelle in n8n eine OpenAI-Credential, trage https:/ in das Feld Base URL ein, füge deinen CheapTokens-Key in API Key ein und wähle eine Modell-ID im Node OpenAI Chat Model. Das ist die ganze Änderung: kein Custom Node, kein Community-Paket. Bestehende Workflows behalten ihre Nodes und bekommen nur eine neue Credential.
Das funktioniert, weil die CheapTokens-API das OpenAI-Chat-Completions-Format spricht (und auch Anthropic Messages), sodass n8ns OpenAI-Node keinen Unterschied erkennen kann. Falls dir das Konzept einer "Base URL" neu ist, erklärt dieser Artikel es in zwei Minuten.
Was dir die n8n-Credential bietet#
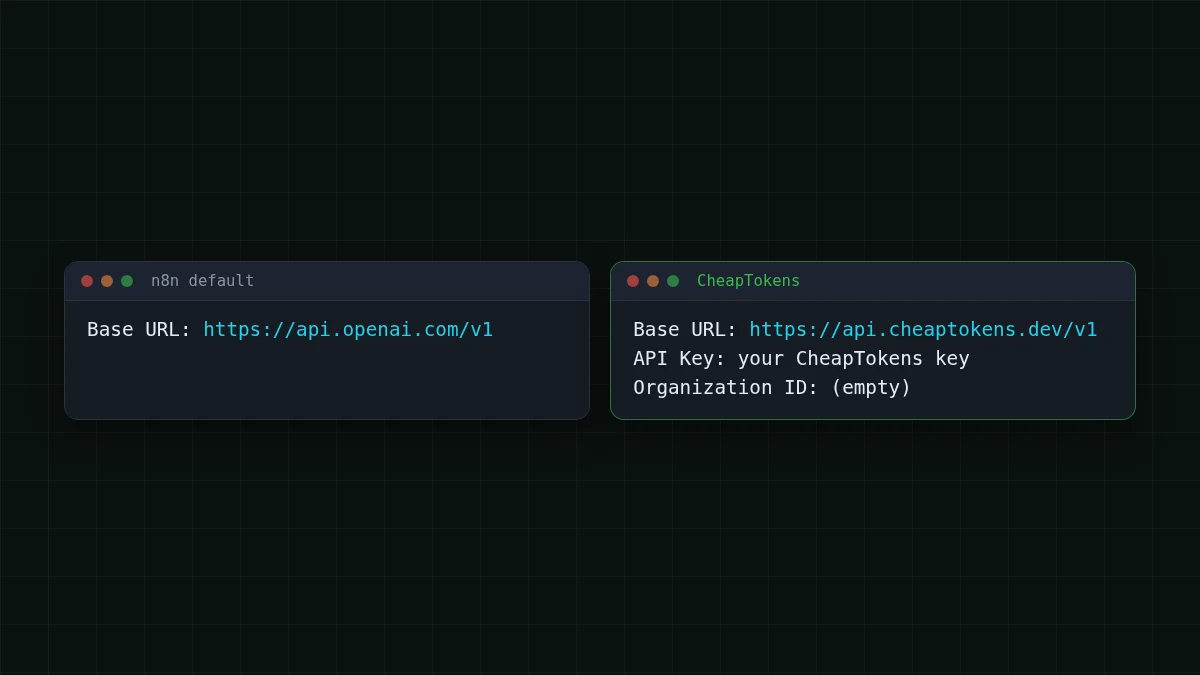
Die OpenAI-Credential von n8n hat vier Felder zum Ausfüllen. Laut dem Quellcode der Credential im n8n-Repository (Master-Branch, geprüft am 1. November 2026) sind das: API Key (erforderlich, maskiert), Organization ID (optional), Base URL (Standard https:/, beschrieben als Überschreibung der Basis-API-Adresse) und ein Schalter Add Custom Header mit Header-Name und -Wert.
Ein Detail, das du kennen solltest: Die eigene Doku-Seite von n8n für die OpenAI-Credential listet nur den Key und die Organization ID. Das Feld Base URL ist im Quellcode sichtbar, darauf stützt sich dieser Leitfaden.
Beim Speichern testet n8n die Credential, indem es eine Anfrage an {Base URL}/ mit einem Authorization: Bearer <API Key>-Header sendet. Eine falsche Base URL oder ein falscher Key zeigt sich also sofort, bevor du irgendetwas baust.
In vier Schritten einrichten#
Schritt für Schritt
n8n mit CheapTokens verbinden
Credential erstellen
Öffne in n8n Credentials, erstelle eine neue und wähle OpenAI. Bewahre deinen CheapTokens-Key in einem Passwort-Manager oder einer Umgebungsvariable auf, bis du ihn einfügst, niemals in einem Textfeld eines Workflows.
Zwei Felder ausfüllen
API Key: dein CheapTokens-Key. Base URL: https:/. Lass Organization ID leer. Speichere die Credential und warte auf den Verbindungstest: Er ruft /models unter dieser Adresse auf.
Modell-Node hinzufügen
Füge in einem Workflow eine Basic LLM Chain hinzu und hänge ein OpenAI Chat Model als ihr Modell an. Wähle die neue Credential. Verwende als Modell die ID aus der CheapTokens-Doku: deepseek-. Falls das Dropdown sie nicht auflistet, stelle das Feld so um, dass du die ID von Hand eingibst (per ID oder als Expression).
Chat Completions aktiviert lassen
Der Node nutzt standardmäßig die Chat-Completions-API. Lass Use Responses API ausgeschaltet. Setze in den Optionen des Nodes Maximum Number of Tokens, damit eine durchgehende Antwort nicht das Budget auffrisst.
Unsicher, was du als Modell-ID eintippen sollst? Frag die API selbst: Modelle mit GET /v1/models auflisten zeigt die exakten Strings. Verschiedene Anbieter benennen dasselbe Modell unterschiedlich, also kopiere die ID aus CheapTokens, nicht aus der Doku eines anderen Dienstes.
Prüfe den Key zuerst außerhalb von n8n#
Wenn der Credential-Test fehlschlägt, willst du wissen, ob das Problem bei n8n oder beim Key liegt. Eine kurze Terminal-Prüfung beantwortet das. Der Key liegt in einer Umgebungsvariable, sodass nichts Geheimes in deiner History landet.
Dieselbe Prüfung in curl und Python
curl
export CHEAPTOKENS_API_KEY="your-key-here"
curl https://api.cheaptokens.dev/v1/models \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY"
Das ist dieselbe Anfrage, die n8n beim Testen der Credential sendet. Eine JSON-Liste von Modellen bedeutet, dass Key und Adresse stimmen.
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Reply with one word: ready"}],
    max_tokens=20,
)
print(r.choices[0].message.content, r.usage)
Das ist eine vollständige Chat-Anfrage. r.usage zeigt Tokens rein und raus für diese winzige Anfrage; um einen Workflow zu dimensionieren, setze eine typische E-Mail in den Prompt und lies usage erneut.
Ein erster Workflow: eingehende E-Mails sortieren#
Angenommen, ein gemeinsames Postfach erhält etwa tausend E-Mails pro Tag. Du willst jede als billing, bug oder other taggen, plus eine einzeilige Zusammenfassung für die Person, die sie übernimmt.
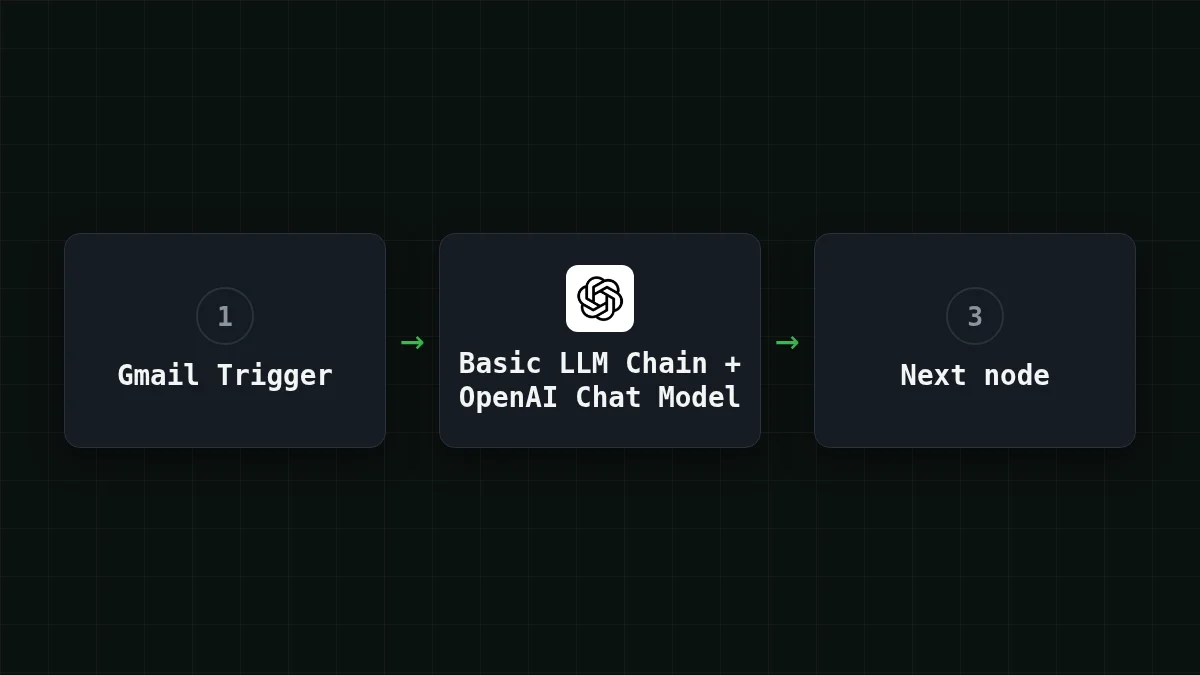
Baue es so: Ein Gmail Trigger (oder ein Webhook-Node) speist eine Basic LLM Chain. Der Prompt in der Chain lautet etwa "Klassifiziere diese E-Mail als billing, bug oder other und fasse sie dann in einem Satz zusammen", wobei der E-Mail-Text aus dem vorherigen Node eingefügt wird. Der Node OpenAI Chat Model darunter mit deiner CheapTokens-Credential erledigt das Denken.
Die Aufgabe ist kurz und repetitiv: eine kleine Eingabe, eine kleine Antwort, tausende identische Läufe. Genau dort zahlt sich ein günstiges Modell mit stabilem Preis am meisten aus. Für diese Art von Arbeit in CheapTokens liefert DeepSeek-V4-Flash einen Preis zu jeder Tageszeit, ein Kontextfenster von 380K und bis zu 32.768 Tokens pro Antwort.
Was ein Lauf kostet#
Angenommen, jede E-Mail erzeugt einen Prompt von etwa 1.500 Tokens (Anweisungen plus die E-Mail) und das Modell schreibt etwa 300 Tokens zurück. Ein Lauf auf DeepSeek-V4-Flash kostet $0.000053. Für 1.000 E-Mails pro Tag sind hier alle Modelle nebeneinander mit OpenRouter, Input und Output zusammengezählt:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000042 | $0.042 | $0.0752 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000053 | $0.0525 | $0.147 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00012 | $0.12 | $1.44 |
1.500 Input- und 300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Token-Zahlen sind eine Annahme für dieses Beispiel; miss deine eigenen, indem du eine typische E-Mail durch die Python-Prüfung schickst und usage liest, und ersetze dann die Zahlen. Aktuelle Preise stehen auf der Preisseite.
Ein Chat-Workflow ist anders. Mit einem Memory-Node reist die gesamte Historie bei jedem Aufruf mit, sodass der Input mit jeder Nachricht wächst. Warum ein langer KI-Chat mehr kostet zeigt, wie schnell sich das summiert.
Wenn es nicht funktioniert#
Die meisten Fehler sind eines von drei Dingen: der Key, die Adresse oder die Modell-ID. API 401 oder 404: falscher Key, falsche Base URL oder falsche Modell-ID geht jeden Fehlertext durch. Bevor du ihn öffnest, geh diese Liste durch:
Checkliste
Bevor du weiter debuggst
Willst du den Rest des Setups sehen? Die CheapTokens-Doku enthält die vollständige API-Referenz, und die DeepSeek-Seite listet die Limits des Modells. Nutzt du bereits ein anderes Tool mit demselben Muster? Open WebUI und LangChain verbinden sich genauso: eine Adresse, ein Key, eine Modell-ID.


