Ikonekta ang n8n sa CheapTokens: OpenAI credential, Base URL
Ituro ang OpenAI credential ng n8n sa CheapTokens Base URL, pumasa sa connection test at magpatakbo ng LLM chain sa DeepSeek-V4-Flash.
Sa pahinang ito
Sa n8n, gumawa ng OpenAI credential, ilagay ang https:/ sa Base URL field nito, i-paste ang iyong CheapTokens key sa API Key, at pumili ng model id sa OpenAI Chat Model node. Iyon lang ang buong pagbabago: walang custom node, walang community package. Ang mga existing workflow ay nananatili ang mga node at makakakuha lang ng bagong credential.
Gumagana ito dahil ang CheapTokens API ay nagsasalita ng OpenAI Chat Completions format (at Anthropic Messages din), kaya hindi matutukoy ng OpenAI node ng n8n ang pagkakaiba. Kung bago sa iyo ang ideya ng "base URL", saklaw ito ng explainer na ito sa loob ng dalawang minuto.
Ano ang ibinibigay ng n8n credential#
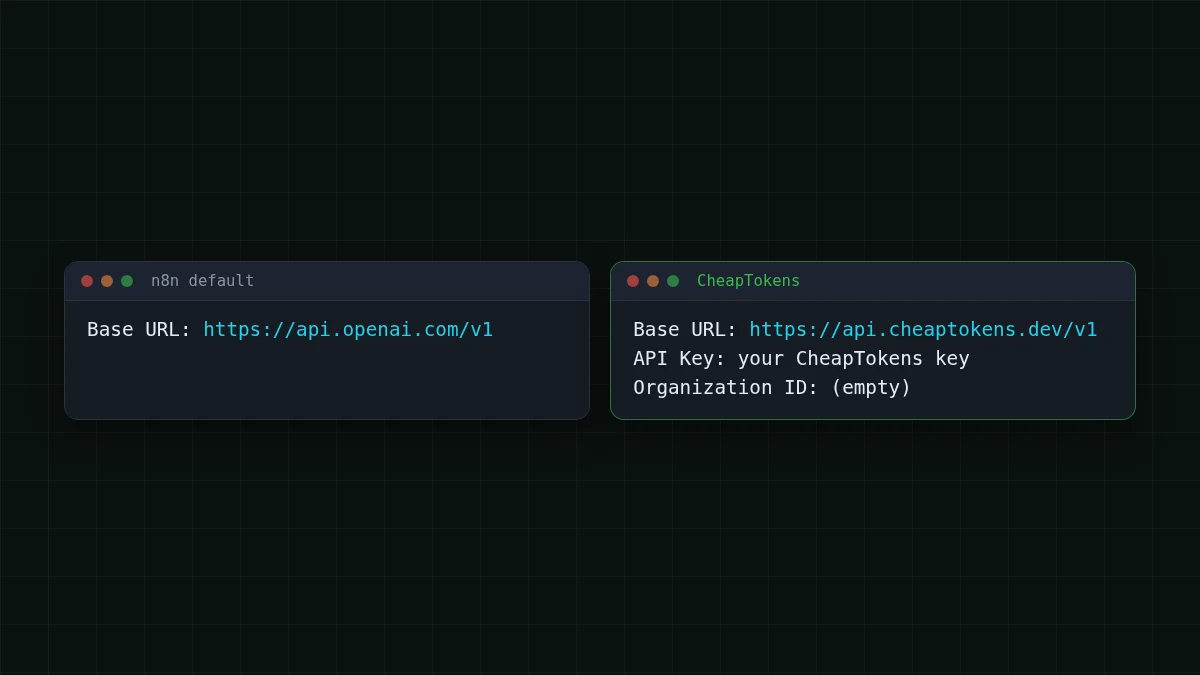
Ang OpenAI credential ng n8n ay may apat na dapat punan. Ayon sa source code ng credential sa n8n repository (master branch, sinuri noong 1 Nobyembre 2026), ito ay: API Key (required, masked), Organization ID (optional), Base URL (default https:/, inilalarawan bilang nag-o-override sa base API address) at isang Add Custom Header switch na may header name at value.
Isang detalyeng dapat malaman: ang docs page mismo ng n8n para sa OpenAI credential ay naglilista lamang ng key at organization ID. Ang Base URL field ay makikita sa source code, kaya iyon ang pinagbabasehan ng gabay na ito.
Kapag nag-save ka, sinusubukan ng n8n ang credential sa pamamagitan ng pagpapadala ng request sa {Base URL}/ na may Authorization: Bearer <API Key> header. Kaya ang maling Base URL o maling key ay lumalabas agad doon, bago ka pa magtayo ng kahit ano.
I-set up ito sa apat na hakbang#
Hakbang-hakbang
Ikonekta ang n8n sa CheapTokens
Gumawa ng credential
Sa n8n buksan ang Credentials, gumawa ng bago at piliin ang OpenAI. Itago ang iyong CheapTokens key sa password manager o environment variable hanggang sa i-paste mo ito, huwag kailanman sa text field ng workflow.
Punan ang dalawang field
API Key: ang iyong CheapTokens key. Base URL: https:/. Iwanang walang laman ang Organization ID. I-save ang credential at hintayin ang connection test: tinatawagan nito ang /models sa address na iyon.
Idagdag ang model node
Sa isang workflow magdagdag ng Basic LLM Chain at ikabit ang OpenAI Chat Model bilang model nito. Piliin ang bagong credential. Para sa model, gamitin ang id mula sa CheapTokens docs: deepseek-. Kung hindi ito nakalista sa dropdown, ilipat ang field para mano-manong ilagay ang id (sa pamamagitan ng ID o bilang expression).
Panatilihing naka-on ang Chat Completions
Ginagamit ng node ang Chat Completions API bilang default. Iwanang naka-off ang Use Responses API. Sa options ng node itakda ang Maximum Number of Tokens para hindi maubos ng tumatakas na sagot ang budget.
Hindi sigurado kung ano ang ita-type bilang model id? Tanungin ang API mismo: Ilista ang mga model gamit ang GET /v1/models ay nagpapakita ng eksaktong mga string. Iba-iba ang pangalan ng parehong model sa iba't ibang provider, kaya kopyahin ang id mula sa CheapTokens, hindi mula sa docs ng ibang serbisyo.
Suriin muna ang key sa labas ng n8n#
Kung nabigo ang credential test, gusto mong malaman kung ang problema ay ang n8n o ang key. Sinasagot iyon ng maikling terminal check. Nasa environment variable ang key, kaya walang secret na napupunta sa history mo.
Ang parehong check sa curl at Python
curl
export CHEAPTOKENS_API_KEY="your-key-here"
curl https://api.cheaptokens.dev/v1/models \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY"
Ito ang parehong request na ipinapadala ng n8n kapag sinusubukan nito ang credential. Ang JSON list ng mga model ay nangangahulugang tama ang key at ang address.
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Reply with one word: ready"}],
    max_tokens=20,
)
print(r.choices[0].message.content, r.usage)
Ito ay isang buong chat request. Ipinapakita ng r.usage ang tokens in at out para sa maliit na request na ito; para sukatin ang isang workflow, ilagay ang karaniwang email sa prompt at basahin muli ang usage.
Isang unang workflow: pag-uuri ng mga papasok na email#
Sabihin nating ang isang shared inbox ay tumatanggap ng mga isang libong email kada araw. Gusto mong ma-tag ang bawat isa bilang billing, bug o other, kasama ang isang linyang buod para sa taong kukuha nito.
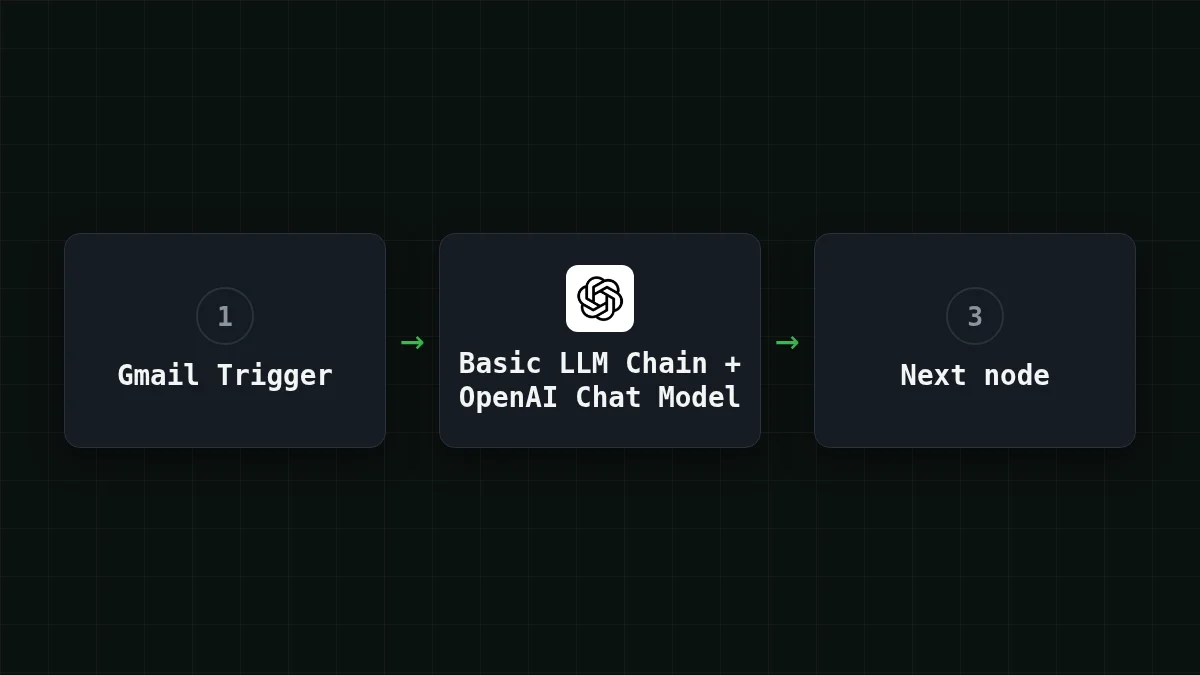
Buuin ito nang ganito: isang Gmail Trigger (o isang Webhook node) ang nagpapakain sa isang Basic LLM Chain. Ang prompt sa chain ay nagbabasa ng tulad ng "Classify this email as billing, bug or other, then summarise it in one sentence", kasama ang email body na ipinasok mula sa nakaraang node. Ang OpenAI Chat Model node sa ilalim nito, kasama ang iyong CheapTokens credential, ang gumagawa ng pag-iisip.
Maikli at paulit-ulit ang trabaho: maliit na input, maliit na sagot, libu-libong magkakatulad na run. Doon pinakamalaki ang pakinabang ng murang model na may stable na presyo. Para sa ganitong uri ng trabaho sa CheapTokens, ang DeepSeek-V4-Flash ay nagbibigay sa iyo ng isang presyo sa anumang oras ng araw, 380K context window at hanggang 32,768 tokens bawat sagot.
Magkano ang isang run#
Sabihin nating ang bawat email ay gumagawa ng prompt na mga 1,500 tokens (mga instruksyon kasama ang email) at ang model ay nagsusulat ng mga 300 tokens pabalik. Ang isang run sa DeepSeek-V4-Flash ay nagkakahalaga ng $0.000053. Para sa 1,000 email kada araw, narito ang lahat ng model nang magkatabi kasama ang OpenRouter, input at output na binibilang nang magkasama:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000042 | $0.042 | $0.0752 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000053 | $0.0525 | $0.147 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00012 | $0.12 | $1.44 |
1,500 input at 300 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Ang mga token count ay isang assumption para sa halimbawang ito; sukatin ang sarili mo sa pamamagitan ng pagpapadala ng karaniwang email sa Python check at pagbabasa ng usage, pagkatapos palitan ang mga numero. Ang kasalukuyang presyo ay nasa pricing page.
Iba ang isang chat-style workflow. Sa isang memory node, ang buong history ay naglalakbay sa bawat call, kaya lumalaki ang input sa bawat mensahe. Ipinapakita ng Bakit mas mahal ang mahabang AI chat kung gaano kabilis itong dumadagdag.
Kung hindi ito gumana#
Karamihan ng failure ay isa sa tatlong bagay: ang key, ang address o ang model id. Ang API 401 o 404: maling key, base URL o model id ay dumadaan sa bawat error text. Bago mo ito buksan, dumaan sa listahang ito:
Listahan ng dapat gawin
Bago ka mag-debug pa
Gusto mong makita ang natitirang setup? Ang CheapTokens docs ay may buong API reference, at ang DeepSeek page ay naglilista ng mga limitasyon ng model. Gumagamit ka na ba ng ibang tool na may parehong pattern? Ang Open WebUI at LangChain ay kumokonekta sa parehong paraan: isang address, isang key, isang model id.


