将 n8n 连接到 CheapTokens:OpenAI 凭据、Base URL
将 n8n 的 OpenAI 凭据指向 CheapTokens Base URL,通过连接测试,并在 DeepSeek-V4-Flash 上运行 LLM 链。
在 n8n 中,创建一个 OpenAI 凭据,将 https:/ 填入其 Base URL 字段,将你的 CheapTokens 密钥粘贴到 API Key,并在 OpenAI Chat Model 节点中选择一个模型 id。这就是全部改动:无需自定义节点,无需社区包。现有工作流保留其节点,只是获得一个新凭据。
这之所以可行,是因为 CheapTokens API 使用 OpenAI Chat Completions 格式(也支持 Anthropic Messages),因此 n8n 的 OpenAI 节点无法分辨差异。如果“base URL”这个概念对你来说很陌生,这篇说明用两分钟就能讲清楚。
n8n 凭据为你提供什么#
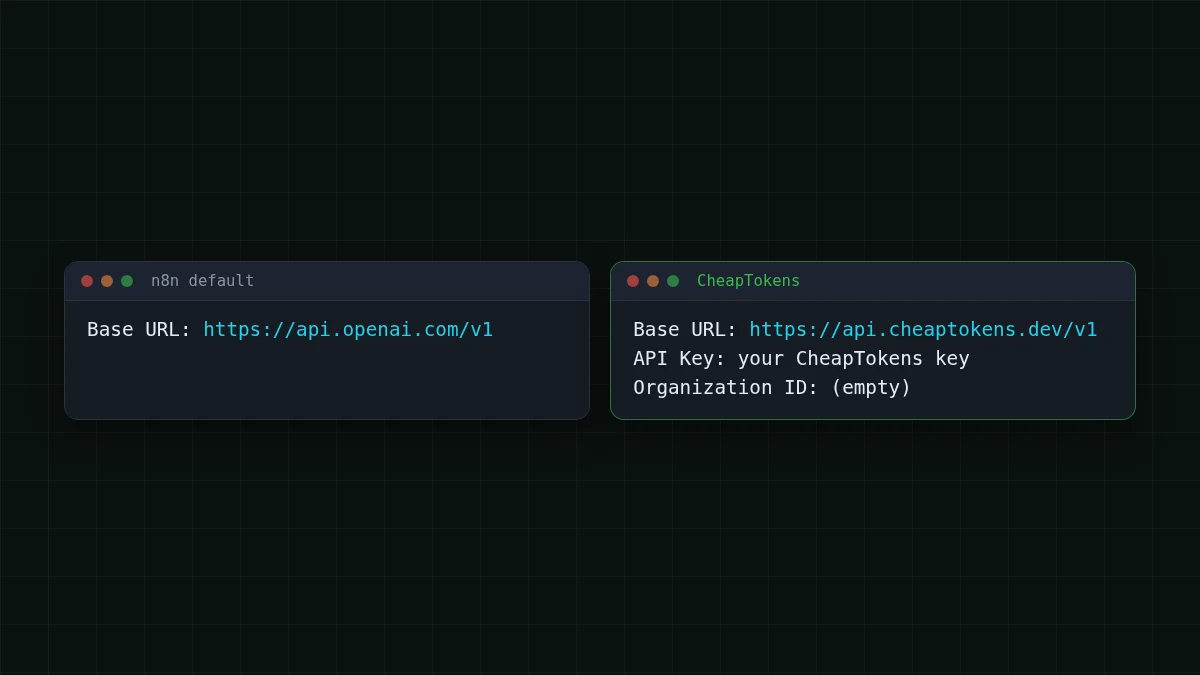
n8n 的 OpenAI 凭据有四项需要填写。根据 n8n 仓库中该凭据的源代码(master 分支,检查于 2026 年 11 月 1 日),它们是:API Key(必填,掩码显示)、Organization ID(可选)、Base URL(默认 https:/,描述为覆盖基础 API 地址)以及一个 Add Custom Header 开关,带有标头名称和值。
一个值得了解的细节:n8n 自己的 OpenAI 凭据文档页面只列出了密钥和组织 ID。Base URL 字段在源代码中可见,因此本指南依赖它。
保存时,n8n 会通过向 {Base URL}/ 发送带有 Authorization: Bearer <API Key> 标头的请求来测试凭据。因此,错误的 Base URL 或错误的密钥会立即显现,在你构建任何东西之前。
四步完成设置#
分步操作
将 n8n 连接到 CheapTokens
创建凭据
在 n8n 中打开 Credentials,创建一个新凭据并选择 OpenAI。在粘贴之前,将你的 CheapTokens 密钥保存在密码管理器或环境变量中,绝不要放在工作流的文本字段中。
填写两个字段
API Key:你的 CheapTokens 密钥。Base URL:https:/。将 Organization ID 留空。保存凭据并等待连接测试:它会调用该地址上的 /models。
添加模型节点
在工作流中添加一个 Basic LLM Chain,并附加一个 OpenAI Chat Model 作为其模型。选择新凭据。对于模型,使用 CheapTokens 文档中的 id:deepseek-。如果下拉列表未列出它,请将字段切换为手动输入 id(按 ID 或作为表达式)。
保持 Chat Completions 开启
该节点默认使用 Chat Completions API。保持 Use Responses API 关闭。在节点选项中设置 Maximum Number of Tokens,这样失控的回答就不会耗尽预算。
不确定模型 id 该输入什么?直接问 API 本身:使用 GET /v1/models 列出模型会显示确切的字符串。不同提供商对同一模型的命名不同,因此请从 CheapTokens 复制 id,而不是从其他服务的文档中复制。
先在 n8n 外部检查密钥#
如果凭据测试失败,你想知道问题出在 n8n 还是密钥上。一个简短的终端检查可以回答这个问题。密钥位于环境变量中,因此不会有任何机密落入你的历史记录。
在 curl 和 Python 中进行同样的检查
curl
export CHEAPTOKENS_API_KEY="your-key-here"
curl https://api.cheaptokens.dev/v1/models \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY"
这与 n8n 测试凭据时发送的请求相同。返回 JSON 模型列表意味着密钥和地址正确。
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Reply with one word: ready"}],
    max_tokens=20,
)
print(r.choices[0].message.content, r.usage)这是一个完整的聊天请求。r.usage 显示了这个微小请求的输入和输出 token 数;要估算工作流规模,请将一封典型邮件放入提示中,并再次读取 usage。
第一个工作流:对收到的邮件进行分类#
假设一个共享收件箱每天收到约一千封邮件。你希望每封邮件都被标记为 billing、bug 或 other,并为接手的人提供一行摘要。
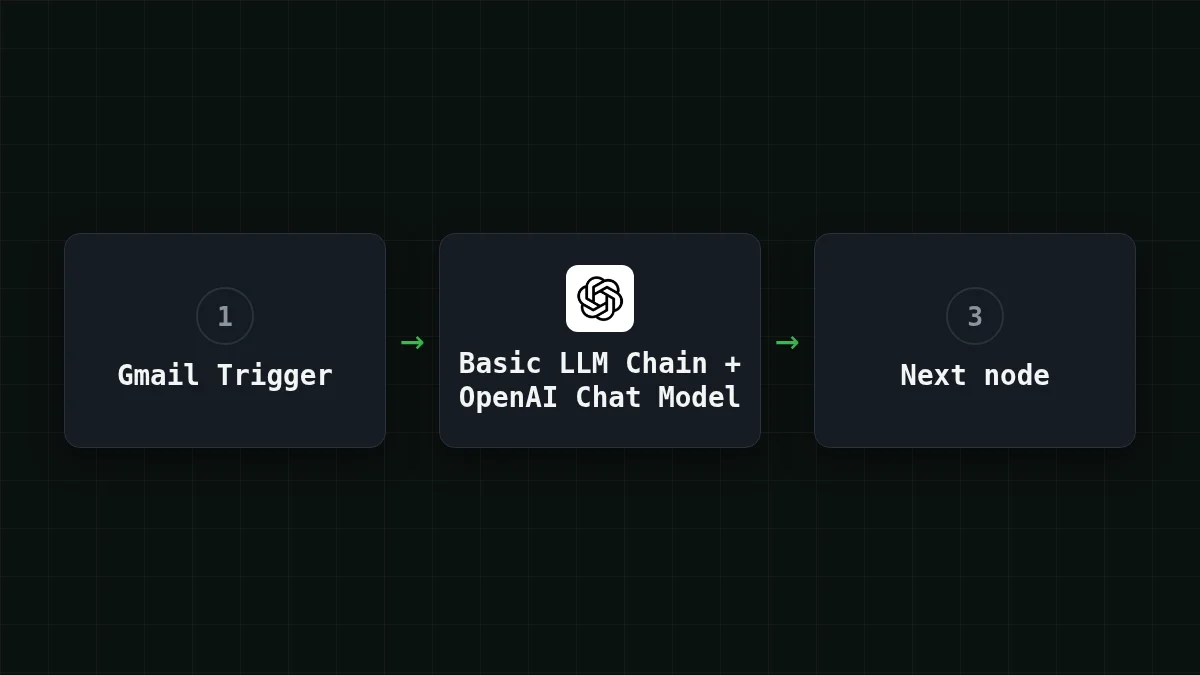
这样构建:一个 Gmail Trigger(或 Webhook 节点)输入到一个 Basic LLM Chain。链中的提示大致为“将这封邮件分类为 billing、bug 或 other,然后用一句话总结”,邮件正文从前一个节点插入。其下方的 OpenAI Chat Model 节点,使用你的 CheapTokens 凭据,完成思考。
这项工作简短且重复:小输入、小答案、数千次相同的运行。这正是价格稳定的廉价模型最能发挥价值的地方。对于 CheapTokens 中的这类工作,DeepSeek-V4-Flash 在任何时段都提供一个价格、380K 上下文窗口,每次回答最多 32,768 个 token。
一次运行的成本#
假设每封邮件产生约 1,500 个 token 的提示(指令加邮件),模型写回约 300 个 token。在 DeepSeek-V4-Flash 上运行一次的成本为 $0.000053。对于每天 1,000 封邮件,以下是所有模型与 OpenRouter 的并排对比,输入和输出合计计算:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000042 | $0.042 | $0.0752 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000053 | $0.0525 | $0.147 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00012 | $0.12 | $1.44 |
每次请求 1,500 个输入 token 和 300 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
token 数是本示例的假设;通过 Python 检查发送一封典型邮件并读取 usage 来测量你自己的数据,然后替换数字。当前价格在定价页面上。
聊天式工作流则不同。使用记忆节点时,整个历史记录会随每次调用传输,因此输入会随着每条消息增长。为什么长 AI 聊天成本更高展示了这有多快累积。
如果它不工作#
大多数失败是以下三种之一:密钥、地址或模型 id。API 401 或 404:错误的密钥、base URL 或模型 id逐一介绍了每种错误文本。在打开它之前,请先过一遍这个清单:
清单
在进一步调试之前
想看看设置的其余部分?CheapTokens 文档有完整的 API 参考,DeepSeek 页面列出了模型的限制。已经使用其他工具且模式相同?Open WebUI和 LangChain以相同方式连接:一个地址、一个密钥、一个模型 id。


