Conecte o n8n à CheapTokens: credencial OpenAI, Base URL
Aponte a credencial OpenAI do n8n para a Base URL da CheapTokens, passe no teste de conexão e execute uma chain LLM no DeepSeek-V4-Flash.
Nesta página
No n8n, crie uma credencial OpenAI, coloque https:/ no campo Base URL, cole sua chave CheapTokens em API Key e escolha um id de modelo no nó OpenAI Chat Model. Essa é toda a mudança: sem nó personalizado, sem pacote da comunidade. Os workflows existentes mantêm seus nós e só recebem uma nova credencial.
Isso funciona porque a API CheapTokens fala o formato OpenAI Chat Completions (e Anthropic Messages também), então o nó OpenAI do n8n não consegue notar a diferença. Se a ideia de "base URL" é nova para você, este explicador cobre isso em dois minutos.
O que a credencial do n8n oferece#
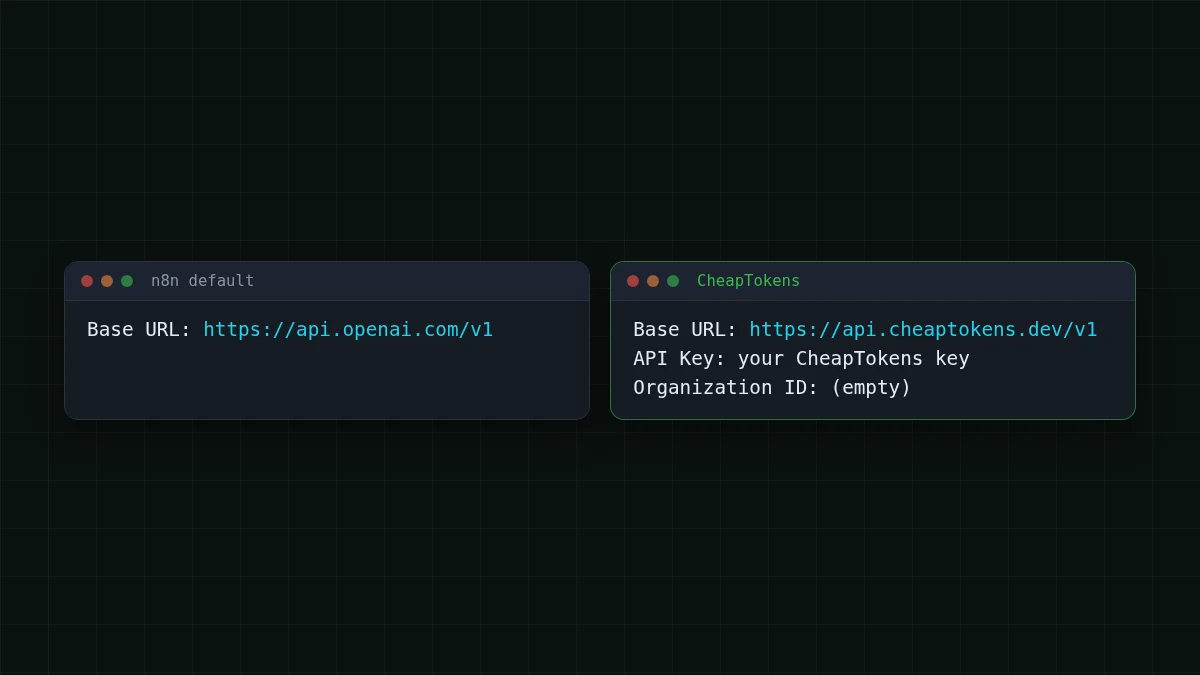
A credencial OpenAI do n8n tem quatro coisas para preencher. Segundo o código-fonte da credencial no repositório do n8n (branch master, verificado em 1 de novembro de 2026), são: API Key (obrigatória, mascarada), Organization ID (opcional), Base URL (padrão https:/, descrita como substituindo o endereço base da API) e um switch Add Custom Header com nome e valor de cabeçalho.
Um detalhe que vale saber: a própria página de docs do n8n para a credencial OpenAI lista apenas a chave e o organization ID. O campo Base URL é visível no código-fonte, então é nele que este guia se baseia.
Ao salvar, o n8n testa a credencial enviando uma requisição para {Base URL}/ com um cabeçalho Authorization: Bearer <API Key>. Assim, uma Base URL errada ou uma chave errada aparece ali mesmo, antes de você construir qualquer coisa.
Configure em quatro passos#
Passo a passo
Conecte o n8n à CheapTokens
Crie a credencial
No n8n, abra Credentials, crie uma nova e escolha OpenAI. Mantenha sua chave CheapTokens em um gerenciador de senhas ou variável de ambiente até colá-la, nunca no campo de texto de um workflow.
Preencha dois campos
API Key: sua chave CheapTokens. Base URL: https:/. Deixe Organization ID vazio. Salve a credencial e aguarde o teste de conexão: ele chama /models nesse endereço.
Adicione o nó de modelo
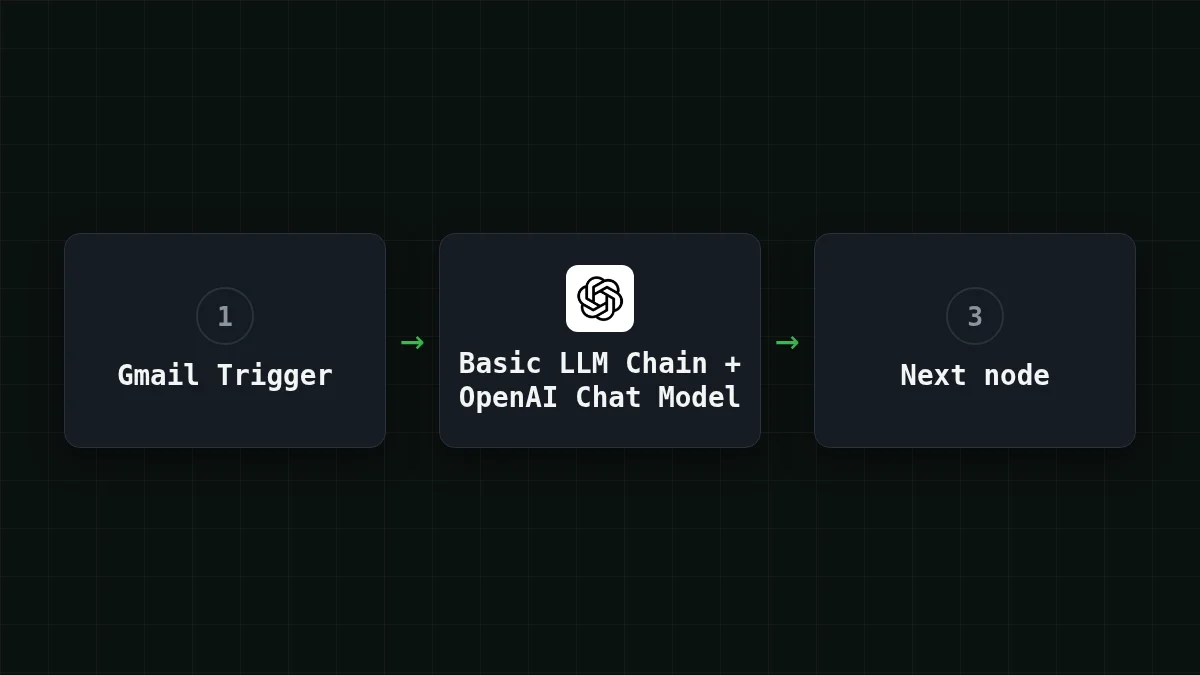
Em um workflow, adicione um Basic LLM Chain e anexe um OpenAI Chat Model como modelo. Selecione a nova credencial. Para o modelo, use o id da documentação da CheapTokens: deepseek-. Se o dropdown não o listar, mude o campo para inserir o id manualmente (por ID ou como expressão).
Mantenha o Chat Completions ativado
O nó usa a API Chat Completions por padrão. Deixe Use Responses API desligado. Nas opções do nó, defina Maximum Number of Tokens para que uma resposta descontrolada não consuma o orçamento.
Não sabe o que digitar como id de modelo? Pergunte à própria API: Listar modelos com GET /v1/models mostra as strings exatas. Provedores diferentes nomeiam o mesmo modelo de formas diferentes, então copie o id da CheapTokens, não da documentação de outro serviço.
Verifique a chave fora do n8n primeiro#
Se o teste da credencial falhar, você quer saber se o problema é o n8n ou a chave. Uma verificação rápida no terminal responde isso. A chave fica em uma variável de ambiente, então nada secreto vai para o seu histórico.
A mesma verificação em curl e Python
curl
export CHEAPTOKENS_API_KEY="your-key-here"
curl https://api.cheaptokens.dev/v1/models \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY"
Esta é a mesma requisição que o n8n envia ao testar a credencial. Uma lista JSON de modelos significa que a chave e o endereço estão corretos.
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Reply with one word: ready"}],
    max_tokens=20,
)
print(r.choices[0].message.content, r.usage)
Esta é uma requisição de chat completa. r.usage mostra tokens de entrada e saída para esta requisição pequena; para dimensionar um workflow, coloque um e-mail típico no prompt e leia usage novamente.
Um primeiro workflow: classificando e-mails recebidos#
Digamos que uma caixa de entrada compartilhada receba cerca de mil e-mails por dia. Você quer cada um marcado como billing, bug ou other, além de um resumo de uma linha para quem for tratá-lo.
Monte assim: um Gmail Trigger (ou um nó Webhook) alimenta um Basic LLM Chain. O prompt na chain diz algo como "Classifique este e-mail como billing, bug ou other, depois resuma em uma frase", com o corpo do e-mail inserido a partir do nó anterior. O nó OpenAI Chat Model abaixo dele, com sua credencial CheapTokens, faz o raciocínio.
A tarefa é curta e repetitiva: uma entrada pequena, uma resposta pequena, milhares de execuções idênticas. É aí que um modelo barato com preço estável compensa mais. Para esse tipo de trabalho na CheapTokens, o DeepSeek-V4-Flash oferece um preço único em qualquer hora do dia, janela de contexto de 380K e até 32.768 tokens por resposta.
Quanto custa uma execução#
Digamos que cada e-mail gere um prompt de cerca de 1.500 tokens (instruções mais o e-mail) e o modelo escreva cerca de 300 tokens de volta. Uma execução no DeepSeek-V4-Flash custa $0.000053. Para 1.000 e-mails por dia, aqui estão todos os modelos lado a lado com OpenRouter, entrada e saída contadas juntas:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000042 | $0.042 | $0.0752 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000053 | $0.0525 | $0.147 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00012 | $0.12 | $1.44 |
1.500 tokens de entrada e 300 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
As contagens de tokens são uma suposição para este exemplo; meça as suas enviando um e-mail típico pela verificação em Python e lendo usage, depois substitua os números. Os preços atuais estão na página de preços.
Um workflow de chat é diferente. Com um nó de memória, todo o histórico viaja em cada chamada, então a entrada cresce a cada mensagem. Por que um chat de IA longo custa mais mostra como isso se acumula rápido.
Se não funcionar#
A maioria das falhas é uma de três coisas: a chave, o endereço ou o id do modelo. API 401 ou 404: chave, base URL ou id de modelo errados percorre cada texto de erro. Antes de abrir, passe por esta lista:
Lista de verificação
Antes de depurar mais
Quer ver o resto da configuração? A documentação da CheapTokens tem a referência completa da API, e a página do DeepSeek lista os limites do modelo. Já usa outra ferramenta com o mesmo padrão? Open WebUI e LangChain conectam da mesma forma: um endereço, uma chave, um id de modelo.


