Agenti e automazioneGuida
Collega n8n a CheapTokens: credenziale OpenAI, Base URL
Punta la credenziale OpenAI di n8n al Base URL di CheapTokens, supera il test di connessione ed esegui una LLM chain su DeepSeek-V4-Flash.
In questa pagina
In n8n, crea una credenziale OpenAI, inserisci https:/ nel campo Base URL, incolla la tua chiave CheapTokens in API Key e scegli un id modello nel nodo OpenAI Chat Model. Tutto qui: nessun nodo personalizzato, nessun pacchetto della community. I workflow esistenti mantengono i loro nodi e ricevono solo una nuova credenziale.
Funziona perché l'API CheapTokens parla il formato OpenAI Chat Completions (e anche Anthropic Messages), quindi il nodo OpenAI di n8n non può notare la differenza. Se l'idea di "base URL" è nuova per te, questa spiegazione la copre in due minuti.
Cosa ti offre la credenziale n8n#
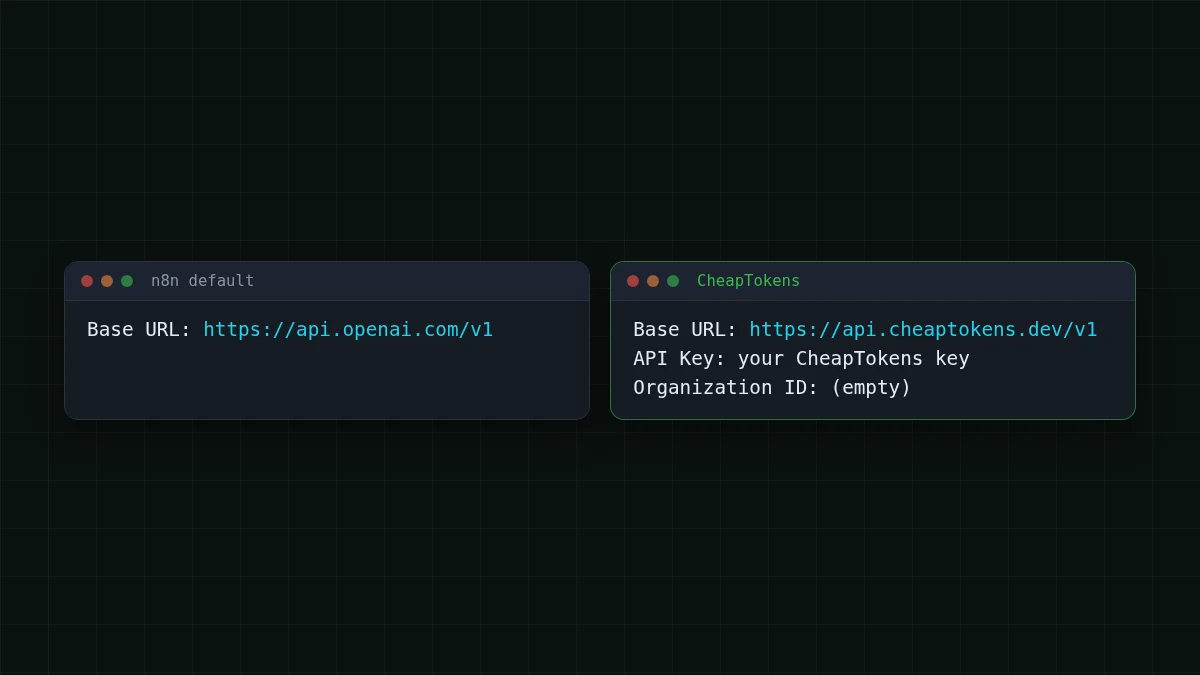
La credenziale OpenAI di n8n ha quattro cose da compilare. Secondo il codice sorgente della credenziale nel repository n8n (branch master, verificato il 1 novembre 2026), sono: API Key (obbligatoria, mascherata), Organization ID (opzionale), Base URL (predefinito https:/, descritto come override dell'indirizzo base dell'API) e un interruttore Add Custom Header con nome e valore dell'header.
Un dettaglio da sapere: la pagina della documentazione ufficiale di n8n per la credenziale OpenAI elenca solo la chiave e l'organization ID. Il campo Base URL è visibile nel codice sorgente, quindi è su quello che si basa questa guida.
Quando salvi, n8n testa la credenziale inviando una richiesta a {Base URL}/ con un header Authorization: Bearer <API Key>. Quindi un Base URL sbagliato o una chiave errata emergono subito, prima che tu costruisca qualsiasi cosa.
Configuralo in quattro passaggi#
Passo dopo passo
Collega n8n a CheapTokens
Crea la credenziale
In n8n apri Credentials, creane una nuova e scegli OpenAI. Tieni la tua chiave CheapTokens in un password manager o in una variabile d'ambiente finché non la incolli, mai nel campo di testo di un workflow.
Compila due campi
API Key: la tua chiave CheapTokens. Base URL: https:/. Lascia Organization ID vuoto. Salva la credenziale e attendi il test di connessione: chiama /models su quell'indirizzo.
Aggiungi il nodo del modello
In un workflow aggiungi una Basic LLM Chain e allega un OpenAI Chat Model come suo modello. Seleziona la nuova credenziale. Per il modello, usa l'id dalla documentazione CheapTokens: deepseek-. Se il menu a tendina non lo elenca, passa il campo alla modalità di inserimento manuale dell'id (by ID o come espressione).
Mantieni attive le Chat Completions
Il nodo usa l'API Chat Completions per impostazione predefinita. Lascia Use Responses API disattivato. Nelle opzioni del nodo imposta Maximum Number of Tokens così una risposta fuori controllo non può consumare il budget.
Non sai cosa digitare come id modello? Chiedilo all'API stessa: Elenca i modelli con GET /v1/models mostra le stringhe esatte. Provider diversi nominano lo stesso modello in modo diverso, quindi copia l'id da CheapTokens, non dalla documentazione di un altro servizio.
Verifica prima la chiave fuori da n8n#
Se il test della credenziale fallisce, vuoi sapere se il problema è n8n o la chiave. Un breve controllo da terminale risponde. La chiave sta in una variabile d'ambiente, così nulla di segreto finisce nella cronologia.
Lo stesso controllo in curl e Python
curl
export CHEAPTOKENS_API_KEY="your-key-here"
curl https://api.cheaptokens.dev/v1/models \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY"
Questa è la stessa richiesta che n8n invia quando testa la credenziale. Un elenco JSON di modelli significa che la chiave e l'indirizzo sono corretti.
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Reply with one word: ready"}],
    max_tokens=20,
)
print(r.choices[0].message.content, r.usage)
Questa è una richiesta chat completa. r.usage mostra i token in ingresso e in uscita per questa piccola richiesta; per dimensionare un workflow, inserisci un'email tipica nel prompt e leggi di nuovo usage.
Un primo workflow: smistare le email in arrivo#
Supponiamo che una casella condivisa riceva circa mille email al giorno. Vuoi che ognuna sia etichettata come billing, bug o other, più un riassunto di una riga per chi la prende in carico.
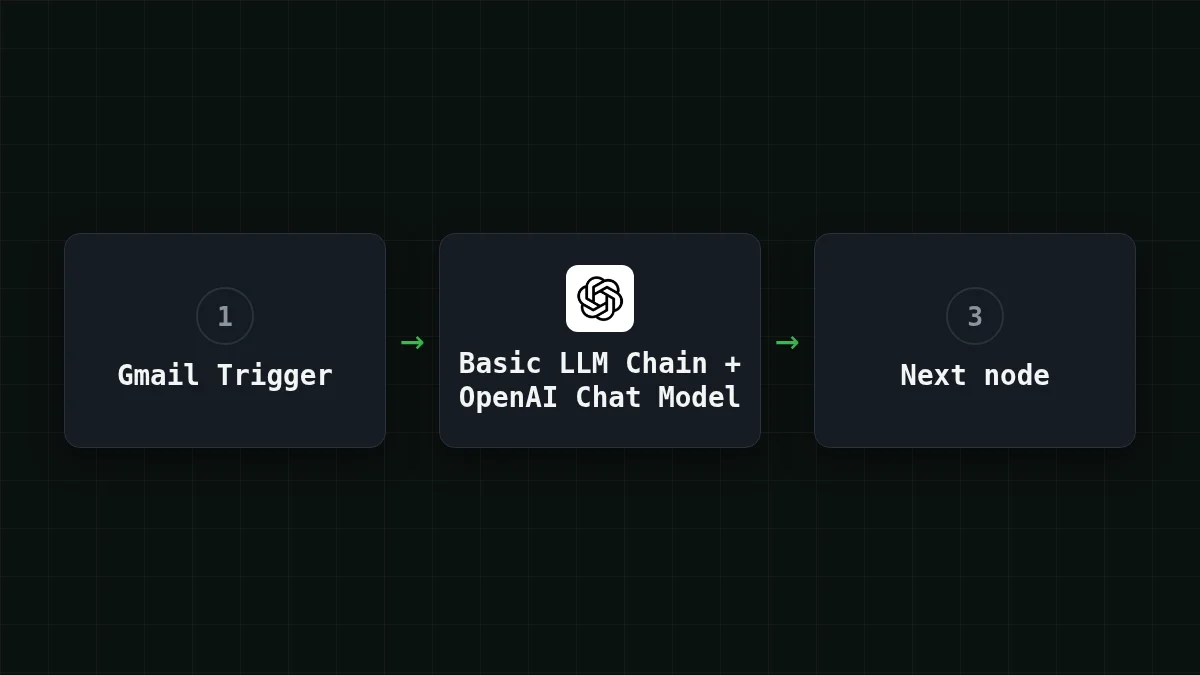
Costruiscilo così: un Gmail Trigger (o un nodo Webhook) alimenta una Basic LLM Chain. Il prompt nella chain dice qualcosa come "Classifica questa email come billing, bug o other, poi riassumila in una frase", con il corpo dell'email inserito dal nodo precedente. Il nodo OpenAI Chat Model sotto di esso, con la tua credenziale CheapTokens, fa il ragionamento.
Il lavoro è breve e ripetitivo: un piccolo input, una piccola risposta, migliaia di esecuzioni identiche. È qui che un modello economico con un prezzo stabile rende di più. Per questo tipo di lavoro in CheapTokens, DeepSeek-V4-Flash ti dà un unico prezzo a qualsiasi ora del giorno, una finestra di contesto di 380K e fino a 32.768 token per risposta.
Quanto costa un'esecuzione#
Supponiamo che ogni email produca un prompt di circa 1.500 token (istruzioni più email) e che il modello scriva circa 300 token in risposta. Un'esecuzione su DeepSeek-V4-Flash costa $0.000053. Per 1.000 email al giorno, ecco tutti i modelli affiancati con OpenRouter, input e output contati insieme:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000042 | $0.042 | $0.0752 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000053 | $0.0525 | $0.147 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00012 | $0.12 | $1.44 |
1500 token di input e 300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
I conteggi dei token sono un'ipotesi per questo esempio; misura i tuoi inviando un'email tipica attraverso il controllo Python e leggendo usage, poi sostituisci i numeri. I prezzi attuali sono sulla pagina dei prezzi.
Un workflow in stile chat è diverso. Con un nodo di memoria, l'intera cronologia viaggia con ogni chiamata, quindi l'input cresce a ogni messaggio. Perché una lunga chat AI costa di più mostra quanto in fretta si accumula.
Se non funziona#
La maggior parte dei fallimenti è una di tre cose: la chiave, l'indirizzo o l'id modello. API 401 o 404: chiave, base URL o id modello sbagliati analizza ogni testo di errore. Prima di aprirlo, scorri questa lista:
Lista di controllo
Prima di fare altri debug
Vuoi vedere il resto della configurazione? La documentazione CheapTokens ha il riferimento completo dell'API, e la pagina DeepSeek elenca i limiti del modello. Usi già un altro strumento con lo stesso schema? Open WebUI e LangChain si collegano allo stesso modo: un indirizzo, una chiave, un id modello.


