Conecta n8n a CheapTokens: credencial de OpenAI, Base URL
Apunta la credencial de OpenAI de n8n a la Base URL de CheapTokens, pasa la prueba de conexión y ejecuta una cadena LLM en DeepSeek-V4-Flash.
En esta página
En n8n, crea una credencial de OpenAI, pon https:/ en su campo Base URL, pega tu clave de CheapTokens en API Key y elige un id de modelo en el nodo OpenAI Chat Model. Ese es todo el cambio: sin nodo personalizado, sin paquete de la comunidad. Los flujos de trabajo existentes conservan sus nodos y solo obtienen una credencial nueva.
Esto funciona porque la API de CheapTokens habla el formato OpenAI Chat Completions (y también Anthropic Messages), así que el nodo OpenAI de n8n no nota la diferencia. Si la idea de una "base URL" es nueva para ti, esta explicación la cubre en dos minutos.
Qué te da la credencial de n8n#
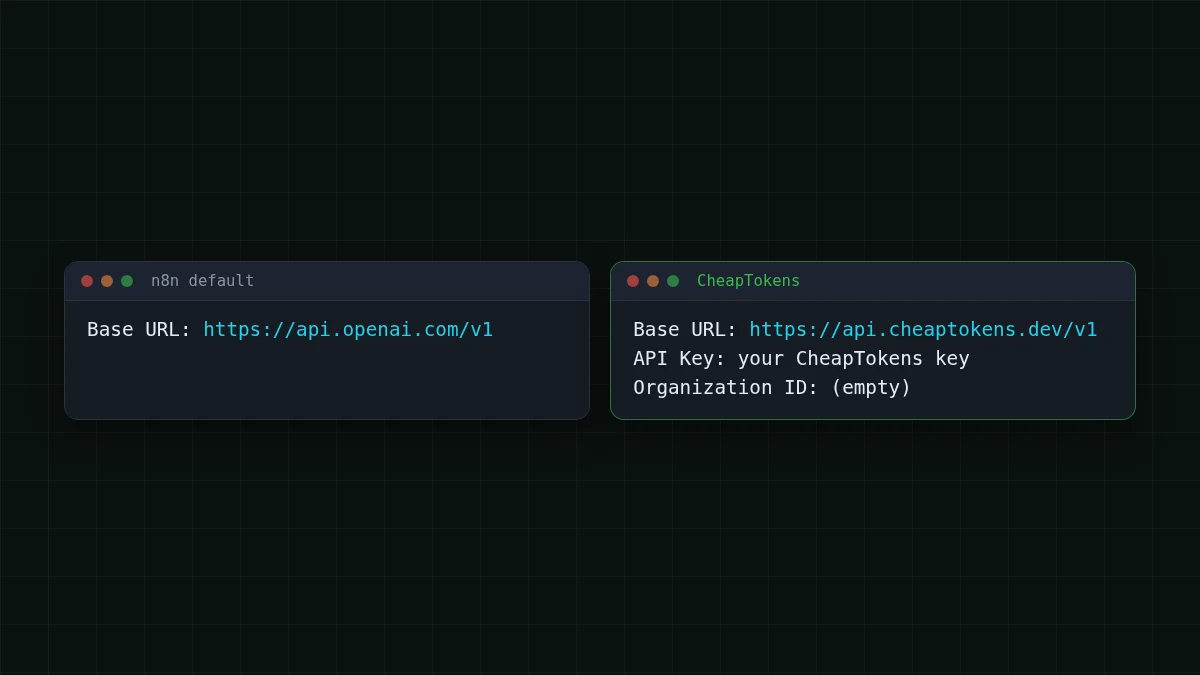
La credencial de OpenAI de n8n tiene cuatro cosas que rellenar. Según el código fuente de la credencial en el repositorio de n8n (rama master, revisado el 1 de noviembre de 2026), son: API Key (obligatoria, enmascarada), Organization ID (opcional), Base URL (por defecto https:/, descrita como la que sobrescribe la dirección base de la API) y un interruptor Add Custom Header con un nombre y un valor de cabecera.
Un detalle que conviene saber: la página de documentación propia de n8n para la credencial de OpenAI solo lista la clave y el id de organización. El campo Base URL es visible en el código fuente, así que es en lo que se apoya esta guía.
Al guardar, n8n prueba la credencial enviando una petición a {Base URL}/ con una cabecera Authorization: Bearer <API Key>. Así, una Base URL incorrecta o una clave incorrecta aparecen ahí mismo, antes de que construyas nada.
Configúralo en cuatro pasos#
Paso a paso
Conecta n8n a CheapTokens
Crea la credencial
En n8n abre Credentials, crea una nueva y elige OpenAI. Mantén tu clave de CheapTokens en un gestor de contraseñas o en una variable de entorno hasta que la pegues, nunca en un campo de texto de un flujo de trabajo.
Rellena dos campos
API Key: tu clave de CheapTokens. Base URL: https:/. Deja Organization ID vacío. Guarda la credencial y espera a la prueba de conexión: llama a /models en esa dirección.
Añade el nodo de modelo
En un flujo de trabajo añade un Basic LLM Chain y adjunta un OpenAI Chat Model como su modelo. Selecciona la credencial nueva. Para el modelo, usa el id de la documentación de CheapTokens: deepseek-. Si el desplegable no lo lista, cambia el campo para introducir el id a mano (por ID o como expresión).
Mantén Chat Completions activado
El nodo usa la API Chat Completions por defecto. Deja Use Responses API desactivado. En las opciones del nodo configura Maximum Number of Tokens para que una respuesta desbocada no se coma el presupuesto.
¿No sabes qué escribir como id de modelo? Pregúntale a la propia API: Lista los modelos con GET /v1/models muestra las cadenas exactas. Distintos proveedores nombran el mismo modelo de forma distinta, así que copia el id de CheapTokens, no de la documentación de otro servicio.
Comprueba la clave fuera de n8n primero#
Si la prueba de la credencial falla, quieres saber si el problema es n8n o la clave. Una breve comprobación en el terminal lo responde. La clave está en una variable de entorno, así que nada secreto acaba en tu historial.
La misma comprobación en curl y Python
curl
export CHEAPTOKENS_API_KEY="your-key-here"
curl https://api.cheaptokens.dev/v1/models \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY"
Esta es la misma petición que envía n8n cuando prueba la credencial. Una lista JSON de modelos significa que la clave y la dirección son correctas.
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Reply with one word: ready"}],
    max_tokens=20,
)
print(r.choices[0].message.content, r.usage)
Esta es una petición de chat completa. r.usage muestra los tokens de entrada y salida de esta pequeña petición; para dimensionar un flujo de trabajo, pon un correo típico en el prompt y vuelve a leer usage.
Un primer flujo de trabajo: clasificar correos entrantes#
Digamos que una bandeja de entrada compartida recibe unos mil correos al día. Quieres que cada uno se etiquete como billing, bug u other, además de un resumen de una línea para quien lo recoja.
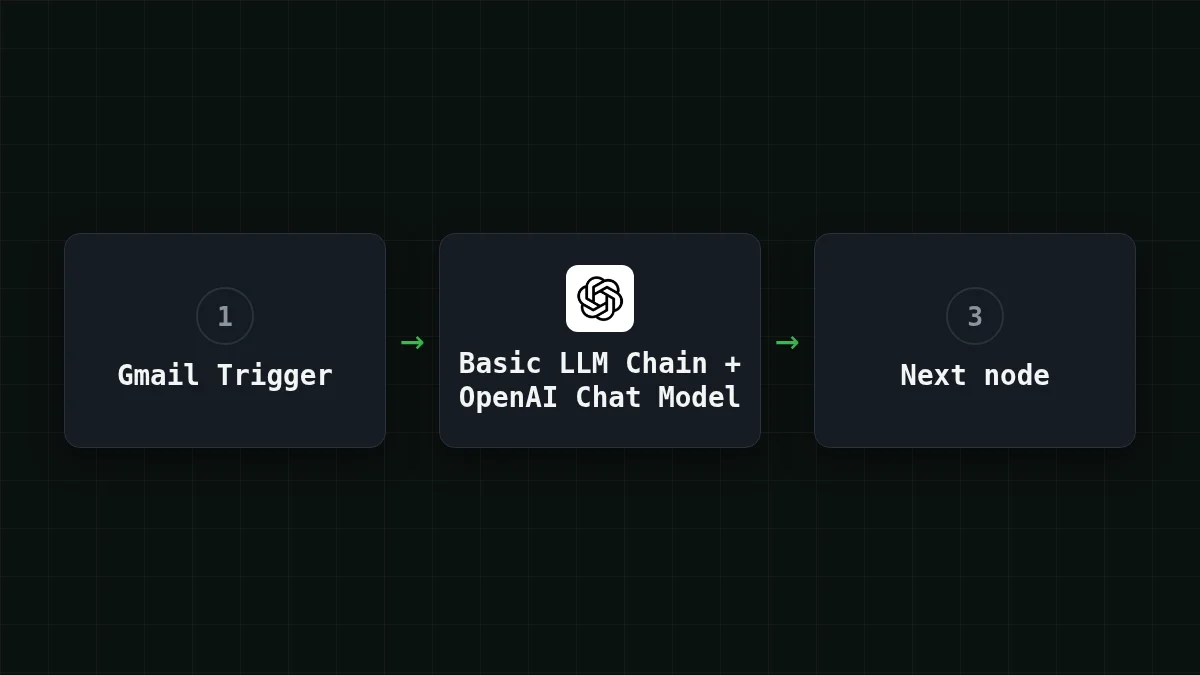
Constrúyelo así: un Gmail Trigger (o un nodo Webhook) alimenta un Basic LLM Chain. El prompt de la cadena dice algo como "Clasifica este correo como billing, bug u other, y luego resúmelo en una frase", con el cuerpo del correo insertado desde el nodo anterior. El nodo OpenAI Chat Model debajo, con tu credencial de CheapTokens, hace el trabajo de pensar.
La tarea es corta y repetitiva: una entrada pequeña, una respuesta pequeña, miles de ejecuciones idénticas. Ahí es donde más rinde un modelo barato con un precio estable. Para este tipo de trabajo en CheapTokens, DeepSeek-V4-Flash te da un único precio a cualquier hora del día, una ventana de contexto de 380K y hasta 32.768 tokens por respuesta.
Cuánto cuesta una ejecución#
Digamos que cada correo genera un prompt de unos 1.500 tokens (instrucciones más el correo) y el modelo escribe unos 300 tokens de vuelta. Una ejecución en DeepSeek-V4-Flash cuesta $0.000053. Para 1.000 correos al día, aquí están todos los modelos lado a lado con OpenRouter, contando entrada y salida juntas:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000042 | $0.042 | $0.0752 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000053 | $0.0525 | $0.147 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00012 | $0.12 | $1.44 |
1500 tokens de entrada y 300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Los recuentos de tokens son una suposición para este ejemplo; mide los tuyos enviando un correo típico a través de la comprobación de Python y leyendo usage, y luego sustituye los números. Los precios actuales están en la página de precios.
Un flujo de trabajo tipo chat es distinto. Con un nodo de memoria, todo el historial viaja en cada llamada, así que la entrada crece con cada mensaje. Por qué un chat de IA largo cuesta más muestra lo rápido que se acumula.
Si no funciona#
La mayoría de los fallos son una de tres cosas: la clave, la dirección o el id de modelo. API 401 o 404: clave, base URL o id de modelo incorrectos recorre cada texto de error. Antes de abrirlo, repasa esta lista:
Lista de verificación
Antes de depurar más
¿Quieres ver el resto de la configuración? La documentación de CheapTokens tiene la referencia completa de la API, y la página de DeepSeek lista los límites del modelo. ¿Ya usas otra herramienta con el mismo patrón? Open WebUI y LangChain se conectan igual: una dirección, una clave, un id de modelo.


