Connecter n8n à CheapTokens : identifiant OpenAI, Base URL
Pointez l'identifiant OpenAI de n8n vers la Base URL CheapTokens, passez le test de connexion et exécutez une chaîne LLM sur DeepSeek-V4-Flash.
Sur cette page
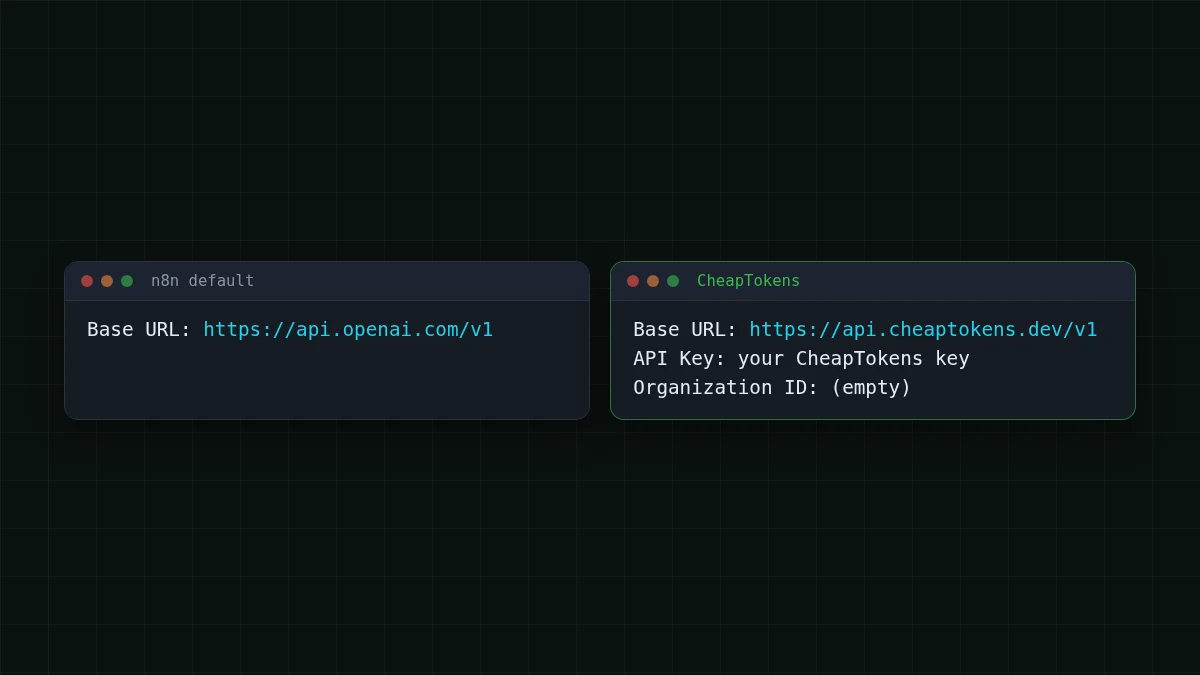
Dans n8n, créez un identifiant OpenAI, placez https:/ dans son champ Base URL, collez votre clé CheapTokens dans API Key et choisissez un id de modèle dans le nœud OpenAI Chat Model. C'est tout le changement : pas de nœud personnalisé, pas de paquet communautaire. Les workflows existants conservent leurs nœuds et ne reçoivent qu'un nouvel identifiant.
Cela fonctionne parce que l'API CheapTokens parle le format OpenAI Chat Completions (et Anthropic Messages aussi), donc le nœud OpenAI de n8n ne voit pas la différence. Si la notion de « base URL » vous est nouvelle, cette explication la couvre en deux minutes.
Ce que l'identifiant n8n vous donne#
L'identifiant OpenAI de n8n comporte quatre champs à remplir. D'après le code source de l'identifiant dans le dépôt n8n (branche master, vérifié le 1er novembre 2026), ce sont : API Key (requis, masqué), Organization ID (facultatif), Base URL (par défaut https:/, décrit comme remplaçant l'adresse de base de l'API) et un interrupteur Add Custom Header avec un nom et une valeur d'en-tête.
Un détail à connaître : la page de documentation n8n de l'identifiant OpenAI ne liste que la clé et l'ID d'organisation. Le champ Base URL est visible dans le code source, c'est donc sur lui que s'appuie ce guide.
À l'enregistrement, n8n teste l'identifiant en envoyant une requête à {Base URL}/ avec un en-tête Authorization: Bearer <API Key>. Une Base URL ou une clé erronée apparaît donc immédiatement, avant même de construire quoi que ce soit.
Configurez-le en quatre étapes#
Étape par étape
Connecter n8n à CheapTokens
Créer l'identifiant
Dans n8n, ouvrez Credentials, créez-en un nouveau et choisissez OpenAI. Gardez votre clé CheapTokens dans un gestionnaire de mots de passe ou une variable d'environnement jusqu'au collage, jamais dans un champ texte d'un workflow.
Remplir deux champs
API Key : votre clé CheapTokens. Base URL : https:/. Laissez Organization ID vide. Enregistrez l'identifiant et attendez le test de connexion : il appelle /models sur cette adresse.
Ajouter le nœud de modèle
Dans un workflow, ajoutez un Basic LLM Chain et attachez-lui un OpenAI Chat Model comme modèle. Sélectionnez le nouvel identifiant. Pour le modèle, utilisez l'id de la documentation CheapTokens : deepseek-. Si la liste déroulante ne le propose pas, passez le champ en saisie manuelle de l'id (par ID ou en expression).
Garder Chat Completions activé
Le nœud utilise l'API Chat Completions par défaut. Laissez Use Responses API désactivé. Dans les options du nœud, définissez Maximum Number of Tokens pour qu'une réponse emballée ne puisse pas manger le budget.
Vous ne savez pas quel id de modèle saisir ? Demandez-le à l'API elle-même : Lister les modèles avec GET /v1/models affiche les chaînes exactes. Des fournisseurs différents nomment un même modèle différemment, alors copiez l'id depuis CheapTokens, pas depuis la doc d'un autre service.
Vérifiez d'abord la clé hors de n8n#
Si le test de l'identifiant échoue, vous voulez savoir si le problème vient de n8n ou de la clé. Une courte vérification en terminal répond à la question. La clé est dans une variable d'environnement, donc rien de secret n'atterrit dans votre historique.
La même vérification en curl et en Python
curl
export CHEAPTOKENS_API_KEY="your-key-here"
curl https://api.cheaptokens.dev/v1/models \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY"
C'est la même requête que n8n envoie lorsqu'il teste l'identifiant. Une liste JSON de modèles signifie que la clé et l'adresse sont correctes.
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
r = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Reply with one word: ready"}],
    max_tokens=20,
)
print(r.choices[0].message.content, r.usage)
C'est une requête de chat complète. r.usage indique les tokens en entrée et en sortie pour cette petite requête ; pour dimensionner un workflow, mettez un email typique dans le prompt et relisez usage.
Un premier workflow : trier les emails entrants#
Disons qu'une boîte partagée reçoit environ un millier d'emails par jour. Vous voulez que chacun soit étiqueté billing, bug ou other, avec un résumé d'une ligne pour la personne qui le prend en charge.
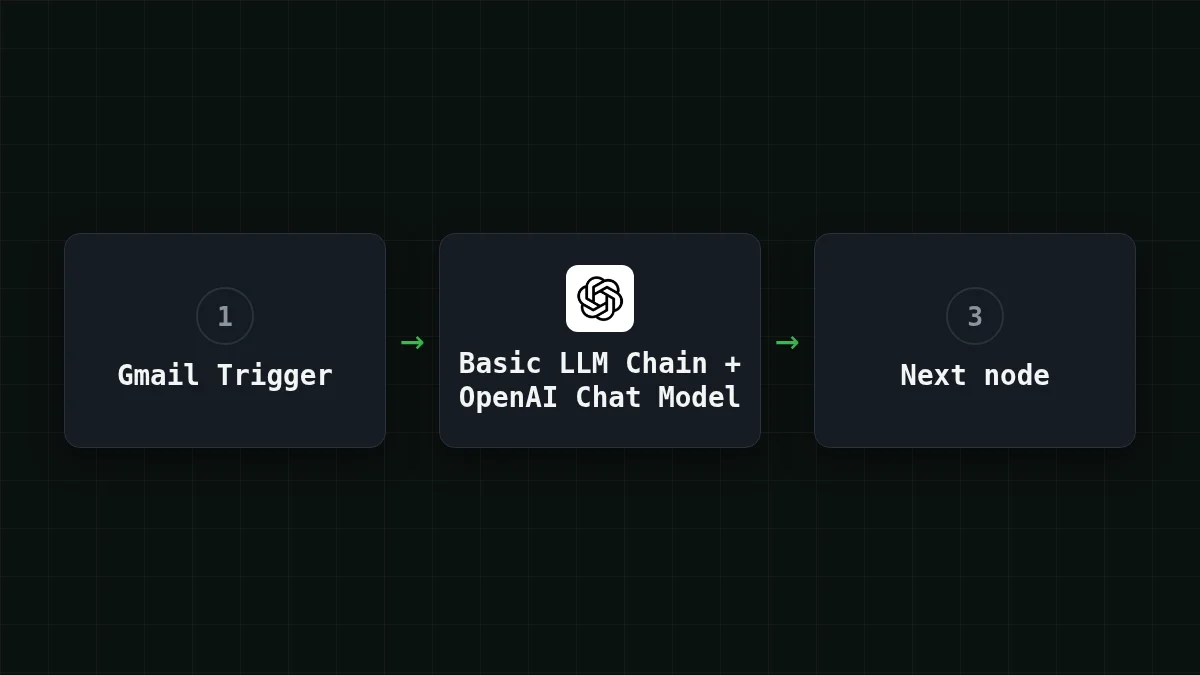
Construisez-le ainsi : un Gmail Trigger (ou un nœud Webhook) alimente un Basic LLM Chain. Le prompt de la chaîne dit à peu près « Classe cet email en billing, bug ou other, puis résume-le en une phrase », avec le corps de l'email inséré depuis le nœud précédent. Le nœud OpenAI Chat Model en dessous, avec votre identifiant CheapTokens, fait la réflexion.
La tâche est courte et répétitive : une petite entrée, une petite réponse, des milliers d'exécutions identiques. C'est là qu'un modèle bon marché à prix stable rapporte le plus. Pour ce type de travail dans CheapTokens, DeepSeek-V4-Flash offre un prix unique à toute heure, une fenêtre de contexte de 380K et jusqu'à 32 768 tokens par réponse.
Combien coûte une exécution#
Disons que chaque email produit un prompt d'environ 1 500 tokens (instructions plus email) et que le modèle écrit environ 300 tokens en retour. Une exécution sur DeepSeek-V4-Flash coûte $0.000053. Pour 1 000 emails par jour, voici tous les modèles côte à côte avec OpenRouter, entrée et sortie comptées ensemble :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000042 | $0.042 | $0.0752 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000053 | $0.0525 | $0.147 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00012 | $0.12 | $1.44 |
1 500 tokens d'entrée et 300 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Les nombres de tokens sont une hypothèse pour cet exemple ; mesurez les vôtres en envoyant un email typique via la vérification Python et en lisant usage, puis remplacez les chiffres. Les prix actuels sont sur la page de tarifs.
Un workflow de type chat, c'est différent. Avec un nœud de mémoire, tout l'historique voyage à chaque appel, donc l'entrée grossit à chaque message. Pourquoi un long chat IA coûte plus cher montre à quelle vitesse cela s'additionne.
Si ça ne fonctionne pas#
La plupart des échecs relèvent de trois choses : la clé, l'adresse ou l'id de modèle. API 401 ou 404 : mauvaise clé, base URL ou id de modèle détaille chaque texte d'erreur. Avant de l'ouvrir, passez en revue cette liste :
Liste de contrôle
Avant d'aller plus loin dans le débogage
Vous voulez voir le reste de la configuration ? La documentation CheapTokens contient la référence API complète, et la page DeepSeek liste les limites du modèle. Vous utilisez déjà un autre outil avec le même schéma ? Open WebUI et LangChain se connectent de la même façon : une adresse, une clé, un id de modèle.


