AI для новичковИнструкция
Почему ИИ выдумывает факты и 4 приёма, которые это снижают
Что такое галлюцинации ИИ, почему модель уверенно ошибается и четыре приёма для промпта с примером «было → стало» на ваших документах.
Содержание
- Почему модель звучит уверенно, когда ошибается
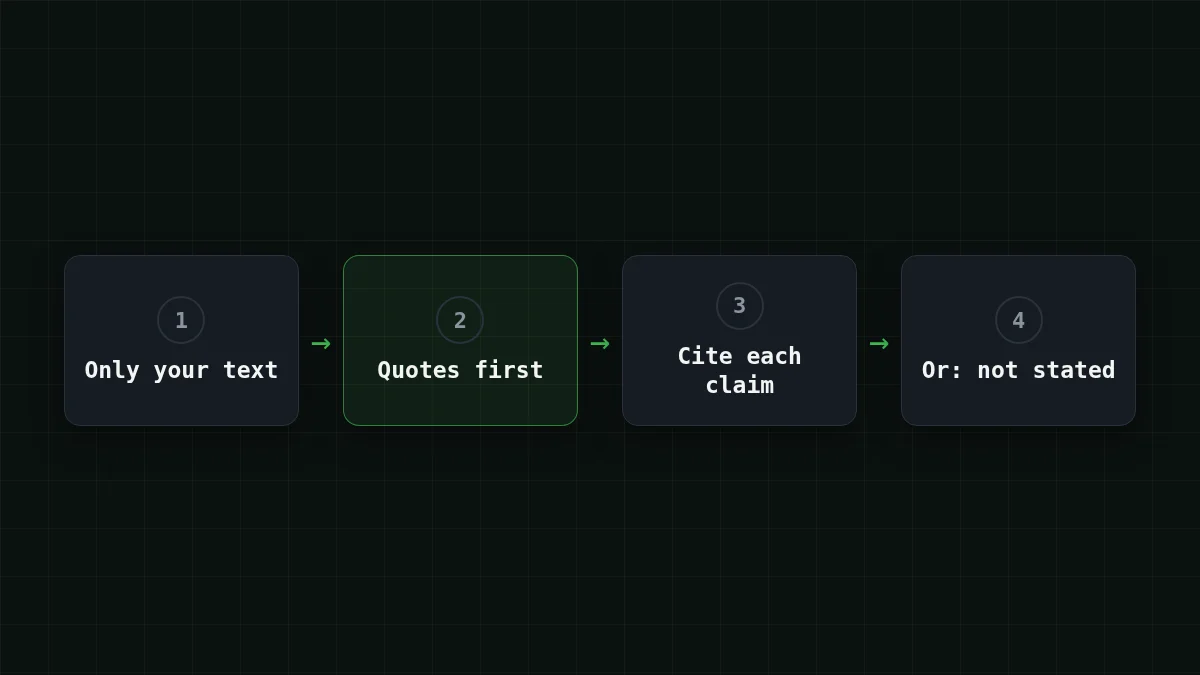
- Четыре приёма, которые снижают выдуманные ответы
- 1. Разрешите сказать «не знаю»
- 2. Сначала цитаты, потом ответ
- 3. Пусть ссылается на цитаты и снимает то, что подтвердить нечем
- 4. Ограничьте модель вашим текстом
- До и после на одном примере
- Все четыре приёма в одном API-запросе
- Сколько стоят цитаты
- Что эти приёмы не решают
В вашем договоре аренды нет пункта о штрафе за просрочку. Вы спрашиваете чат-бота, каков штраф, и иногда он отвечает процентом и сроком. Уверенно, конкретно и выдумано.
Это и есть галлюцинация: модель пишет гладкий текст, который фактически неверен или не сходится с тем, что вы ей дали. В документации Anthropic по снижению галлюцинаций (страница проверена 27 октября 2026 года, даты публикации на ней нет) сказано, что так иногда делают даже самые продвинутые модели. Там же перечислены приёмы, которые помогают. Четыре из них помещаются в промпт, и ниже их можно скопировать как есть.
Почему модель звучит уверенно, когда ошибается#
Языковая модель не ищет факты в справочнике. Она продолжает текст: по всему, что уже написано, выбирает слова, которые вероятнее всего пойдут дальше. Представьте автодополнение в телефоне, только начитанное намного лучше. Если верный ответ модель когда-то усвоила, вероятные слова и верные слова совпадают. Если нет, вероятные слова всё равно звучат гладко, а гладко похоже на «уверенно».
Две ситуации объясняют многие выдуманные ответы, которые вам встретятся:
- Факта нет в самой модели. Это произошло после окончания её обучения или лежит в вашем личном документе, которого она не видела. Спросите про новость прошлого месяца, и можно получить уверенный ответ, собранный из более старых шаблонов.
- Факта нет в вашем документе, но вопрос предполагает, что он есть. Модель заполняет пробел. Представьте ученика, который обязан написать хоть что-то на каждый вопрос экзамена и не имеет права оставить пустое место.
Попробуйте самиПопробуйте: что делает модель с вопросом, на который в вашем тексте нет ответа?Показать ответ
Вставьте в чат короткий текст (меню, правила, рецепт) и спросите о детали, которой в нём явно нет, например о цене блюда, которого нет в списке. Прочитайте ответ. Одни ответы говорят, что в тексте этого нет. Другие выдумывают правдоподобную деталь. Какой вы получите, зависит от модели и от формулировки, а четыре приёма ниже подталкивают к первому варианту.
Четыре приёма, которые снижают выдуманные ответы#
Допустим, вы вставили договор аренды и хотите узнать штраф за просрочку. В этом договоре такого пункта нет, и дальше он будет нашим тестовым случаем.
1. Разрешите сказать «не знаю»#
Модель, уверенная, что отвечать нужно на любой вопрос, ответит на любой. Скажите ей, что это не правило:
Если в документе об этом не сказано, ответь ровно так: «В документе не указано».
Не догадывайся.
Anthropic ставит это первым и самым простым шагом: прямо разрешить модели признать, что она не знает.
2. Сначала цитаты, потом ответ#
Для длинных документов (в рекомендациях Anthropic граница проходит около 20 000 токенов, примерно 15 000 слов) просите дословные цитаты до любого анализа и стройте ответ только на них:
Сначала выпиши дословно предложения, относящиеся к моему вопросу,
под заголовком «Цитаты». Если таких нет, напиши «Подходящих цитат нет».
Потом ответь, опираясь только на эти цитаты.
Модель должна показать текст, который действительно есть, прежде чем делать вывод. А вам прочитать цитаты — пять секунд.
3. Пусть ссылается на цитаты и снимает то, что подтвердить нечем#
Попросите после каждого утверждения подтверждающую цитату, а затем проверку самой себя:
После каждого утверждения ставь в скобках подтверждающую цитату.
Потом перечитай ответ: если у утверждения нет цитаты, удали его.
Это проверка по Anthropic: нет цитаты — нет утверждения.
4. Ограничьте модель вашим текстом#
Используй только документ между тегами <document>.
Не используй внешние знания.
Anthropic относит ограничение внешних знаний предоставленными документами к продвинутым приёмам. Его же стоит взять, если вы делаете бота по своим документам: бот отвечает по вашим страницам, а не по памяти.
До и после на одном примере#
Тот же договор, тот же вопрос, два промпта. Левый — так большинство из нас начинает.
Сравнение
Один вопрос, два промпта
Было
Вот мой договор аренды:
[текст договора]

Какой штраф за просрочку?
Модель, которая считает, что отвечать нужно всегда, может назвать число.
Стало
<document>
[текст договора]
</document>

Вопрос: какой штраф за просрочку?

Используй только документ выше. Сначала выпиши дословно
подходящие предложения под заголовком «Цитаты» (или
напиши «Подходящих цитат нет»). Потом ответь только по
этим цитатам, ставя цитату в скобках после каждого
утверждения. Если в документе об этом не сказано,
ответь ровно так: «В документе не указано».
Ответ, к которому мы стремимся: «Подходящих цитат нет» и затем «В документе не указано».
Промпт «стало» длиннее, и это нормально: вы пишете его один раз и используете снова.
Все четыре приёма в одном API-запросе#
Если вы обращаетесь к модели через API, приёмы идут в системное сообщение, а документ — в пользовательское, обёрнутый в теги. Запрос ниже идёт на OpenAI-совместимый адрес CheapTokens; ключ берётся из переменной окружения, а полный id модели — MiniMaxAI/ (id берите из документации CheapTokens, у разных провайдеров имена отличаются). Текст инструкции в запросе можно заменить русским, смысл тот же.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
Ответ лежит в choices[0].. Если это ваш первый запрос, статья Первый запрос к API CheapTokens проведёт через ключ и баланс по шагам.
Сколько стоят цитаты#
Цитаты делают ответ длиннее, а на большинстве моделей ответ — более дорогая сторона запроса (см. входные и выходные токены). Так что приём «сначала цитаты» недорог, но не бесплатен.
Допустим, отчёт на 40 страниц — это около 25 000 токенов, а цитаты вместе с ответом занимают около 1 500. Один такой запрос к MiniMax-M2.7 стоит $0.0015. В таблице тот же запрос на всех моделях и колонка OpenRouter, так что сравнивать можно в сумме, с учётом входа и выхода вместе:
| Модель | Вход $/1M | Выход $/1M | Стоимость | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
25 000 входных и 1 500 выходных токенов всего. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
MiniMax-M2.7 принимает контекст 180K и отдаёт до 8 192 токенов в ответе по одной цене в любой час, так что и отчёт на 25 000 токенов, и длинный ответ с цитатами помещаются. Актуальные цены — на странице цен, а модели описаны в каталоге.
Что эти приёмы не решают#
Они заметно снижают выдуманные ответы, но не убирают их совсем. Anthropic говорит об этом прямо: всё важное проверяйте. В договоре это числа, даты и имена, сверенные с оригиналом.
Стоит знать ещё два приёма с той же страницы. Best-of-N: задайте один и тот же вопрос несколько раз и сравните, потому что деталь, которая меняется от запуска к запуску, выдаёт догадку. Одинаковый запрос может вернуть одинаковый ответ, так что слегка поменяйте формулировку или температуру (см. системный промпт и температура). И режим размышления позволяет модели проверить собственные рассуждения перед ответом, что стоит дополнительных токенов (почему размышления дороже).
Чек-лист
Прежде чем верить ответу по вашим документам


