AI dla początkującychPrzewodnik
Dlaczego AI zmyśla i 4 nawyki w promptach, które to ograniczają
Czym są halucynacje AI, dlaczego model brzmi pewnie i się myli, oraz cztery nawyki w promptach do skopiowania z przykładem przed/po dla twoich dokumentów.
Na tej stronie
- Dlaczego model brzmi pewnie, gdy się myli
- Cztery nawyki, które ograniczają zmyślone odpowiedzi
- 1. Pozwól na „nie wiem”
- 2. Najpierw cytat, potem odpowiedź
- 3. Każ mu cytować i odrzucaj to, czego nie potrafi poprzeć
- 4. Ogranicz go do tekstu, który mu dałeś
- Przed i po na jednym przykładzie
- Wszystkie cztery nawyki w jednym żądaniu API
- Ile kosztuje cytowanie
- Czego te nawyki nie naprawiają
Twoja umowa najmu nie zawiera klauzuli o opłacie za zwłokę. Pytasz chatbota, jaka jest ta opłata, a on czasem odpowiada procentem i terminem płatności. Pewnie, konkretnie i zmyślone.
To halucynacja: model pisze płynny tekst, który jest merytorycznie błędny albo nie pasuje do kontekstu, który mu podałeś. Dokumentacja Anthropic o ograniczaniu halucynacji (strona sprawdzona 27 października 2026; nie ma daty publikacji) mówi, że nawet najbardziej zaawansowane modele czasem to robią, i wymienia nawyki, które pomagają. Cztery z nich mieszczą się w prompcie i możesz je wkleić w takiej postaci, jak poniżej.
Dlaczego model brzmi pewnie, gdy się myli#
Model językowy nie sprawdza faktów. Kontynuuje tekst: mając wszystko, co dotąd powiedziano, wybiera słowa, które najprawdopodobniej przyjdą następne. Pomyśl o autouzupełnianiu w telefonie, tylko znacznie lepiej oczytanym. Gdy prawdziwa odpowiedź jest czymś, czego model się nauczył, prawdopodobne słowa pokrywają się z prawdziwymi. Gdy nie jest, prawdopodobne słowa wciąż są płynne, a płynność brzmi jak pewność.
Dwie sytuacje wyjaśniają wiele zmyślonych odpowiedzi, na które trafisz:
- Faktu nie ma w modelu. Wydarzył się po zakończeniu treningu modelu albo tkwi w twoim prywatnym dokumencie, którego model nigdy nie widział. Zapytaj o zeszłotygodniowe wiadomości, a możesz dostać pewną odpowiedź zbudowaną ze starszych wzorców.
- Faktu brakuje w twoim dokumencie, ale pytanie zakłada, że istnieje. Model wypełnia lukę. Wyobraź sobie ucznia, który musi coś napisać na każde pytanie egzaminacyjne i nigdy nie może zostawić pustego miejsca.
Spróbuj samWypróbuj: co robi model z pytaniem, na które twój tekst nie potrafi odpowiedzieć?Pokaż odpowiedź
Wklej krótki tekst do czatu (menu, regulamin, przepis) i zapytaj o szczegół, którego wyraźnie w nim nie ma, na przykład o cenę dania, którego nie ma na liście. Przeczytaj odpowiedź. Niektóre odpowiedzi mówią, że tekst o tym nie wspomina. Inne wymyślają prawdopodobny szczegół. To, którą dostaniesz, zależy od modelu i od twojego sformułowania, a cztery poniższe nawyki popychają go w stronę pierwszej.
Cztery nawyki, które ograniczają zmyślone odpowiedzi#
Złóżmy, że wkleiłeś umowę najmu i chcesz poznać opłatę za zwłokę. Ta umowa nie ma klauzuli o opłacie za zwłokę i od teraz będzie naszym przypadkiem testowym.
1. Pozwól na „nie wiem”#
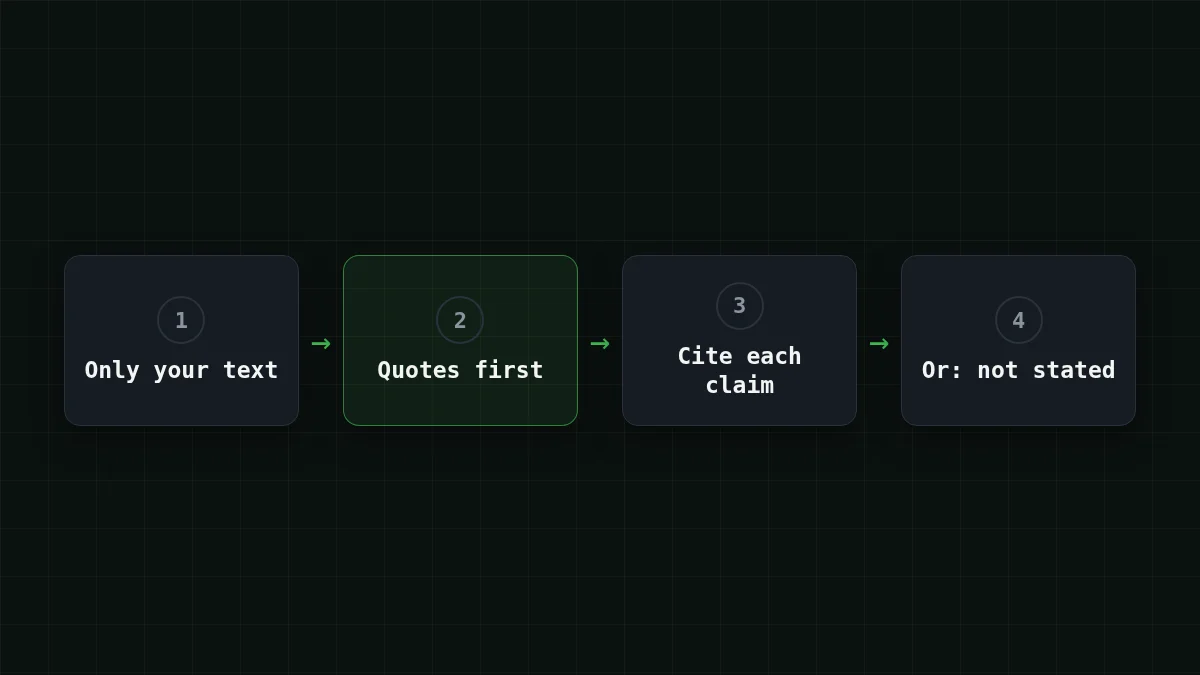
Model, który wierzy, że na każde pytanie trzeba odpowiedzieć, odpowie. Powiedz mu, że to nie jest zasada:
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
Anthropic wymienia to jako pierwszy, najprostszy krok: wyraźnie daj modelowi pozwolenie na przyznanie, że czegoś nie wie.
2. Najpierw cytat, potem odpowiedź#
W przypadku długich dokumentów (wytyczne Anthropic wyznaczają granicę na około 20 000 tokenów, czyli mniej więcej 15 000 słów) poproś o dosłowne cytaty przed jakąkolwiek analizą i spraw, by odpowiedź się na nich opierała:
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
Model musi wskazać tekst, który naprawdę tam jest, zanim cokolwiek stwierdzi. Przeczytanie cytatów zajmuje ci też pięć sekund.
3. Każ mu cytować i odrzucaj to, czego nie potrafi poprzeć#
Poproś o cytat na poparcie po każdym twierdzeniu, a potem pozwól modelowi sprawdzić samego siebie:
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
To krok weryfikacji według Anthropic: brak cytatu, brak twierdzenia.
4. Ogranicz go do tekstu, który mu dałeś#
Use only the document between the <document> tags.
Do not use outside knowledge.
Anthropic wymienia ograniczanie wiedzy zewnętrznej do dostarczonych dokumentów wśród technik zaawansowanych. To także nawyk do skopiowania, jeśli budujesz bota na własnych dokumentach: bot odpowiada na podstawie twoich stron, a nie z pamięci.
Przed i po na jednym przykładzie#
Ta sama umowa, to samo pytanie, dwa prompty. Lewy to sposób, w jaki większość z nas zaczyna.
Porównaj
To samo pytanie, dwa prompty
Przed
Here is my rental agreement:
[agreement text]

What is the late fee?
Model, który czuje, że musi odpowiedzieć, może podać ci liczbę.
Po
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
Odpowiedź, do której tu dążysz: „Brak odpowiednich cytatów.”, a potem „Nie podano w dokumencie.”
Prompt „po” jest dłuższy i to jest w porządku: piszesz go raz i używasz ponownie.
Wszystkie cztery nawyki w jednym żądaniu API#
Jeśli wywołujesz model przez API, nawyki trafiają do wiadomości systemowej, a twój dokument do wiadomości użytkownika, opakowany w znaczniki. To żądanie korzysta z endpointu zgodnego z OpenAI w CheapTokens; klucz pochodzi ze zmiennej środowiskowej, a pełny identyfikator modelu to MiniMaxAI/ (identyfikatory bierz z dokumentacji CheapTokens, bo nazwy różnią się między dostawcami).
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
Odpowiedź jest w choices[0].. Jeśli to twoje pierwsze wywołanie, Twoje pierwsze żądanie API z CheapTokens krok po kroku omawia klucz i saldo.
Ile kosztuje cytowanie#
Cytowanie wydłuża odpowiedź, a w większości modeli odpowiedź to droższa strona żądania (zobacz tokeny wejściowe a wyjściowe). Nawyku cytowania najpierw nie kosztuje więc dużo, ale nie jest darmowy.
Powiedzmy, że raport na 40 stron to około 25 000 tokenów, a cytaty plus odpowiedź to około 1500. Jedno takie żądanie na MiniMax-M2.7 kosztuje $0.0015. Tabela pokazuje to samo żądanie na każdym modelu, z kolumną OpenRouter, żebyś mógł porównać łącznie, licząc wejście i wyjście razem:
| Model | Wejście $/1M | Wyjście $/1M | Koszt | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
25 000 tokenów wejściowych i 1500 tokenów wyjściowych łącznie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
MiniMax-M2.7 przyjmuje kontekst 180K i do 8192 tokenów w odpowiedzi w jednej stałej cenie o każdej porze, więc raport na 25 000 tokenów i długa cytowana odpowiedź oba się mieszczą. Aktualne ceny są na stronie cennika, a modele opisano w dokumentacji.
Czego te nawyki nie naprawiają#
Znacznie ograniczają zmyślone odpowiedzi, ale ich nie usuwają. Anthropic mówi to wprost: sprawdzaj wszystko, co ważne. W umowie oznacza to liczby, daty i nazwy, zestawione z oryginalną stroną.
Warto znać jeszcze dwie sztuczki z tej samej strony. Best-of-N: zadaj to samo pytanie kilka razy i porównaj, bo szczegół, który zmienia się między uruchomieniami, to znak, że model zgaduje. Identyczne żądanie może wrócić jako identyczna odpowiedź, więc zmień trochę sformułowanie albo temperaturę (zobacz prompt systemowy i temperatura). A tryb myślenia pozwala modelowi sprawdzić własne rozumowanie, zanim odpowie, co kosztuje dodatkowe tokeny (dlaczego myślenie kosztuje więcej).
Lista kontrolna
Zanim zaufasz odpowiedzi zbudowanej na twoich dokumentach


