AI 입문가이드
AI가 왜 지어내는지, 그리고 그것을 줄이는 4가지 프롬프트 습관
AI 환각이란 무엇인지, 모델이 왜 확신에 차 있으면서 틀리는지, 그리고 자신의 문서에 쓸 수 있는 전/후 예시와 함께 복사-붙여넣기 프롬프트 습관 네 가지를 설명합니다.
이 페이지의 내용
귀하의 임대차 계약서에는 연체료 조항이 없습니다. 챗봇에게 연체료가 얼마인지 물으면 때때로 백분율과 납부 기한을 답합니다. 자신감 있고 구체적이며, 지어낸 답입니다.
이것이 환각입니다: 모델은 유창한 텍스트를 쓰지만 사실과 다르거나 당신이 준 맥락과 맞지 않습니다. 환각 줄이기에 관한 Anthropic의 문서(2026년 10월 27일 확인; 게시 날짜 없음)는 가장 발전된 모델조차 때때로 이렇게 한다고 말하며, 도움이 되는 습관들을 나열합니다. 그중 네 가지는 프롬프트 안에 들어가며, 아래 그대로 붙여넣을 수 있습니다.
모델이 틀렸는데도 확신에 차 들리는 이유#
언어 모델은 사실을 찾아보지 않습니다. 텍스트를 이어 씁니다: 지금까지의 모든 것에 비추어 다음에 올 가능성이 가장 높은 단어를 고릅니다. 휴대폰의 자동완성을 생각해 보세요, 훨씬 더 많이 읽은 것일 뿐입니다. 진짜 답이 모델이 학습한 것이라면, 가능성 높은 단어와 진짜 단어가 일치합니다. 그렇지 않다면, 가능성 높은 단어는 여전히 유창하고, 유창함은 확신처럼 들립니다.
당신이 마주칠 지어낸 답의 상당 부분은 두 가지 상황으로 설명됩니다:
- 그 사실이 모델 안에 없습니다. 모델의 학습이 끝난 뒤에 일어난 일이거나, 모델이 한 번도 본 적 없는 당신의 비공개 문서에 들어 있습니다. 지난달 뉴스에 대해 물으면 오래된 패턴으로 만든 자신감 있는 답을 받을 수 있습니다.
- 그 사실이 당신의 문서에 없는데, 질문은 그것이 있다고 전제합니다. 모델이 빈틈을 채웁니다. 모든 시험 문제에 뭔가를 써야 하고 빈칸으로 남길 수 없는 학생을 떠올려 보세요.
직접 해보기해 보기: 당신의 텍스트가 답할 수 없는 질문에 모델은 어떻게 할까요?정답 보기
채팅에 짧은 텍스트(메뉴, 정책, 레시피)를 붙여넣고 그것에 분명히 없는 세부 사항, 예를 들어 목록에 없는 요리의 가격을 물어보세요. 답변을 읽어 보세요. 어떤 답은 텍스트에 언급되지 않았다고 말합니다. 다른 답은 그럴듯한 세부 사항을 지어냅니다. 어느 쪽을 받는지는 모델과 당신의 표현에 달려 있으며, 아래 네 가지 습관은 첫 번째 쪽으로 밀어 줍니다.
지어낸 답을 줄이는 네 가지 습관#
임대차 계약서를 붙여넣고 연체료를 알고 싶다고 합시다. 이 계약서에는 연체료 조항이 없으며, 이것이 이제부터 우리의 테스트 사례가 됩니다.
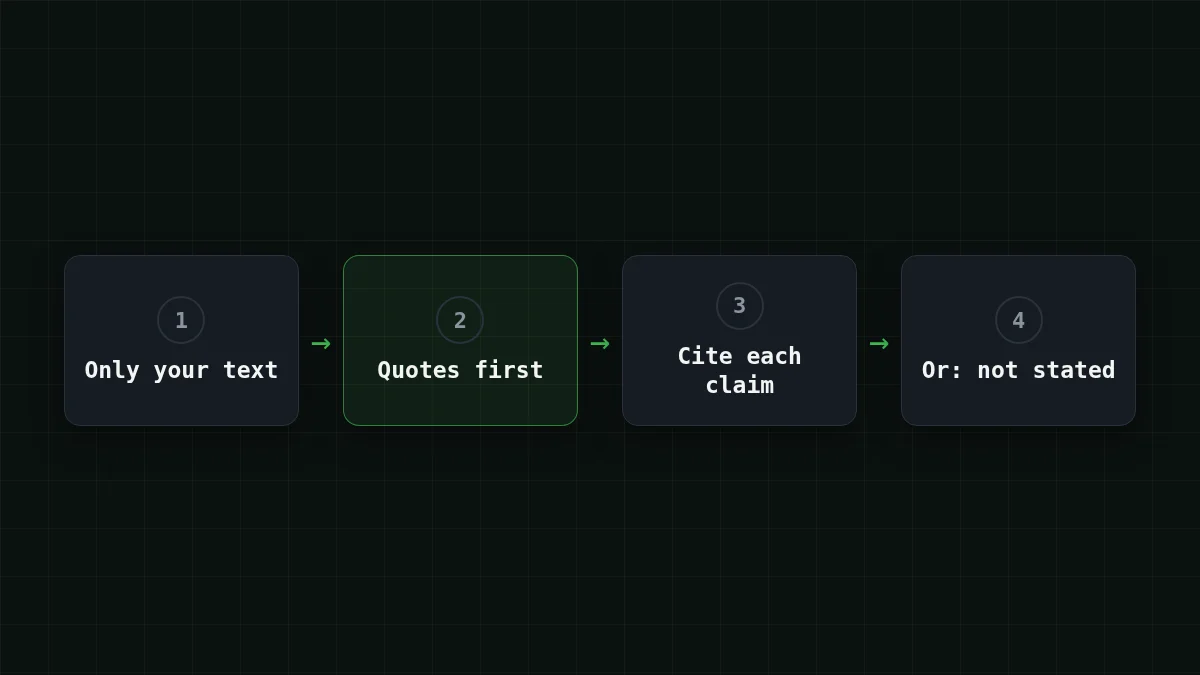
1. "모르겠다"를 허용하세요#
모든 질문에 답해야 한다고 믿는 모델은 답할 것입니다. 그것이 규칙이 아니라고 말하세요:
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
Anthropic은 이것을 첫 번째이자 가장 간단한 단계로 나열합니다: 모델이 모른다고 인정할 권한을 명시적으로 주는 것입니다.
2. 먼저 인용하고, 그다음 답하세요#
긴 문서(Anthropic의 지침은 약 20,000 토큰, 대략 15,000 단어를 기준으로 삼습니다)의 경우, 어떤 분석보다도 먼저 단어 그대로의 인용을 요청하고, 답이 그 인용에 근거하게 하세요:
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
모델은 어떤 결론을 내리기 전에 실제로 존재하는 텍스트를 가리켜야 합니다. 인용을 읽는 데도 당신은 5초밖에 걸리지 않습니다.
3. 인용하게 하고, 뒷받침할 수 없는 것은 버리세요#
각 주장 뒤에 뒷받침하는 인용을 요청하고, 그다음 모델이 스스로 점검하게 하세요:
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
이것이 Anthropic의 검증 단계입니다: 인용 없으면 주장도 없습니다.
4. 당신이 준 텍스트로 제한하세요#
Use only the document between the <document> tags.
Do not use outside knowledge.
Anthropic은 외부 지식을 제공된 문서로 제한하는 것을 고급 기법 중 하나로 나열합니다. 또한 자신의 문서로 봇을 만든다면 복사해야 할 습관이기도 합니다: 봇은 기억이 아니라 당신의 페이지에서 답합니다.
한 예시의 전과 후#
같은 계약서, 같은 질문, 두 개의 프롬프트. 왼쪽은 우리 대부분이 시작하는 방식입니다.
비교하기
같은 질문, 두 개의 프롬프트
전
Here is my rental agreement:
[agreement text]

What is the late fee?
답해야 한다고 느끼는 모델은 당신에게 숫자를 줄 수 있습니다.
후
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
여기서 목표로 하는 답: "관련 인용 없음." 그리고 "문서에 명시되지 않음."
"후" 프롬프트가 더 길지만, 그것은 괜찮습니다: 한 번 쓰고 재사용하면 됩니다.
하나의 API 요청에 네 가지 습관 모두#
API를 통해 모델을 호출한다면, 습관은 시스템 메시지에 들어가고 문서는 태그로 감싸 사용자 메시지에 들어갑니다. 이 요청은 CheapTokens의 OpenAI 호환 엔드포인트를 사용합니다; 키는 환경 변수에서 오며, 전체 모델 id는 MiniMaxAI/입니다(제공자마다 이름이 다르므로 id는 CheapTokens 문서에서 가져오세요).
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
답변은 choices[0].에 있습니다. 첫 호출이라면, CheapTokens로 하는 첫 API 요청이 키와 잔액 단계를 차근차근 안내합니다.
인용의 비용#
인용은 답변을 길게 만들며, 대부분의 모델에서 답변은 요청에서 더 비싼 쪽입니다(입력 vs 출력 토큰 참고). 따라서 인용 우선 습관은 감당하기에 저렴하지만 무료는 아닙니다.
40페이지 보고서가 약 25,000 토큰이고 인용과 답변이 합쳐 약 1,500이라 합시다. MiniMax-M2.7에서 그러한 요청 하나는 $0.0015입니다. 표는 모든 모델에서 같은 요청을 보여 주며, OpenRouter 열도 있어 입력과 출력을 합쳐 총액으로 비교할 수 있습니다:
| 모델 | 입력 $/1M | 출력 $/1M | 비용 | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
총 입력 25,000개 및 출력 1,500개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
MiniMax-M2.7은 180K 컨텍스트와 답변에서 최대 8,192 토큰을 어느 시간대든 하나의 고정 가격으로 받으므로, 25,000 토큰 보고서와 긴 인용 답변 모두 들어갑니다. 현재 가격은 가격 페이지에 있고, 모델은 문서에 설명되어 있습니다.
이 습관들이 고치지 못하는 것#
이들은 지어낸 답을 크게 줄이지만 없애지는 못합니다. Anthropic도 이를 직접 말합니다: 중요한 것은 무엇이든 확인하세요. 계약서라면 숫자, 날짜, 이름을 원본 페이지와 대조하는 것입니다.
같은 페이지의 두 가지 요령도 알아 둘 만합니다. Best-of-N: 같은 질문을 몇 번 하고 비교하세요, 실행할 때마다 바뀌는 세부 사항은 모델이 추측하고 있다는 신호이기 때문입니다. 동일한 요청은 동일한 답변으로 돌아올 수 있으므로, 표현을 조금 바꾸거나 temperature를 바꾸세요(시스템 프롬프트와 temperature 참고). 그리고 사고 모드는 모델이 답하기 전에 자신의 추론을 점검하게 하며, 추가 토큰이 듭니다(사고에 더 드는 이유).
체크리스트
문서에 근거한 답을 신뢰하기 전에


