AI untuk pemulaPanduan
Mengapa AI mengarang dan 4 kebiasaan prompt yang menguranginya
Apa itu halusinasi AI, mengapa model terdengar yakin dan salah, dan empat kebiasaan prompt siap tempel dengan contoh sebelum/sesudah untuk dokumen Anda sendiri.
Di halaman ini
- Mengapa model terdengar yakin saat salah
- Empat kebiasaan yang mengurangi jawaban karangan
- 1. Izinkan "Saya tidak tahu"
- 2. Kutip dulu, jawab kemudian
- 3. Buat ia mengutip, dan buang yang tidak bisa didukungnya
- 4. Batasi pada teks yang Anda berikan
- Sebelum dan sesudah pada satu contoh
- Keempat kebiasaan dalam satu permintaan API
- Berapa biaya mengutip
- Apa yang tidak diperbaiki oleh kebiasaan ini
Perjanjian sewa Anda tidak memiliki klausul denda keterlambatan. Anda bertanya kepada chatbot berapa dendanya, dan kadang-kadang ia menjawab dengan persentase dan tanggal jatuh tempo. Yakin, spesifik, dan mengarang.
Itu adalah halusinasi: model menulis teks yang lancar tetapi secara faktual salah atau tidak cocok dengan konteks yang Anda berikan. Dokumentasi Anthropic tentang mengurangi halusinasi (halaman diperiksa 27 Oktober 2026; tidak mencantumkan tanggal publikasi) menyatakan bahwa bahkan model paling canggih pun terkadang melakukan ini, dan dokumentasi itu mencantumkan kebiasaan-kebiasaan yang membantu. Empat di antaranya muat dalam sebuah prompt, dan Anda dapat menempelkannya apa adanya di bawah ini.
Mengapa model terdengar yakin saat salah#
Model bahasa tidak mencari fakta. Ia melanjutkan teks: berdasarkan semua yang ada sejauh ini, ia memilih kata-kata yang paling mungkin muncul berikutnya. Bayangkan autocomplete di ponsel Anda, hanya saja jauh lebih banyak membaca. Ketika jawaban yang benar adalah sesuatu yang dipelajari model, kata-kata yang mungkin dan kata-kata yang benar sejalan. Ketika tidak, kata-kata yang mungkin tetap lancar, dan lancar terdengar seperti yakin.
Dua situasi menjelaskan banyak jawaban karangan yang akan Anda temui:
- Fakta tidak ada dalam model. Itu terjadi setelah pelatihan model berakhir, atau terdapat dalam dokumen pribadi Anda yang belum pernah dilihat model. Tanyakan tentang berita bulan lalu dan Anda mungkin mendapat jawaban yakin yang dibangun dari pola lama.
- Fakta tidak ada dalam dokumen Anda, tetapi pertanyaan mengasumsikan itu ada. Model mengisi kekosongan. Bayangkan seorang siswa yang harus menulis sesuatu untuk setiap pertanyaan ujian dan tidak pernah diizinkan mengosongkan satu pun.
Coba sendiriCoba: apa yang dilakukan model terhadap pertanyaan yang tidak dapat dijawab teks Anda?Tampilkan jawaban
Tempelkan teks pendek ke dalam obrolan (menu, kebijakan, resep) dan tanyakan detail yang jelas tidak ada di dalamnya, seperti harga hidangan yang tidak tercantum. Baca balasannya. Beberapa jawaban mengatakan teks tidak menyebutkannya. Yang lain mengarang detail yang masuk akal. Mana yang Anda dapat tergantung pada model dan pada kata-kata Anda, dan empat kebiasaan di bawah ini mendorongnya ke arah yang pertama.
Empat kebiasaan yang mengurangi jawaban karangan#
Katakan Anda menempelkan perjanjian sewa dan ingin tahu denda keterlambatannya. Perjanjian ini tidak memiliki klausul denda keterlambatan, dan ini akan menjadi kasus uji kita mulai sekarang.
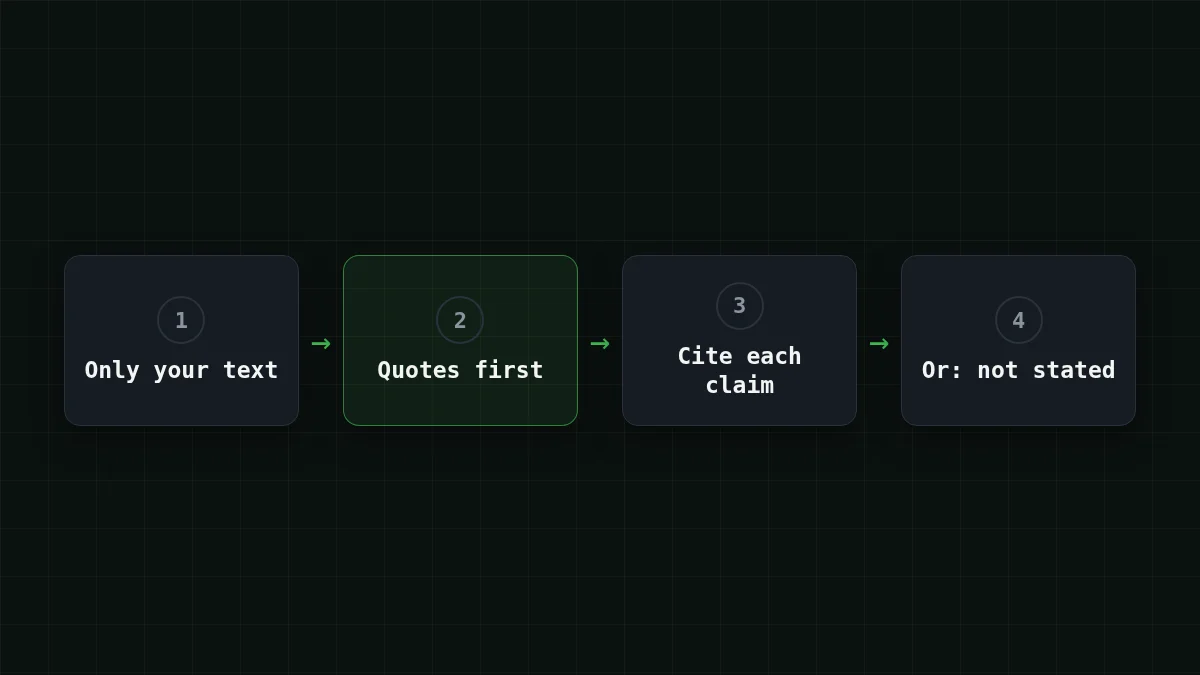
1. Izinkan "Saya tidak tahu"#
Model yang percaya setiap pertanyaan harus dijawab akan menjawabnya. Beri tahu bahwa itu bukan aturannya:
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
Anthropic mencantumkan ini sebagai langkah pertama dan paling sederhana: secara eksplisit beri model izin untuk mengakui bahwa ia tidak tahu.
2. Kutip dulu, jawab kemudian#
Untuk dokumen panjang (panduan Anthropic menarik garis pada sekitar 20.000 token, kira-kira 15.000 kata), minta kutipan kata demi kata sebelum analisis apa pun, dan buat jawaban bersandar padanya:
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
Model harus menunjuk teks yang benar-benar ada sebelum menyimpulkan apa pun. Membaca kutipan juga memakan waktu lima detik Anda.
3. Buat ia mengutip, dan buang yang tidak bisa didukungnya#
Minta kutipan pendukung setelah setiap klaim, lalu minta model memeriksa dirinya sendiri:
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
Ini adalah langkah verifikasi Anthropic: tanpa kutipan, tanpa klaim.
4. Batasi pada teks yang Anda berikan#
Use only the document between the <document> tags.
Do not use outside knowledge.
Anthropic mencantumkan pembatasan pengetahuan luar ke dokumen yang disediakan di antara teknik lanjutannya. Ini juga kebiasaan yang harus disalin jika Anda membangun bot berdasarkan dokumen Anda sendiri: bot menjawab dari halaman Anda, bukan dari memori.
Sebelum dan sesudah pada satu contoh#
Perjanjian sama, pertanyaan sama, dua prompt. Yang kiri adalah cara sebagian besar dari kita memulai.
Bandingkan
Pertanyaan sama, dua prompt
Sebelum
Here is my rental agreement:
[agreement text]

What is the late fee?
Model yang merasa harus menjawab mungkin memberi Anda angka.
Sesudah
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
Jawaban yang Anda tuju di sini: "Tidak ada kutipan relevan." lalu "Tidak dinyatakan dalam dokumen."
Prompt "sesudah" lebih panjang, dan itu tidak masalah: Anda menulisnya sekali dan menggunakannya kembali.
Keempat kebiasaan dalam satu permintaan API#
Jika Anda memanggil model melalui API, kebiasaan-kebiasaan itu masuk ke pesan sistem dan dokumen Anda masuk ke pesan pengguna, dibungkus dengan tag. Permintaan ini menggunakan endpoint kompatibel OpenAI dari CheapTokens; kuncinya berasal dari variabel lingkungan, dan id model lengkapnya adalah MiniMaxAI/ (ambil id dari dokumentasi CheapTokens, karena nama berbeda antar penyedia).
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
Balasannya ada di choices[0].. Jika ini panggilan pertama Anda, Permintaan API pertama Anda dengan CheapTokens memandu langkah kunci dan saldo langkah demi langkah.
Berapa biaya mengutip#
Mengutip membuat jawaban lebih panjang, dan pada sebagian besar model jawaban adalah sisi yang lebih mahal dari sebuah permintaan (lihat token input vs output). Kebiasaan mengutip dulu karena itu murah untuk dibiayai tetapi tidak gratis.
Katakanlah laporan 40 halaman sekitar 25.000 token dan kutipan plus jawabannya sekitar 1.500. Satu permintaan seperti itu pada MiniMax-M2.7 berbiaya $0.0015. Tabel menunjukkan permintaan yang sama pada setiap model, dengan kolom OpenRouter, sehingga Anda dapat membandingkan secara total, dengan input dan output dihitung bersama:
| Model | Input $/1Jt | Output $/1Jt | Biaya | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
Total 25.000 token input dan 1.500 token output. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
MiniMax-M2.7 menerima konteks 180K dan hingga 8.192 token dalam jawaban dengan satu harga tetap pada jam berapa pun, sehingga laporan 25.000 token dan jawaban kutipan yang panjang keduanya muat. Harga saat ini ada di halaman harga, dan model-modelnya dijelaskan di dokumentasi.
Apa yang tidak diperbaiki oleh kebiasaan ini#
Kebiasaan ini sangat mengurangi jawaban karangan, tetapi tidak menghilangkannya. Anthropic mengatakan itu secara langsung: periksa apa pun yang penting. Dalam kontrak, itu berarti angka, tanggal, dan nama, terhadap halaman aslinya.
Dua trik lagi dari halaman yang sama patut diketahui. Best-of-N: ajukan pertanyaan yang sama beberapa kali dan bandingkan, karena detail yang berubah dari satu percobaan ke percobaan lain adalah tanda model sedang menebak. Permintaan yang identik bisa kembali sebagai balasan yang identik, jadi ubah sedikit kata-katanya atau temperature-nya (lihat system prompt dan temperature). Dan mode berpikir memungkinkan model memeriksa penalarannya sendiri sebelum menjawab, yang memakan token ekstra (mengapa berpikir lebih mahal).
Daftar periksa
Sebelum Anda mempercayai jawaban yang dibangun dari dokumen Anda


