KI für EinsteigerAnleitung
Warum KI Dinge erfindet und 4 Prompt-Gewohnheiten, die das reduzieren
Was KI-Halluzinationen sind, warum ein Modell sicher klingt und falsch liegt, und vier Copy-Paste-Prompt-Gewohnheiten mit einem Vorher/Nachher-Beispiel für Ihre eigenen Dokumente.
Auf dieser Seite
- Warum ein Modell sicher klingt, wenn es falsch liegt
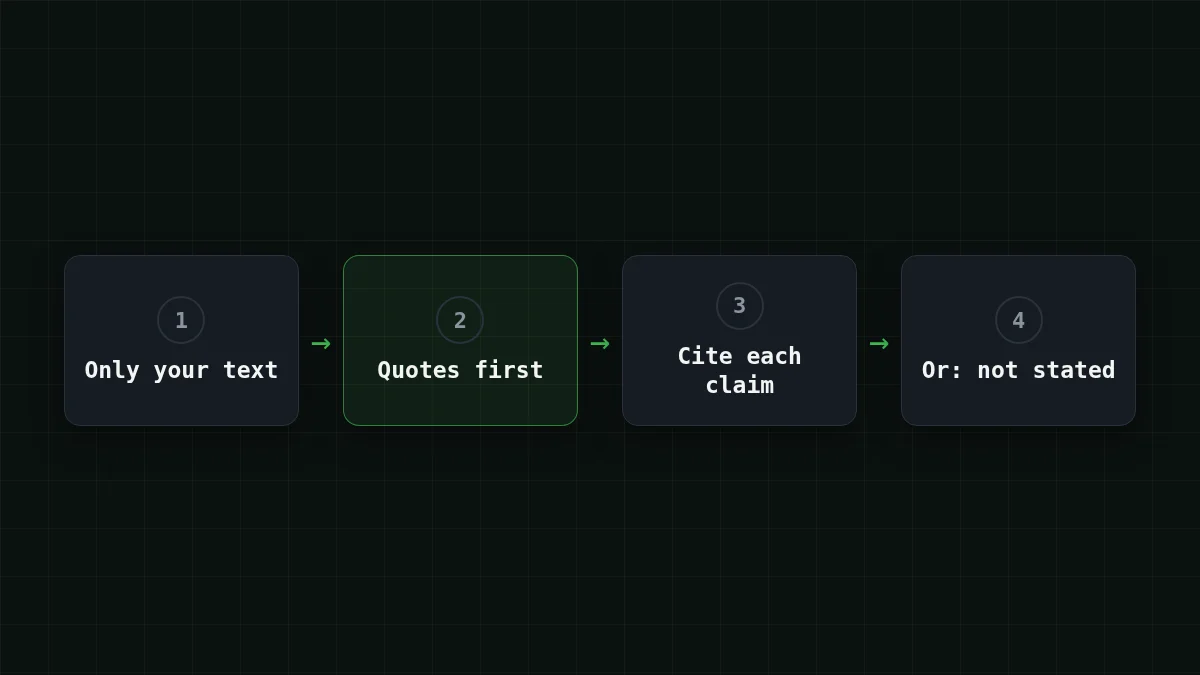
- Vier Gewohnheiten, die erfundene Antworten reduzieren
- 1. Erlauben Sie "Ich weiß es nicht"
- 2. Erst zitieren, dann antworten
- 3. Lassen Sie es zitieren und streichen, was es nicht belegen kann
- 4. Beschränken Sie es auf den Text, den Sie ihm gegeben haben
- Vorher und nachher an einem Beispiel
- Alle vier Gewohnheiten in einer API-Anfrage
- Was Zitieren kostet
- Was diese Gewohnheiten nicht beheben
Ihr Mietvertrag enthält keine Klausel zu Verzugsgebühren. Sie fragen einen Chatbot, wie hoch die Verzugsgebühr ist, und manchmal antwortet er mit einem Prozentsatz und einem Fälligkeitsdatum. Selbstsicher, konkret und erfunden.
Das ist eine Halluzination: Das Modell schreibt flüssigen Text, der sachlich falsch ist oder nicht zum Kontext passt, den Sie ihm gegeben haben. Anthropics Dokumentation zur Reduzierung von Halluzinationen (Seite geprüft am 27. Oktober 2026; sie trägt kein Veröffentlichungsdatum) sagt, dass selbst die fortschrittlichsten Modelle das manchmal tun, und sie listet die Gewohnheiten auf, die helfen. Vier davon passen in einen Prompt, und Sie können sie unverändert unten einfügen.
Warum ein Modell sicher klingt, wenn es falsch liegt#
Ein Sprachmodell schlägt keine Fakten nach. Es setzt Text fort: Angesichts von allem bisher Gesagten wählt es die Wörter, die am wahrscheinlichsten als Nächstes kommen. Denken Sie an die Autovervollständigung auf Ihrem Handy, nur deutlich belesener. Wenn die wahre Antwort etwas ist, das das Modell gelernt hat, decken sich die wahrscheinlichen Wörter mit den wahren. Wenn nicht, sind die wahrscheinlichen Wörter trotzdem flüssig, und flüssig klingt wie sicher.
Zwei Situationen erklären viele der erfundenen Antworten, die Ihnen begegnen werden:
- Der Fakt steckt nicht im Modell. Er ist nach dem Ende des Trainings des Modells passiert, oder er steht in Ihrem privaten Dokument, das das Modell nie gesehen hat. Fragen Sie nach den Nachrichten des letzten Monats, und Sie bekommen vielleicht eine selbstsichere Antwort, die aus älteren Mustern gebaut ist.
- Der Fakt fehlt in Ihrem Dokument, aber die Frage setzt voraus, dass er existiert. Das Modell füllt die Lücke. Stellen Sie sich einen Schüler vor, der zu jeder Prüfungsfrage etwas schreiben muss und nie eine leer lassen darf.
Probier es selbstProbieren Sie es aus: Was macht ein Modell mit einer Frage, die Ihr Text nicht beantworten kann?Antwort anzeigen
Fügen Sie einen kurzen Text in einen Chat ein (eine Speisekarte, eine Richtlinie, ein Rezept) und fragen Sie nach einem Detail, das er eindeutig nicht enthält, etwa nach dem Preis eines Gerichts, das nicht aufgeführt ist. Lesen Sie die Antwort. Manche Antworten sagen, dass der Text es nicht erwähnt. Andere erfinden ein plausibles Detail. Welche Sie bekommen, hängt vom Modell und von Ihrer Formulierung ab, und die vier Gewohnheiten unten drängen es in Richtung der ersten.
Vier Gewohnheiten, die erfundene Antworten reduzieren#
Angenommen, Sie haben einen Mietvertrag eingefügt und wollen die Verzugsgebühr wissen. Dieser Vertrag enthält keine Klausel zu Verzugsgebühren, und er wird von hier an unser Testfall sein.
1. Erlauben Sie "Ich weiß es nicht"#
Ein Modell, das glaubt, jede Frage müsse beantwortet werden, wird sie beantworten. Sagen Sie ihm, dass das nicht die Regel ist:
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
Anthropic nennt dies den ersten, einfachsten Schritt: Geben Sie dem Modell ausdrücklich die Erlaubnis zuzugeben, dass es etwas nicht weiß.
2. Erst zitieren, dann antworten#
Bei langen Dokumenten (Anthropics Leitlinie zieht die Grenze bei etwa 20.000 Tokens, grob 15.000 Wörter) verlangen Sie wörtliche Zitate vor jeder Analyse und lassen Sie die Antwort darauf beruhen:
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
Das Modell muss auf Text zeigen, der wirklich da ist, bevor es etwas schlussfolgert. Die Zitate zu lesen kostet Sie außerdem fünf Sekunden.
3. Lassen Sie es zitieren und streichen, was es nicht belegen kann#
Verlangen Sie nach jeder Aussage ein stützendes Zitat und lassen Sie das Modell sich dann selbst prüfen:
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
Das ist Anthropics Verifikationsschritt: kein Zitat, keine Aussage.
4. Beschränken Sie es auf den Text, den Sie ihm gegeben haben#
Use only the document between the <document> tags.
Do not use outside knowledge.
Anthropic nennt die Beschränkung von Außenwissen auf die bereitgestellten Dokumente unter seinen fortgeschrittenen Techniken. Es ist auch die Gewohnheit, die Sie übernehmen sollten, wenn Sie einen Bot auf Ihren eigenen Dokumenten bauen: Der Bot antwortet aus Ihren Seiten, nicht aus dem Gedächtnis.
Vorher und nachher an einem Beispiel#
Gleicher Vertrag, gleiche Frage, zwei Prompts. Der linke ist, wie die meisten von uns anfangen.
Vergleichen
Gleiche Frage, zwei Prompts
Vorher
Here is my rental agreement:
[agreement text]

What is the late fee?
Ein Modell, das das Gefühl hat, antworten zu müssen, gibt Ihnen vielleicht eine Zahl.
Nachher
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
Die Antwort, auf die Sie hier abzielen: "Keine relevanten Zitate." und dann "Nicht im Dokument genannt."
Der "Nachher"-Prompt ist länger, und das ist in Ordnung: Sie schreiben ihn einmal und verwenden ihn wieder.
Alle vier Gewohnheiten in einer API-Anfrage#
Wenn Sie ein Modell über die API aufrufen, kommen die Gewohnheiten in die Systemnachricht und Ihr Dokument in die Benutzernachricht, eingeschlossen in Tags. Diese Anfrage nutzt den OpenAI-kompatiblen Endpunkt von CheapTokens; der Schlüssel kommt aus einer Umgebungsvariable, und die vollständige Modell-ID ist MiniMaxAI/ (nehmen Sie IDs aus der CheapTokens-Dokumentation, denn die Namen unterscheiden sich zwischen Anbietern).
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
Die Antwort steht in choices[0].. Wenn dies Ihr erster Aufruf ist, führt Ihre erste API-Anfrage mit CheapTokens Schritt für Schritt durch Schlüssel und Guthaben.
Was Zitieren kostet#
Zitieren macht die Antwort länger, und bei den meisten Modellen ist die Antwort die teurere Seite einer Anfrage (siehe Input- vs. Output-Tokens). Die Gewohnheit, zuerst zu zitieren, ist also günstig zu leisten, aber nicht kostenlos.
Angenommen, ein 40-seitiger Bericht hat etwa 25.000 Tokens und die Zitate plus die Antwort kommen auf etwa 1.500. Eine solche Anfrage kostet auf MiniMax-M2.7 $0.0015. Die Tabelle zeigt dieselbe Anfrage auf jedem Modell, mit einer OpenRouter-Spalte, damit Sie insgesamt vergleichen können, mit Input und Output zusammengerechnet:
| Modell | Input $/1M | Output $/1M | Kosten | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
25.000 Input- und 1.500 Output-Tokens insgesamt. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
MiniMax-M2.7 hat einen Kontext von 180K und bis zu 8.192 Tokens in einer Antwort zu einem festen Preis zu jeder Stunde, sodass ein Bericht mit 25.000 Tokens und eine lange zitierte Antwort beide hineinpassen. Aktuelle Preise stehen auf der Preisseite, und die Modelle sind in der Dokumentation beschrieben.
Was diese Gewohnheiten nicht beheben#
Sie reduzieren erfundene Antworten stark, aber sie beseitigen sie nicht. Anthropic sagt das direkt: Prüfen Sie alles Wichtige. In einem Vertrag heißt das die Zahlen, Daten und Namen, gegen die Originalseite.
Zwei weitere Tricks von derselben Seite sind es wert, gekannt zu werden. Best-of-N: Stellen Sie dieselbe Frage ein paar Mal und vergleichen Sie, denn ein Detail, das sich von Durchlauf zu Durchlauf ändert, ist ein Zeichen dafür, dass das Modell rät. Eine identische Anfrage kann als identische Antwort zurückkommen, also ändern Sie die Formulierung ein wenig oder die Temperatur (siehe System-Prompt und Temperatur). Und ein Denkmodus lässt das Modell seine eigene Argumentation prüfen, bevor es antwortet, was zusätzliche Tokens kostet (warum Denken mehr kostet).
Checkliste
Bevor Sie einer Antwort vertrauen, die auf Ihren Dokumenten beruht


