IA pour débutantsGuide
Pourquoi l'IA invente des choses et 4 habitudes de prompt qui le réduisent
Ce que sont les hallucinations de l'IA, pourquoi un modèle semble sûr de lui et se trompe, et quatre habitudes de prompt à copier-coller avec un exemple avant/après pour vos propres documents.
Sur cette page
- Pourquoi un modèle semble sûr de lui quand il se trompe
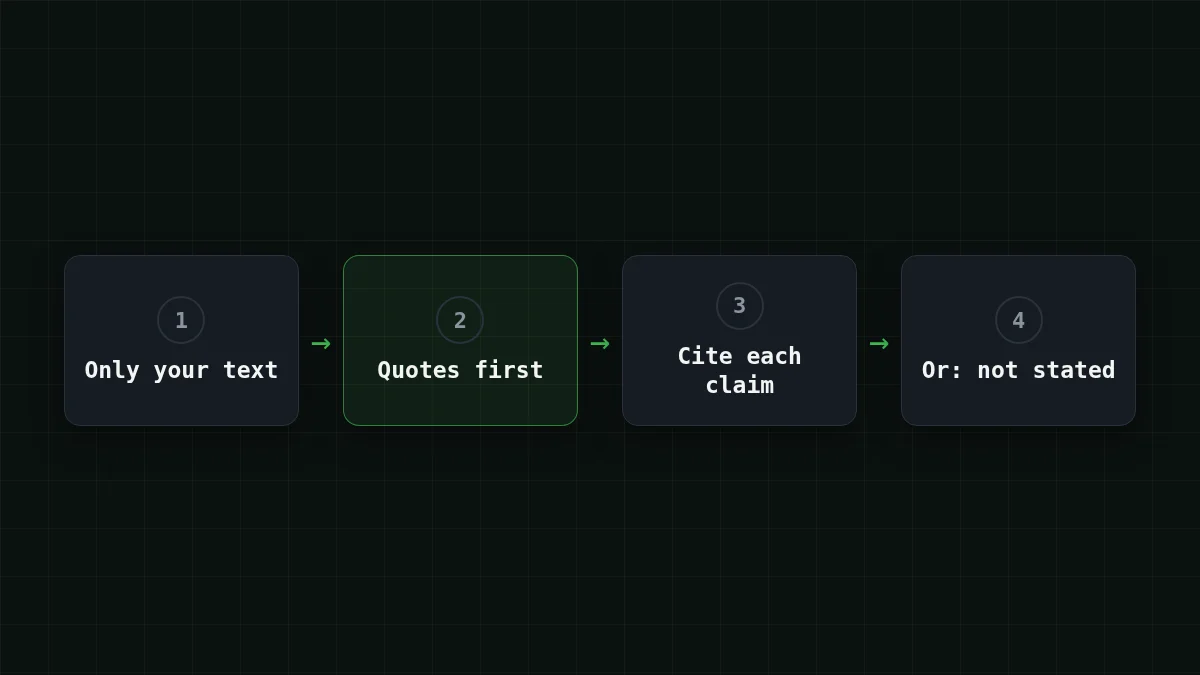
- Quatre habitudes qui réduisent les réponses inventées
- 1. Autoriser « je ne sais pas »
- 2. Citer d'abord, répondre ensuite
- 3. Faites-le citer, et écartez ce qu'il ne peut pas étayer
- 4. Le restreindre au texte que vous lui avez fourni
- Avant et après sur un même exemple
- Les quatre habitudes dans une seule requête API
- Ce que coûte la citation
- Ce que ces habitudes ne corrigent pas
Votre contrat de location ne comporte aucune clause de pénalité de retard. Vous demandez à un chatbot quel est le montant de la pénalité de retard, et parfois il répond avec un pourcentage et une date d'échéance. Assuré, précis et inventé.
C'est une hallucination : le modèle écrit un texte fluide qui est factuellement faux ou qui ne correspond pas au contexte que vous lui avez fourni. La documentation d'Anthropic sur la réduction des hallucinations (page consultée le 27 octobre 2026 ; elle ne porte aucune date de publication) indique que même les modèles les plus avancés le font parfois, et elle liste les habitudes qui aident. Quatre d'entre elles tiennent dans un prompt, et vous pouvez les coller telles quelles ci-dessous.
Pourquoi un modèle semble sûr de lui quand il se trompe#
Un modèle de langage ne consulte pas les faits. Il continue du texte : étant donné tout ce qui précède, il choisit les mots les plus probables ensuite. Pensez à l'autocomplétion de votre téléphone, en bien plus cultivé. Quand la vraie réponse fait partie de ce que le modèle a appris, les mots probables et les mots vrais coïncident. Quand ce n'est pas le cas, les mots probables restent fluides, et fluide sonne comme sûr.
Deux situations expliquent beaucoup des réponses inventées que vous rencontrerez :
- Le fait n'est pas dans le modèle. Il s'est produit après la fin de l'entraînement du modèle, ou il figure dans votre document privé que le modèle n'a jamais vu. Posez une question sur les actualités du mois dernier et vous obtiendrez peut-être une réponse assurée construite à partir de motifs plus anciens.
- Le fait manque dans votre document, mais la question suppose qu'il existe. Le modèle comble le vide. Imaginez un élève qui doit écrire quelque chose pour chaque question d'examen et n'a jamais le droit de laisser une case vide.
Essayez vous-mêmeEssayez : que fait un modèle face à une question à laquelle votre texte ne peut pas répondre ?Afficher la réponse
Collez un court texte dans un chat (un menu, une politique, une recette) et posez une question sur un détail qu'il ne contient clairement pas, comme le prix d'un plat qui n'est pas listé. Lisez la réponse. Certaines réponses indiquent que le texte n'en parle pas. D'autres inventent un détail plausible. Celle que vous obtenez dépend du modèle et de votre formulation, et les quatre habitudes ci-dessous le poussent vers la première.
Quatre habitudes qui réduisent les réponses inventées#
Supposez que vous ayez collé un contrat de location et que vous vouliez la pénalité de retard. Ce contrat ne comporte aucune clause de pénalité de retard, et ce sera notre cas de test à partir de maintenant.
1. Autoriser « je ne sais pas »#
Un modèle qui croit que toute question doit recevoir une réponse y répondra. Dites-lui que ce n'est pas la règle :
If the document doesn't say, answer exactly: "Not stated in the document."
Do not guess.
Anthropic cite cela comme la première étape, la plus simple : donner explicitement au modèle la permission d'admettre qu'il ne sait pas.
2. Citer d'abord, répondre ensuite#
Pour les documents longs (les recommandations d'Anthropic fixent la limite à environ 20 000 tokens, soit environ 15 000 mots), demandez des citations mot pour mot avant toute analyse, et faites reposer la réponse sur elles :
First, copy the sentences relevant to my question, word for word,
under the heading "Quotes". If there are none, write "No relevant quotes."
Then answer using only those quotes.
Le modèle doit pointer vers du texte réellement présent avant de conclure quoi que ce soit. Lire les citations vous prend aussi cinq secondes.
3. Faites-le citer, et écartez ce qu'il ne peut pas étayer#
Demandez une citation à l'appui après chaque affirmation, puis faites-lui vérifier lui-même :
After each claim, put the supporting quote in brackets.
Then re-read your answer: if a claim has no quote, delete it.
C'est l'étape de vérification d'Anthropic : pas de citation, pas d'affirmation.
4. Le restreindre au texte que vous lui avez fourni#
Use only the document between the <document> tags.
Do not use outside knowledge.
Anthropic classe la limitation des connaissances extérieures aux documents fournis parmi ses techniques avancées. C'est aussi l'habitude à copier si vous construisez un bot sur vos propres docs : le bot répond à partir de vos pages, pas de mémoire.
Avant et après sur un même exemple#
Même contrat, même question, deux prompts. Celui de gauche est la façon dont la plupart d'entre nous commencent.
Comparer
Même question, deux prompts
Avant
Here is my rental agreement:
[agreement text]

What is the late fee?
Un modèle qui sent qu'il doit répondre peut vous donner un chiffre.
Après
<document>
[agreement text]
</document>

Question: What is the late fee?

Use only the document above. First copy the relevant
sentences word for word under "Quotes" (or write
"No relevant quotes."). Then answer using only those
quotes, with the quote in brackets after each claim.
If the document doesn't say, answer exactly:
"Not stated in the document."
La réponse que vous visez ici : « Aucune citation pertinente. » puis « Non mentionné dans le document. »
Le prompt « après » est plus long, et c'est très bien : vous l'écrivez une fois et le réutilisez.
Les quatre habitudes dans une seule requête API#
Si vous appelez un modèle via l'API, les habitudes vont dans le message système et votre document va dans le message utilisateur, entouré de balises. Cette requête utilise le point de terminaison compatible OpenAI de CheapTokens ; la clé provient d'une variable d'environnement, et l'identifiant complet du modèle est MiniMaxAI/ (prenez les identifiants dans la documentation CheapTokens, car les noms diffèrent selon les fournisseurs).
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M2.7",
    "messages": [
      {"role": "system", "content": "Use only the document in the <document> tags. No outside knowledge. First list word-for-word quotes relevant to the question under “Quotes”, or write “No relevant quotes.” Then answer using only those quotes, with the quote in brackets after each claim. If the document does not say, answer: “Not stated in the document.”"},
      {"role": "user", "content": "<document>[paste the agreement here]</document> What is the late fee?"}
    ]
  }'
La réponse est dans choices[0].. Si c'est votre premier appel, Votre première requête API avec CheapTokens détaille la clé et l'étape de solde pas à pas.
Ce que coûte la citation#
Citer allonge la réponse, et sur la plupart des modèles la réponse est le côté le plus cher d'une requête (voir tokens d'entrée vs de sortie). L'habitude de citer d'abord est donc peu coûteuse à s'offrir, mais pas gratuite.
Disons qu'un rapport de 40 pages fait environ 25 000 tokens et que les citations plus la réponse atteignent environ 1 500. Une telle requête sur MiniMax-M2.7 coûte $0.0015. Le tableau montre la même requête sur chaque modèle, avec une colonne OpenRouter, pour que vous puissiez comparer au total, entrée et sortie comptées ensemble :
| Modèle | Entrée $/1M | Sortie $/1M | Coût | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.00096 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.002 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.0177 |
25 000 tokens d'entrée et 1 500 tokens de sortie au total. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
MiniMax-M2.7 accepte un contexte de 180K et jusqu'à 8 192 tokens dans une réponse à un prix fixe à toute heure, donc un rapport de 25 000 tokens et une longue réponse citée tiennent tous les deux. Les prix actuels sont sur la page de tarifs, et les modèles sont décrits dans la documentation.
Ce que ces habitudes ne corrigent pas#
Elles réduisent beaucoup les réponses inventées, mais ne les éliminent pas. Anthropic le dit directement : vérifiez tout ce qui est important. Dans un contrat, cela signifie les chiffres, les dates et les noms, par rapport à la page originale.
Deux autres astuces de la même page valent la peine d'être connues. Le best-of-N : posez la même question plusieurs fois et comparez, car un détail qui change d'une exécution à l'autre est le signe que le modèle devine. Une requête identique peut revenir avec une réponse identique, alors changez un peu la formulation ou la température (voir prompt système et température). Et un mode réflexion permet au modèle de vérifier son propre raisonnement avant de répondre, ce qui coûte des tokens supplémentaires (pourquoi la réflexion coûte plus cher).
Liste de contrôle
Avant de faire confiance à une réponse construite sur vos documents


